평범한 사업가YOUTUBE SUMMARIES · 2026-10-03 · 평범한 사업가🎬 영상
제미나이 4 아르곤은 강한 성적표를 보였지만 실제 도입은 업무별 검증과 접근 조건 확인이 먼저다.
아르곤의 성적표보다 중요한 것은 내 업무에서 결과·수정 시간·최종 비용을 검증하는 일이다.
01핵심 개요
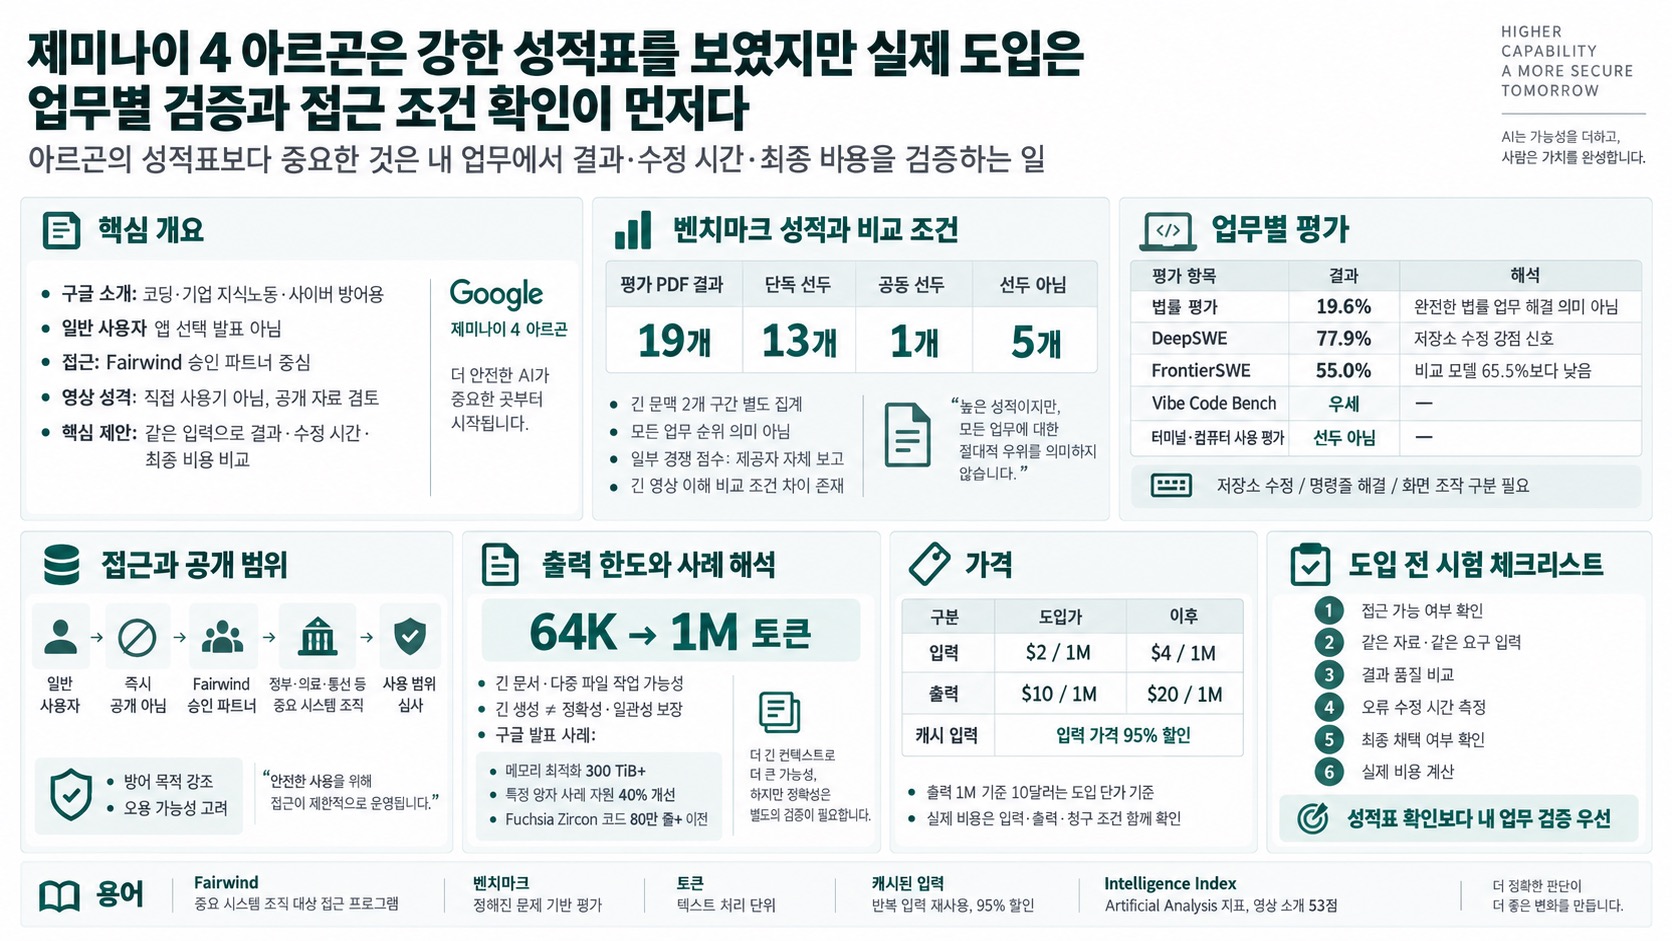
- 구글은 Gemini 4 Argon을 코딩·기업 지식노동·사이버 방어용으로 소개했으며, 일반 사용자의 앱 선택 가능 발표는 아니다.
- 현재 접근은 Fairwind 승인 파트너로 제한되며 정부·의료·통신 등 중요 시스템 조직과 사용 범위를 심사한다.
- 평가 PDF 19개 결과 행에서 단독 선두 13개·공동 선두 1개였지만, 긴 문맥 구간을 각각 센 집계로 모든 업무의 순위는 아니다.
- 공식 출력 한도는 64K에서 1M 토큰으로 늘었고, 도입가는 입력 2달러·출력 10달러, 이후 각각 4달러·20달러다.
- 영상은 직접 사용기가 아니라 공개 자료 검토이며, 같은 입력으로 결과·수정 시간·최종 비용을 비교하라고 제안한다.
02핵심 주장 / 논점 구조
- 아르곤의 벤치마크 성적은 강점의 단서지만, 점수 하나가 실제 업무 성과나 전문 검토의 필요성을 보장하지는 않는다.
- 발표된 모델 능력과 내가 사용하는 서비스의 접근 가능 여부는 다르므로, 도구를 바꾸기 전에 사용 경로부터 확인해야 한다.
- 영상은 직접 써 본 후기가 아니라 공개 자료를 검토해 이후 시험할 기준을 세우는 리뷰다.
03Fairwind 접근과 공개 범위
- 현재 접근이 열린 곳은 Fairwind 프로그램의 승인된 파트너이며, 일반 사용자가 Gemini 앱에서 바로 고를 수 있다는 발표는 아니다.
- Fairwind는 정부·의료·통신 등 중요 시스템을 지키는 조직을 설명하며 접근 대상과 사용 범위를 심사한다.
- 사이버 방어 능력은 취약점 발견과 수정에 유용할 수 있지만 오용 가능성도 있어, 승인 파트너와 방어 목적을 강조한다.
04벤치마크 성적과 비교 조건
- 평가 PDF의 19개 결과 행에서 아르곤은 단독 선두 13개, 공동 선두 1개, 선두가 아닌 행 5개로 집계됐다.
- 긴 문맥의 두 구간을 각각 센 결과이며, 모든 모델과 모든 업무를 포괄하는 순위로 해석할 수 없다.
- 일부 경쟁 점수는 제공자 자체 보고이며, 긴 영상 이해는 제미나이에 초당 한 프레임, 다른 모델에는 정해진 프레임 수를 썼다.
05업무별 코딩·전문 작업 평가
- 금융 조사·법률 자료·업무 자동화 평가에서도 높은 점수를 제시했지만, 법률 평가의 19.6%는 완전한 법률 업무 해결을 뜻하지 않는다.
- DeepSWE는 77.9%였지만 FrontierSWE는 55%로 비교 모델의 65.5%보다 낮아, 같은 코딩 분야 안에서도 결과가 달랐다.
- Vibe Code Bench에서는 앞섰으나 터미널·컴퓨터 사용 평가에서는 앞서지 못했다. 저장소 수정, 명령줄 문제 해결, 화면 조작을 구분해 봐야 한다.
06출력 한도와 구글 사례의 해석
- 구글은 출력 한도를 64K에서 1M 토큰으로 늘렸다고 설명했지만, 토큰은 글자나 단어 수와 같지 않고 입력과 출력도 구별해야 한다.
- 긴 문서 묶음이나 여러 파일 작업에 활용될 가능성은 있지만, 긴 생성만으로 정확성·일관성·검토 부담이 해결되지는 않는다.
- 구글은 메모리 최적화로 300 TiB 이상 확보, 특정 양자 사례의 자원 40% 개선, Fuchsia Zircon 코드 80만 줄 이상 이전 등을 발표했다.
07가격과 실제 도입 전 시험
- 도입가는 입력 백만 토큰당 2달러, 출력은 10달러이며 이후 각각 4달러와 20달러다. 캐시 입력은 입력 가격에서 95% 할인된다.
- 출력 백만 토큰에 도입 단가를 적용하면 출력분은 10달러지만, 입력 비용과 다른 청구 조건은 포함하지 않은 계산이다.
- 같은 자료와 요구를 주고 결과뿐 아니라 오류 수정 시간, 최종 채택 여부와 실제 비용까지 비교해야 성적표와 내 업무의 차이를 확인할 수 있다.
08용어 사전
| 용어 | 뜻 |
|---|
| Fairwind | 중요 시스템을 지키는 조직에 먼저 접근을 제공하며, 파트너와 사용 범위를 심사하는 구글 프로그램이다. |
| 벤치마크 | 정해진 문제를 모델에 풀게 하고 점수를 매기는 평가로, 시험과 조건에 따라 결과가 달라질 수 있다. |
| 토큰 | 모델이 텍스트를 처리하는 단위로, 1M 토큰이 100만 글자나 100만 단어를 뜻하지는 않는다. |
| 캐시된 입력 | 반복 입력을 재사용하는 방식이며, 영상에 제시된 가격표에서는 입력 가격의 95% 할인이 적용된다. |
| Intelligence Index | Artificial Analysis가 아르곤 페이지에 표시한 평가 지표로, 영상에서는 53점으로 소개됐다. |