AI응용4
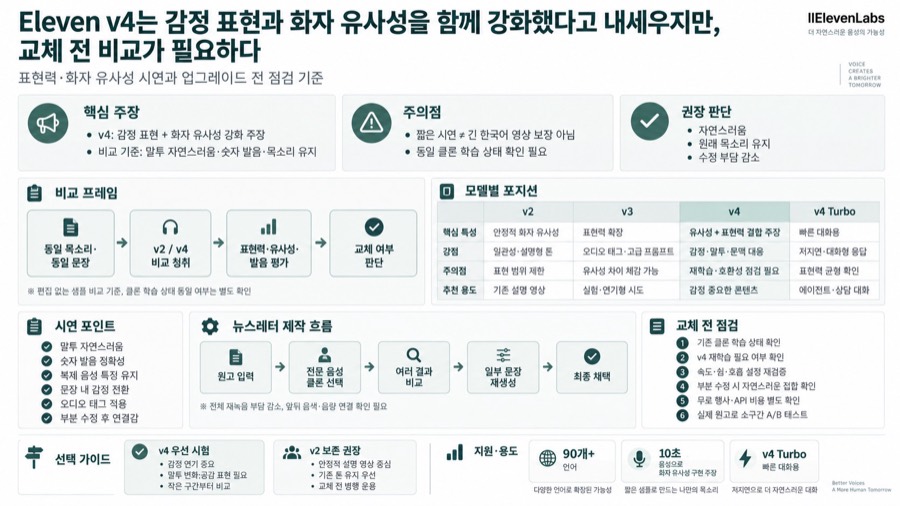
Eleven v4는 감정 표현과 화자 유사성을 함께 강화했다고 내세우지만, 교체 전 비교가 필요하다.
- ElevenLabs는 Eleven v4를 감정·말투 표현과 복제 음성의 특징 유지력을 함께 높인 모델로 소개한다.
- 영상은 Multilingual v2와 v4를 같은 목소리·문장으로 비교하며 말투, 숫자 발음, 화자 유사성을 살핀다.
- 비교 샘플은 프롬프트로 생성하고 편집하지 않았다고 설명하지만, 두 클론의 학습 상태가 같다고 확인되진 않았다.
- 뉴스레터 제작 사례에서는 음성 선택, 결과물 비교, 일부 문장 재생성으로 녹음·수정 부담을 줄이는 흐름을 보여준다.
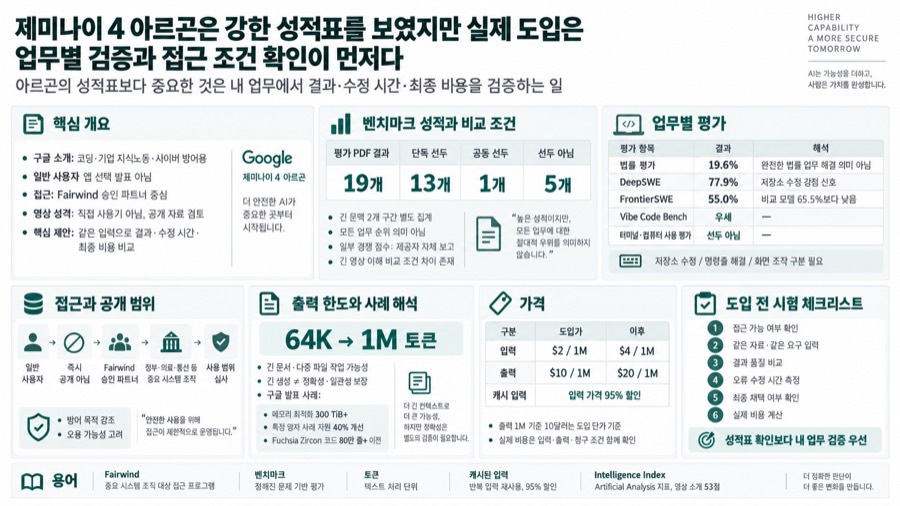
제미나이 4 아르곤은 강한 성적표를 보였지만 실제 도입은 업무별 검증과 접근 조건 확인이 먼저다.
- 구글은 Gemini 4 Argon을 코딩·기업 지식노동·사이버 방어용으로 소개했으며, 일반 사용자의 앱 선택 가능 발표는 아니다.
- 현재 접근은 Fairwind 승인 파트너로 제한되며 정부·의료·통신 등 중요 시스템 조직과 사용 범위를 심사한다.
- 평가 PDF 19개 결과 행에서 단독 선두 13개·공동 선두 1개였지만, 긴 문맥 구간을 각각 센 집계로 모든 업무의 순위는 아니다.
- 공식 출력 한도는 64K에서 1M 토큰으로 늘었고, 도입가는 입력 2달러·출력 10달러, 이후 각각 4달러·20달러다.
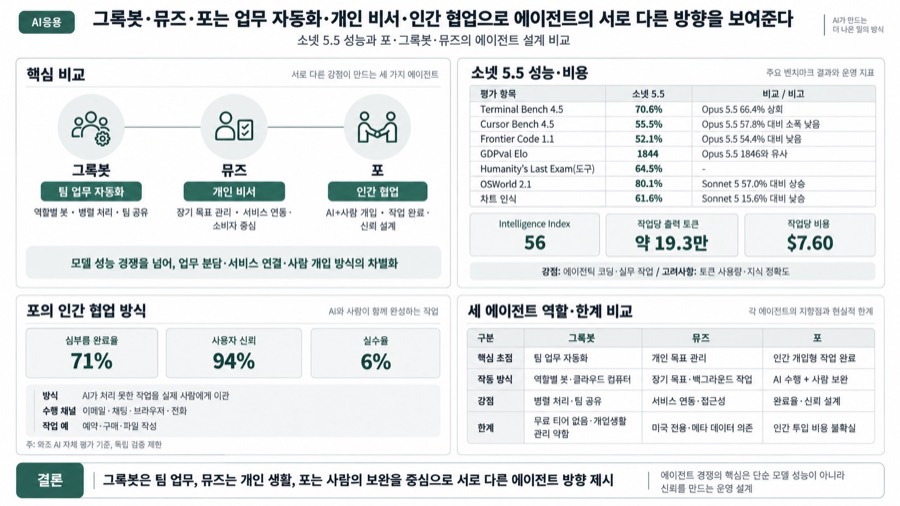
그록봇·뮤즈·포는 업무 자동화·개인 비서·인간 협업으로 에이전트의 서로 다른 방향을 보여준다.
- 영상은 클로드 소넷 5.5의 성능과 안전성, 포의 인간 협업 방식, 그록봇·뮤즈·포의 에이전트 설계를 비교한다.
- 소넷 5.5는 터미널 벤치 4.5에서 70.6%를 기록해 오푸스 5.5의 66.4%를 앞섰지만, 작업당 출력 토큰 사용량은 약 19만 3천 개였다.
- 와조 AI가 공개한 자체 평가에서 포는 심부름을 71% 완료하고 함정 테스트에서 사용자 신뢰 94%를 유지했으며, 독립검증은 제한적이라고 설명한다.
- 그록봇은 역할별 봇과 팀 공유에, 메타의 뮤즈는 개인 목표 관리와 서비스 연동에, 포는 사람이 AI의 한계를 보완하는 방식에 초점을 둔다.
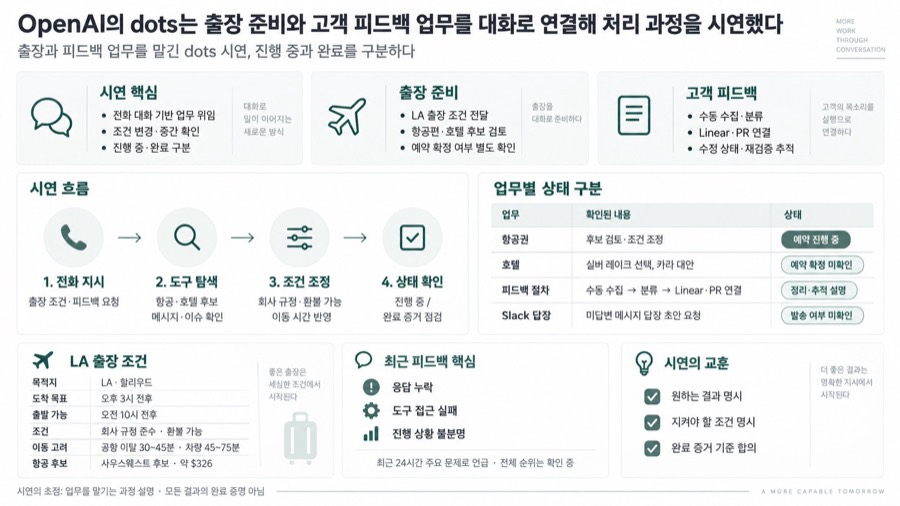
OpenAI의 dots는 출장 준비와 고객 피드백 업무를 대화로 연결해 처리 과정을 시연했다
- OpenAI dots 시연에서 사용자는 전화로 LA 출장 조건을 제시하고 항공편·호텔 후보를 확인했지만, 영상 끝까지 항공권은 예약 진행 중이었다.
- 항공편은 회사 규정과 환불 가능 여부가 조건이었고, 회의 시간에 맞춰 공항 이탈·차량 이동 시간을 고려해 더 이른 도착을 검토했다.
- 호텔은 실버 레이크 풀 앤 인과 카라가 후보로 제시됐으며, 사용자가 사진과 지도를 보고 실버 레이크를 선택했지만 예약 확정은 제시되지 않았다.
- 고객 피드백 절차는 수동 수집, 통합 목록 분류, Linear 작업·PR 연결, 수정 상태와 재검증 추적으로 설명됐고 자동 수집은 아니었다.
AI Daily · YouTube Summaries · 2026. 10. 03. (토)