Chase AIYOUTUBE SUMMARIES · 2026-09-30 · Chase AI🎬 영상
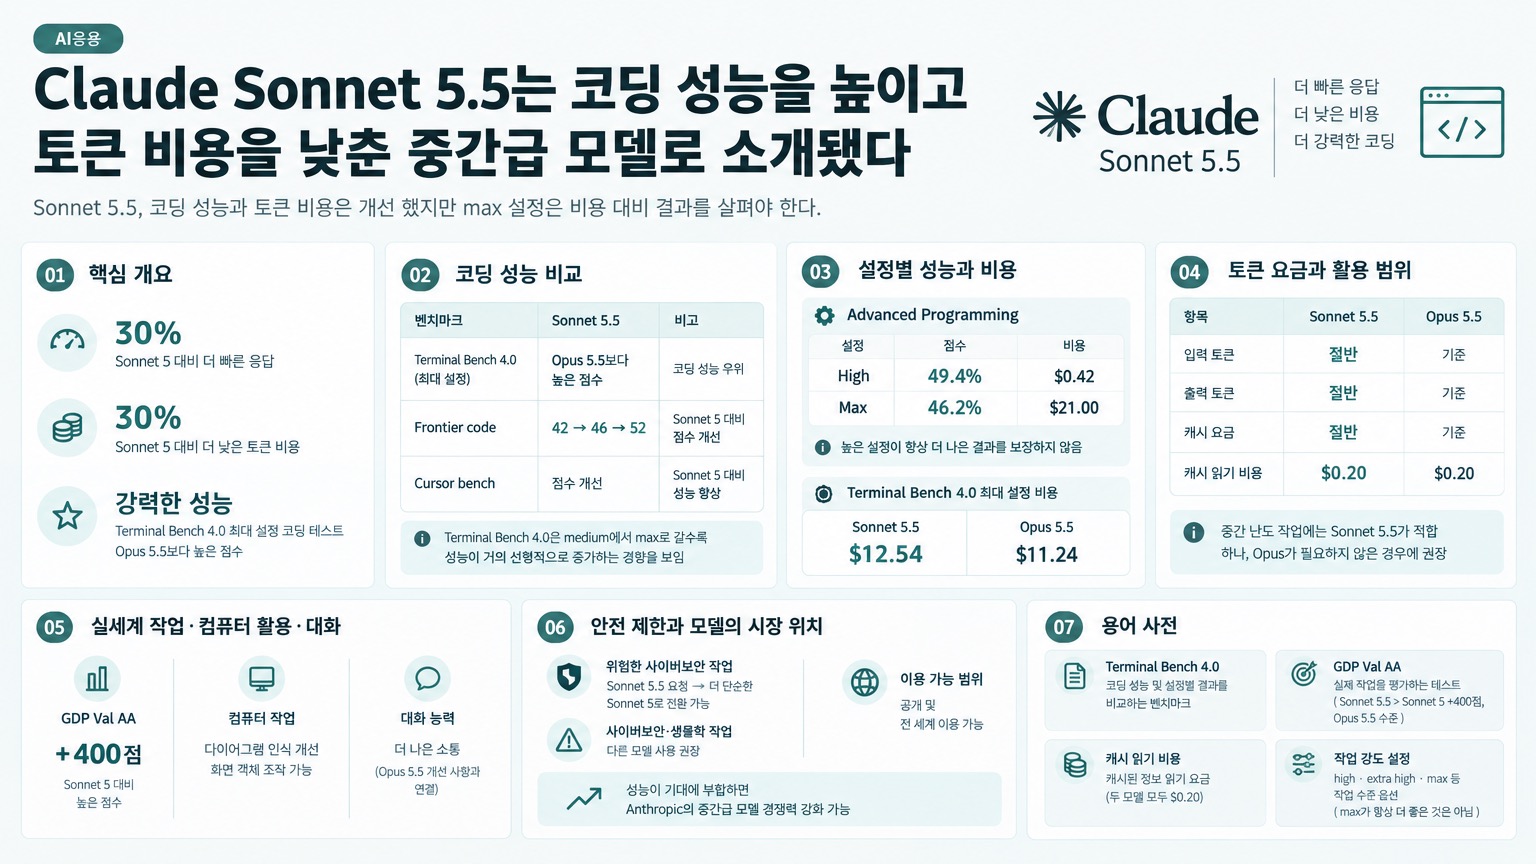
Claude Sonnet 5.5는 코딩 성능을 높이고 토큰 비용을 낮춘 중간급 모델로 소개됐다
Sonnet 5.5, 코딩 성능과 토큰 비용은 개선했지만 max 설정은 비용 대비 결과를 살펴야 한다.
01핵심 개요
- Anthropic은 Claude Sonnet 5.5가 Sonnet 5보다 30% 빠르고 30% 저렴하며 전반적으로 강력하다고 소개한다.
- Terminal Bench 4.0의 최대 설정 코딩 테스트에서 Sonnet 5.5가 Opus 5.5보다 높은 점수를 기록했다고 설명한다.
- Advanced Programming에서는 high 설정 49.4%에서 max 설정 46.2%로 점수가 하락하고 비용은 42센트에서 21달러로 늘었다.
- 입력·출력 토큰과 캐시 요금은 Opus 5.5 대비 절반이며, 캐시 읽기 비용은 두 모델 모두 20센트라고 제시한다.
- 영상은 중간 난도 작업에 Sonnet 5.5가 적합할 수 있다고 평가하며, high 또는 extra high 설정을 권한다.
02핵심 주장 / 논점 구조
- 영상은 Sonnet 5.5를 Sonnet 5의 성능·비용 문제를 개선한 중간급 모델로 소개한다.
- 벤치마크 점수뿐 아니라 작업을 끝내는 데 드는 토큰과 실제 비용을 함께 살펴봐야 한다고 강조한다.
- 전반적인 성능 향상은 긍정적으로 보면서도, max 설정의 결과와 실제 사용 효용은 신중히 판단한다.
03벤치마크에서 드러난 코딩 성능
- Terminal Bench 4.0의 최대 설정 코딩 테스트에서 Sonnet 5.5가 Opus 5.5를 앞섰다고 전한다.
- Frontier code와 Cursor bench에서도 Sonnet 5보다 점수가 개선됐다고 언급하며, Frontier code 수치로 42에서 46과 52를 제시한다.
- Terminal Bench 4.0에서는 medium에서 max로 갈수록 성능이 거의 선형적으로 증가하는 양상이 관찰됐다고 설명한다.
- 영상은 해당 결과를 인상적으로 평가하면서도 벤치마크 수치는 회의적으로 볼 필요가 있다고 덧붙인다.
04설정별 성능과 비용의 엇갈림
- Advanced Programming에서 high 설정 점수는 49.4%였지만 max 설정에서는 46.2%로 낮아졌다고 제시한다.
- 같은 테스트에서 비용은 42센트에서 21달러로 증가해, 높은 설정이 항상 더 나은 결과를 보장하지 않는다고 지적한다.
- Terminal Bench 4.0 최대 설정의 비용으로 Sonnet 5.5는 12.54달러, Opus 5.5는 11.24달러를 제시한다.
- 일상적인 사용에서는 max보다 high 또는 extra high 수준의 작업 강도를 우선 고려하라고 권한다.
05토큰 요금과 활용 범위
- Opus 5.5와 비교해 Sonnet 5.5의 입력 토큰, 출력 토큰, 캐시 요금은 절반이라고 설명한다.
- 캐시 읽기 비용은 두 모델 모두 20센트라고 제시한다.
- 영상은 비용과 테스트 결과를 종합해 Sonnet 5.5가 Opus가 필요하지 않은 중간 난도 작업에 적합하다고 평가한다.
06실세계 작업·컴퓨터 활용·대화
- GDP Val AA 테스트에서는 Sonnet 5.5가 Sonnet 5보다 400점 높고 Opus 5.5 수준의 결과를 보였다고 설명한다.
- 컴퓨터 작업과 다이어그램 인식 능력이 개선돼 시각 자료를 다루고 컴퓨터 화면의 객체를 조작할 수 있다고 소개한다.
- 대화 능력도 나아졌다는 설명을 전하며, 이는 Opus 5.5에서 개선됐던 소통 문제와 연결해 주목한다.
07안전 제한과 모델의 시장 위치
- 위험한 사이버보안 작업으로 판단되면 Sonnet 5.5 요청이 더 단순한 Sonnet 5로 전환될 수 있다고 설명한다.
- Opus 계열은 위험한 사이버보안 요청에서 Opus 4.8로 전환된다고 언급하며, 사이버보안과 생물학 작업에는 다른 모델 사용을 권한다.
- 영상은 Sonnet 5.5가 공개됐고 어디서나 이용 가능하다고 전하며, 성능이 기대에 부합하면 Anthropic의 중간급 모델 경쟁력이 커질 수 있다고 본다.
- Anthropic의 이전 Sonnet 5는 아쉬웠다고 평가하고, OpenAI의 Luna·Terra·Sol은 저렴한 일상 작업용 모델 사례로 언급한다.
08용어 사전
| 용어 | 뜻 |
|---|
| Terminal Bench 4.0 | 영상에서 Sonnet 5.5와 Opus 5.5의 코딩 성능 및 설정별 결과를 비교하는 벤치마크다. |
| GDP Val AA | 실제 작업을 평가하는 테스트로 소개되며, Sonnet 5.5가 Sonnet 5보다 400점 높고 Opus 5.5 수준이라고 설명한다. |
| 캐시 읽기 비용 | 캐시된 정보를 읽을 때의 요금으로, 영상은 Sonnet 5.5와 Opus 5.5 모두 20센트라고 제시한다. |
| 작업 강도 설정 | high·extra high·max 등 모델의 작업 수준을 정하는 옵션이며, 영상은 max가 항상 더 좋은 성능을 뜻하지는 않는다고 말한다. |