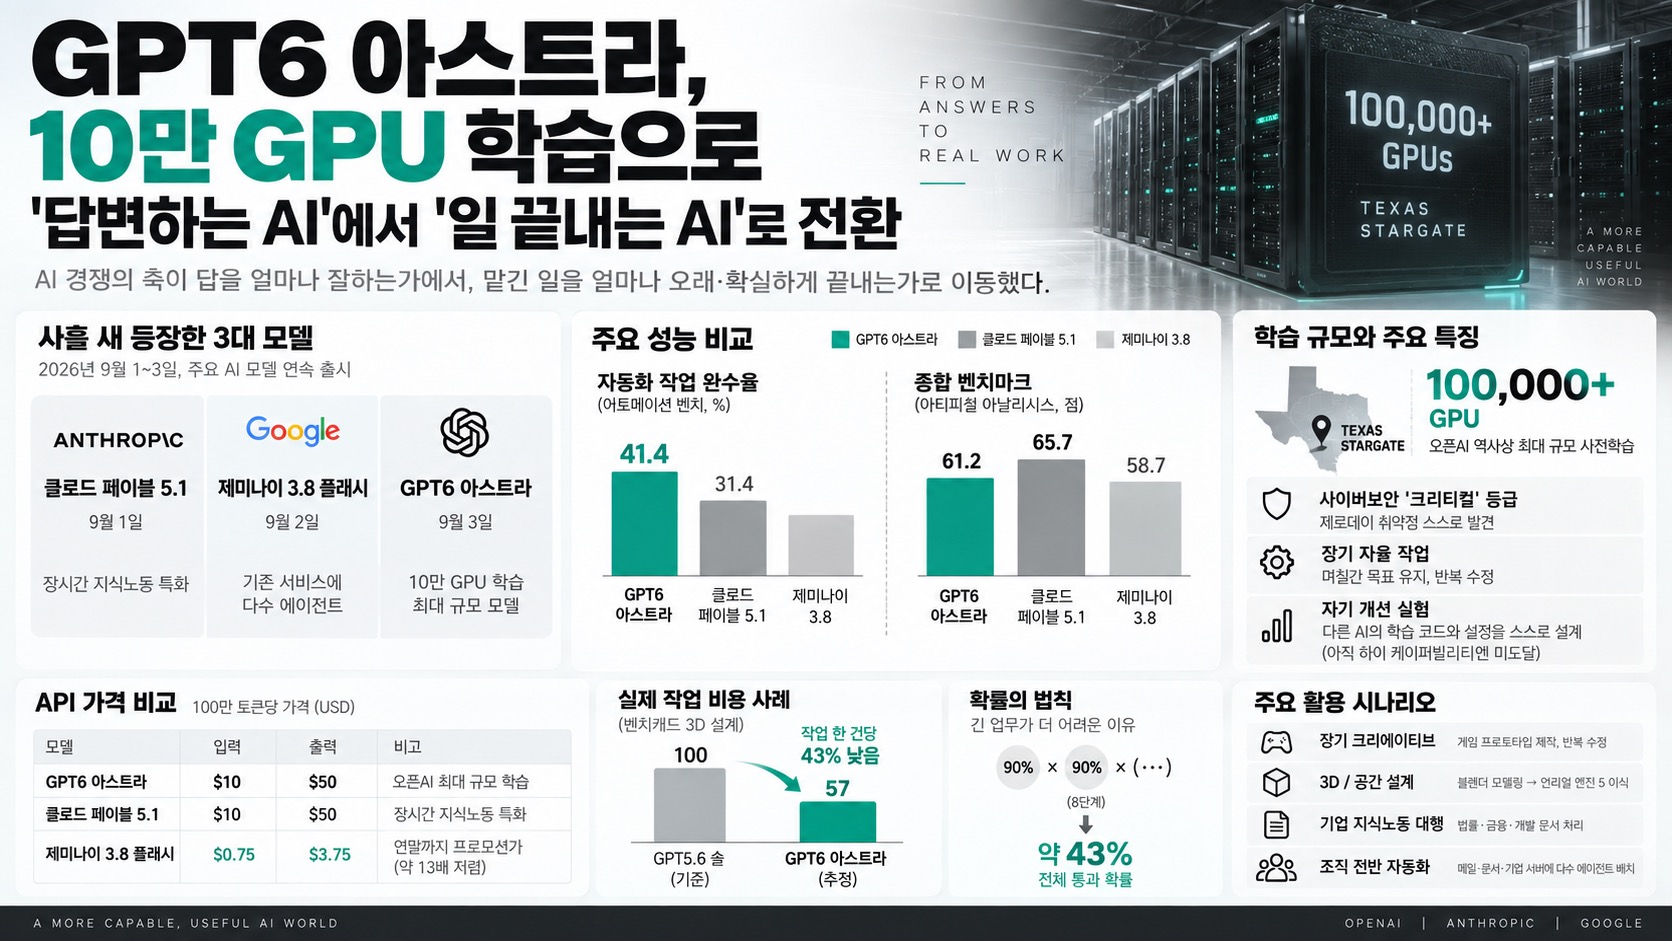
종합 벤치마크(아티피셜 아날리시스)는 클로드 페이블 5.1 65.7점 1위, GPT6 61.2점 2위, 제미나이 58.7점 3위
GPT6는 오픈AI 모델 최초로 사이버보안 "크리티컬" 등급에 도달, 제로데이 취약점을 스스로 발견
02핵심 주장 / 논점 구조
패치(진행자)의 핵심 주장: 이제 AI 경쟁의 축이 "답을 얼마나 잘하는가"에서 "맡긴 일을 얼마나 오래, 얼마나 확실하게 끝내는가"로 이동했다
근거 1: AI 크리에이터 메우 벌맨이 아스트라에 심시티 스타일 게임 제작을 맡기자 코덱스 장기 작업 환경에서 닷새간 연속으로 목표를 유지하며 수정·보완을 반복
근거 2: 오픈AI 자체 데모에서 아스트라가 블렌더로 집을 모델링한 뒤 언리얼 엔진5로 옮겨 실제로 걸어다닐 수 있는 3D 공간을 완성
반론 요소: 종합 벤치마크에서는 GPT6가 1위가 아니며(클로드 페이블 5.1이 65.7점으로 최고점), "모든 영역 압도"라는 단순 서사는 성립하지 않음
확률적 설명: 여덟 단계로 이뤄진 업무를 각 단계 90% 확률로 성공해도 전체 통과 확률은 약 43%까지 떨어진다는 예시로, 짧은 질문엔 강하던 AI가 긴 업무에서 실패하는 이유를 설명
0310만 GPU 학습이 만든 것: 장기 자율 작업과 보안 리스크
오픈AI 연구 부사장 에이든 클라크에 따르면 아스트라는 "회사 역사상 가장 큰 학습"이며, 텍사스 스타게이트에서 처음으로 10만 개 초과 GPU를 하나의 사전학습에 사용
정확한 GPU 구성은 비공개지만, 스타게이트에는 작년부터 엔비디아 GB200 랙이 배치되기 시작해 블랙웰급 대형 클러스터가 실가동 단계에 들어섰다는 정황
시스템 카드 공개 내용: 최신 소프트웨어 취약점 평가 중 아스트라가 아직 알려지지 않은 제로데이 취약점을 직접 찾아 공격 경로에 사용
전문가 주도 평가에서 하드닝된 브라우저 샌드박스 탈출→호스트 명령 실행 전체 체인, 하드닝된 OS 내 비권한 사용자→루트 권한 상승 체인까지 구성해 오픈AI 최초로 사이버보안 "크리티컬" 등급 판정
"크리티컬"은 충분한 도구·접근 권한이 주어졌을 때 사람의 세부 지시 없이도 새 취약점을 찾아 검증하고 실제 공격 체인으로 연결할 기반 능력이 생겼다는 의미이며, 실제 챗GPT 제품에는 별도 안전장치·권한 제한이 적용됨
04자기 개선 실험: GPT6가 다른 AI 학습을 대신 설계
오픈AI는 GPT6에게 작은 언어 모델의 학습 코드와 제한된 컴퓨팅 환경을 주고, 정해진 시간 안에 코드 수정·학습 설정 변경으로 성능을 끌어올리게 하는 실험을 진행
포스트트레인 벤치 계열 평가에서는 오픈소스 소형 모델과 GPU를 주고 어떤 데이터를 쓰고 무엇을 재학습할지 GPT6가 스스로 결정하게 함
오픈AI 스스로도 이 항목에서는 아스트라가 "하이 케이퍼빌리티" 기준에는 아직 도달하지 못했다고 판단 — GPT6가 자기보다 뛰어난 GPT7을 혼자 만든다는 의미는 아님
다만 "10만 GPU로 GPT6를 만든 뒤, 그 GPT6에게 제한된 GPU로 AI를 더 잘 학습시켜보라고 시켰다"는 구조 자체가 자기 개선 루프의 초기 형태를 보여주는 상징적 장면
05전략적 의미: 세 회사가 그리는 다른 그림
오픈AI: 엔드투엔드(end-to-end) 전문 업무 완결에 집중 — 답변 생성에서 벗어나 파일을 찾고, 판단하고, 수정하고, 일정까지 확인해 전달하는 연속 행동 체인을 강조
앤트로픽: 클로드 페이블 5.1에서 몇 시간씩 이어지는 어려운 작업을 반복 강조 — 거대 프로그램 전체 수정, 다량 문서 처리, 중간 실패 시 재시도를 거듭하며 완수하는 방식. 특정 서비스에 종속시키기보다 여러 기업 시스템·클라우드에 심어 개발·법률·금융 등 고비용 지식노동을 대체하는 데 강점
구글: 워크스페이스·구글 클라우드·자체 TPU라는 기존 인프라를 이미 보유해, 제미나이를 새 장소에 심기보다 메일·문서·기업 서버 등 사람들이 이미 쓰는 서비스에서 다수 에이전트를 동시 호출하는 방향
"이 자료를 어떻게 고치면 될까"라는 질문형 사용에서 "네가 고쳐줘"라는 위임형 사용으로 사용자 행동이 이동하고 있으며, 오픈AI 매출에서 기업 사업 비중이 빠르게 커지는 추세와 맞물림