Matt WolfeMORNING DIGEST · 2026-09-05 · Matt Wolfe🎬 영상
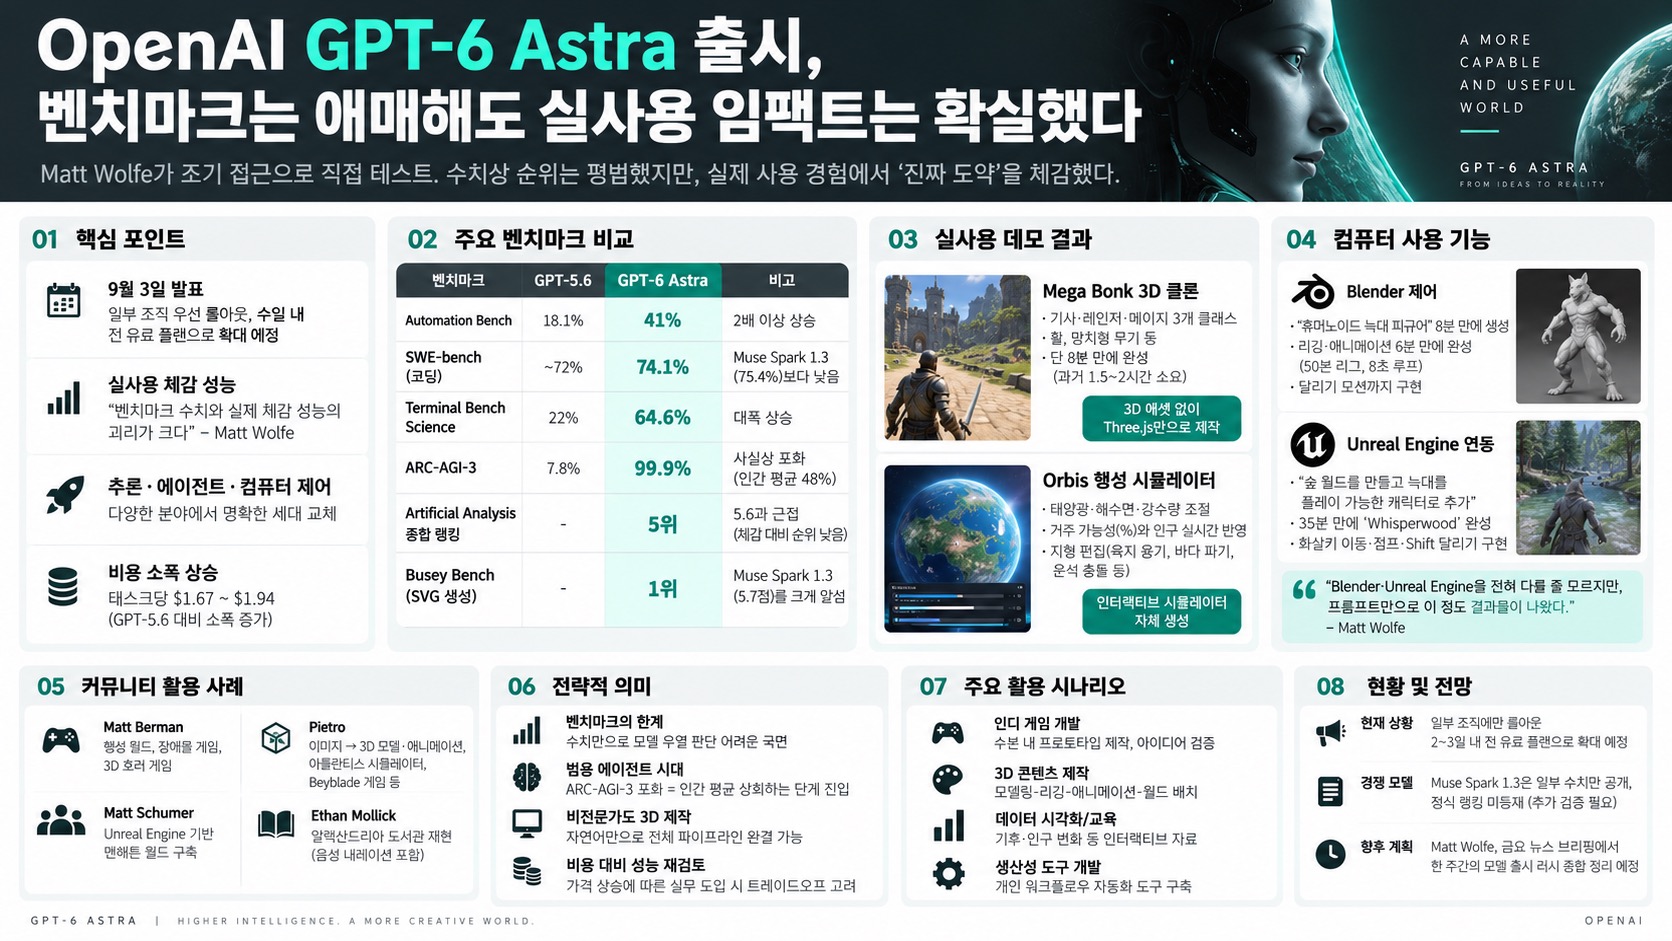
OpenAI GPT-6 Astra 출시, 벤치마크는 애매해도 실사용 임팩트는 확실했다
Matt Wolfe가 조기 접근으로 GPT-6 Astra를 직접 테스트, 벤치마크 논란 속 체감 성능은 "진짜 도약"이라 평가.
01핵심 개요
OpenAI가 9월 3일 GPT-6 Astra를 발표, 일부 조직 우선 롤아웃 후 수일 내 ChatGPT 전 유료 플랜으로 확대.
ARC-AGI-3 벤치마크 7.8%→99.9%로 사실상 포화, 인간 평균(48%)을 압도.
SWE-bench는 74.1%로 전작 대비 약 2%p 상승에 그쳐 Meta Muse Spark 1.3(75.4%)에 뒤처짐.
Busey Bench(SVG 드로잉 테스트)에서는 GPT-6이 1위, Muse Spark는 벤치마크 우위에도 실제 이미지 품질은 크게 열세.
태스크당 비용 약 $1.67~$1.94로 GPT-5.6보다 소폭 상승.
02핵심 주장 / 논점 구조
Wolfe의 핵심 논지: "벤치마크 수치와 실제 체감 성능 사이의 괴리가 크다." Artificial Analysis 종합 랭킹에서 GPT-6은 GPT-5.6과 거의 동률로 5위에 그쳤지만, 실사용 테스트에서는 5.6 대비 확연한 도약을 느꼈다고 강조.
코딩 벤치마크(SWE-bench)에서 Muse Spark 1.3에 소폭 뒤진 점을 두고 "놀랍다"고 언급하면서도, 같은 코딩 성격의 Busey Bench(SVG 생성)에서는 GPT-6이 압도적으로 앞선 상반된 결과를 근거로 벤치마크 신뢰성에 의문을 제기.
반면 ARC-AGI-3, Terminal Bench Science, GPQA, Frontier Math Tier 4 등은 대폭 상승하거나 사실상 포화 상태에 도달, "추론·에이전트형 과제"에서는 명확한 세대 교체가 있었다고 판단.
결론적으로 그는 "이 정도면 단순 뉴스 각주가 아니라 별도 영상이 필요한 수준의 도약"이라고 못 박으며, 전날 올린 "모델 출시가 너무 잦아 피로하다"는 취지의 영상과 대비되는 평가를 내놓음.
03벤치마크 상세 비교
벤치마크
이전(GPT-5.6)
GPT-6 Astra
비고
Automation Bench
18.1%
41%
2배 이상 상승
SWE-bench (코딩)
~72%
74.1%
Muse Spark 1.3(75.4%)보다 낮음
Terminal Bench Science
22%
64.6%
대폭 상승
ARC-AGI-3
7.8%
99.9%
사실상 포화, 인간 평균 48%
Artificial Analysis 종합
5.6과 근접
5위
체감 대비 순위 낮음
Busey Bench (SVG)
-
1위(AI 심사 기준)
Muse Spark 1.3(5.7점)를 크게 앞섬
04실사용 데모: 게임·시뮬레이터 제작
"Mega Bonk 3D 클론" 프롬프트 테스트: 기사·레인저·메이지 3개 클래스, 각기 다른 무기(활, 망치형 "bonk" 공격)를 갖춘 3D 게임을 단 8분 만에 완성 — 과거 모델은 동일 테스트에 1.5~2시간 소요.
"당신의 능력을 보여주는 인터랙티브 웹사이트를 만들어라" 프롬프트에서 "Orbis" 행성 시뮬레이터를 자체 생성: 태양광·해수면·강수량 슬라이더 조작 시 거주 가능성(%)과 인구(수십억 단위)가 실시간 반영되고, 지형 편집(육지 융기, 바다 파기, 운석 충돌 크레이터)까지 가능.
두 데모 모두 별도 3D 에셋 파일 없이 Three.js(3JS) 코드만으로 렌더링된 점을 Wolfe가 특히 주목.
05컴퓨터 사용(Computer Use) 기능 심층 테스트
Blender 제어: "휴머노이드 늑대 피규어를 만들어라" 한 문장 프롬프트로 8분 만에 3D 모델 생성. 이어서 "스탠드 제거 후 리깅·애니메이션" 요청 시 6분 만에 50본(bone) 리그를 추가하고 8초 루프 애니메이션까지 완성.
"달리는 동작으로 애니메이션 하라"는 추가 프롬프트에 반응해 달리기 모션을 구현(엉덩이 부분 약간의 어색함은 남음).
Unreal Engine 연동: "숲 월드를 만들고 늑대를 플레이 가능한 캐릭터로 추가하라" 프롬프트로 35분 만에 "Whisperwood"라는 숲(오솔길·연못·야생화 포함)과 플레이 가능한 늑대 캐릭터를 완성, 화살키 이동·점프·Shift 달리기까지 구현.
Wolfe 본인은 "Blender·Unreal Engine을 전혀 다룰 줄 모른다"고 밝히며, 이 정도 결과물이 프롬프트만으로 나온 것에 강한 인상을 받았다고 서술.
06커뮤니티 활용 사례
Matt Berman: Three.js 기반 행성 월드(캐릭터가 이동 가능), Fall Guys 스타일 장애물 게임, 슈팅 요소 없는 3D 호러 게임 제작.
Matt Schumer: Unreal Engine 기반 맨해튼 월드를 일주일에 걸쳐 구축. 별도 실험에서는 "월드에 인간들을 채우고 각자 Astra 기반 에이전트를 부여해 협력 생존하게 하라"는 프롬프트로, 실제로 다른 방에서 에이전트들끼리 대화하는 소리가 들릴 정도의 시뮬레이션을 구현.
Pietro: 이미지 한 장에서 3D 모델·애니메이션을 생성, 아틀란티스 해저 시뮬레이터, 플레이 가능한 Beyblade 게임, N64 "Wave Race"급(혹은 그 이상) 그래픽 게임 제작.
Ethan Mollick: "알렉산드리아 도서관"을 재현하고 음성 내레이션으로 역사적 배경을 설명하는 인터랙티브 데모 공유.
07전략적 의미
코딩 벤치마크 수치만으로 모델 우열을 가리기 어려워지는 국면 진입 — Muse Spark 1.3이 SWE-bench·Artificial Analysis에서는 앞서지만 실제 이미지/코드 생성 품질(Busey Bench)에서는 GPT-6에 크게 밀리는 역설이 드러남.
ARC-AGI-3처럼 "에이전트가 낯선 과제를 스스로 학습해 푸는 능력"을 측정하는 벤치마크가 포화 상태에 도달했다는 것은, 범용 에이전트 능력이 이미 인간 평균을 크게 상회하는 단계에 들어섰다는 신호로 해석 가능.
Computer Use(컴퓨터 제어) 기능이 Blender·Unreal Engine 같은 전문 툴 조작까지 확장되면서, 비전문가도 자연어만으로 3D 콘텐츠·게임 제작 파이프라인 전체(모델링→리깅→애니메이션→엔진 배치)를 완결할 수 있는 가능성을 보여줌.
비용 상승(태스크당 $1.67~$1.94)은 API/크레딧 소비량 증가로 이어져, 실무 도입 시 비용 대비 성능 트레이드오프를 재계산해야 하는 요인.
08활용 시나리오
인디 게임 개발자: 프롬프트 한두 줄로 캐릭터 클래스·무기 시스템을 갖춘 프로토타입 게임을 수 분 내 제작해 아이디어 검증에 활용.
3D 아티스트/모션 디자이너: Blender·Unreal Engine 미숙련자도 자연어 지시만으로 모델링-리깅-애니메이션-월드 배치 전 과정을 위임 가능.
데이터 시각화/교육 콘텐츠 제작자: "Orbis" 유형의 파라미터 기반 인터랙티브 시뮬레이터를 응용해 기후·인구 변화 등 교육용 시각 자료 제작.
생산성 도구 개발자: Wolfe가 예고한 "대시보드 오버홀" 사례처럼, 개인 워크플로우 자동화 도구를 컴퓨터 사용 기능으로 직접 구축·개선.
09현황 및 전망
영상 녹화 시점(9월 3일) 기준 GPT-6 Astra는 일부 조직에만 롤아웃, 영상 공개 후 2~3일 내 ChatGPT Plus/Pro/Business/Enterprise 전체로 확대 예정.
Muse Spark 1.3은 Deep Sue(코딩 벤치마크) 및 Meta 자체 웹사이트에는 수치가 게재됐으나 정식 랭킹 사이트에는 아직 미등재 상태로, 교차 검증이 필요한 단계.
Wolfe는 Muse Spark를 Busey Bench 외에는 아직 본격 테스트하지 못했다고 밝혀, 향후 비교 콘텐츠가 추가될 가능성을 시사.
저자는 익일 "금요 뉴스 브리핑" 영상에서 GPT-6을 포함한 한 주간의 모델 출시 러시를 종합 정리할 예정이라고 예고.
10용어 사전
GPT-6 Astra: OpenAI가 2026년 9월 3일 발표한 신세대 대형언어모델로, 추론·에이전트·컴퓨터 제어 능력이 강화됨.
Computer Use: AI가 실제 컴퓨터 화면을 인식하고 마우스·키보드를 제어해 Blender, Unreal Engine 같은 애플리케이션을 직접 조작하는 기능.
ARC-AGI-3: 에이전트가 낯선 인터랙티브 과제를 스스로 학습해 해결하는 능력을 측정하는 벤치마크.
SWE-bench(Deep Sue): 실제 소프트웨어 이슈 해결 능력을 측정하는 대표적 코딩 벤치마크.
Busey Bench: Wolfe가 자체 운영하는 벤치마크로, AI가 SVG(코드 기반 벡터 이미지)로 특정 인물을 얼마나 잘 그리는지 AI 심사로 채점.
Artificial Analysis: 여러 벤치마크 점수에 가중치를 부여해 종합 순위를 산출하는 제3자 집계 사이트.