01 핵심 개요
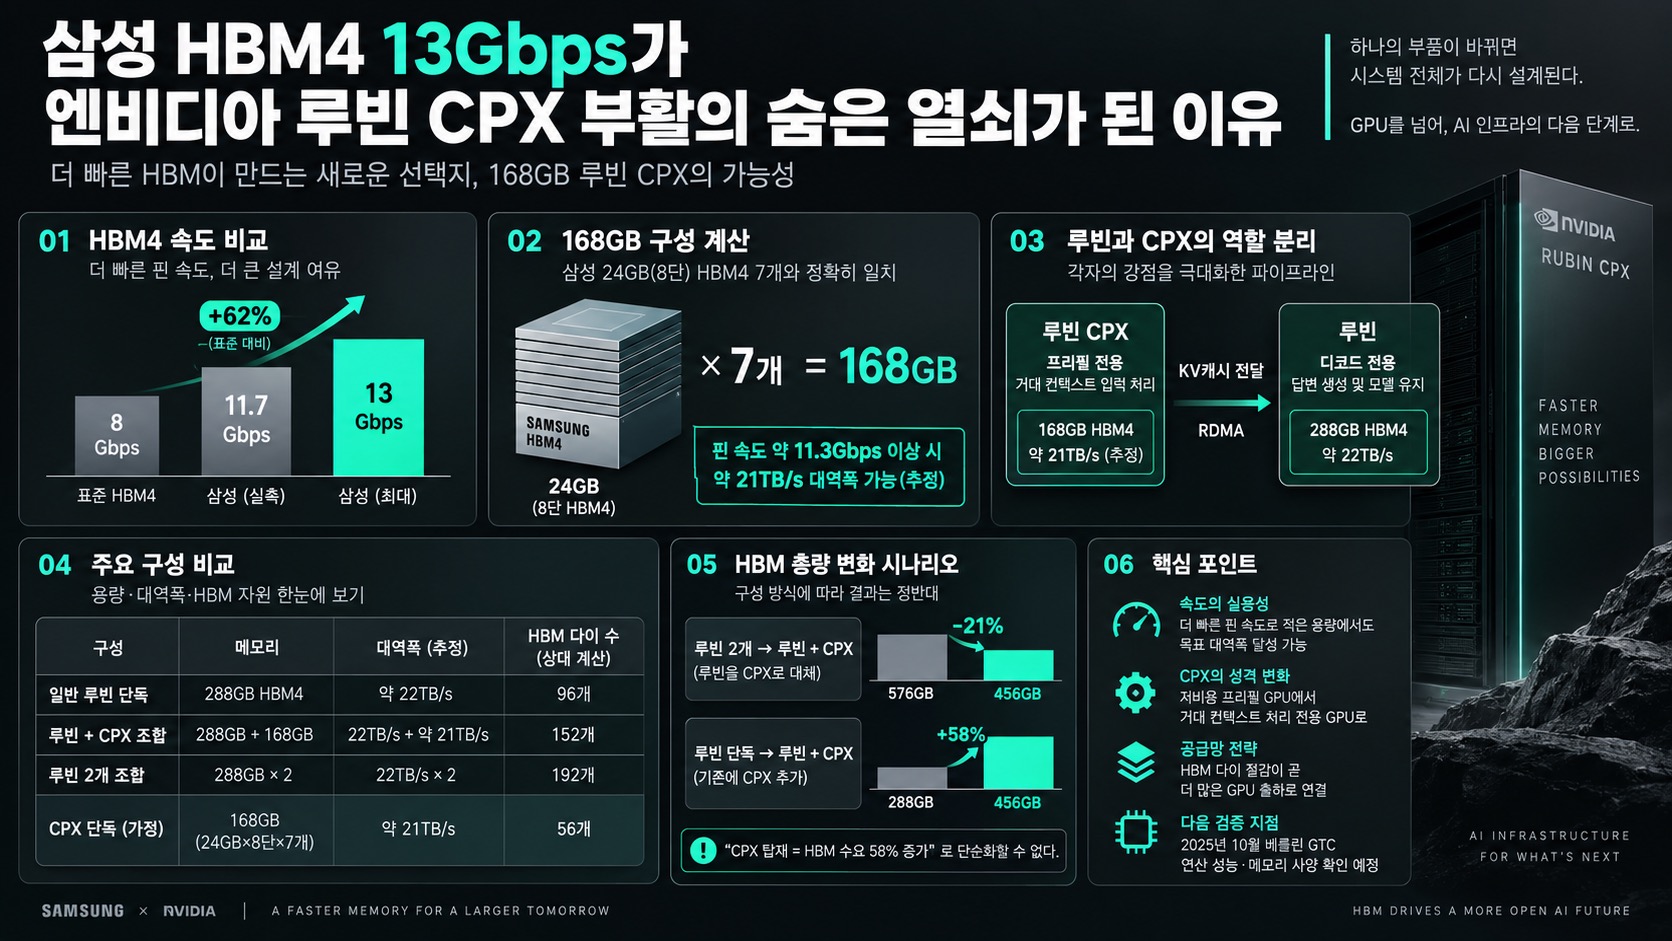
삼성전자 HBM4 최대 속도 13Gbps는 표준(8Gbps) 대비 62% 빠르며, 실측 11.7Gbps도 표준을 크게 상회한다.
밍치궈 8월 30일 보고서: 루빈 CPX 메모리가 128GB GDDR7에서 168GB HBM4로, 전력은 2,300W로 변경.
168GB는 삼성 24GB(8단) HBM4 7개 구성과 정확히 일치하는 역산 결과다.
디코드 담당 루빈(288GB, 22TB/s)과 프리필 담당 CPX(168GB, 약 21TB/s 추정)의 용량-대역폭 트레이드오프가 핵심 논점이다.
생산 목표는 2027년 1분기, 검증 시점은 10월 베를린 GTC로 예상된다.
02 핵심 주장 / 논점 구조
삼성이 HBM4 속도 경쟁에서 유독 공격적이었던 이유는 단순히 "하이닉스 추격"이 아니라, 핀 속도를 높이면 적은 용량으로도 목표 대역폭을 맞출 수 있다는 시스템 설계상의 실용성 때문이다.
핀 속도 약 11.3Gbps만 확보되면 8단 HBM4 7개(168GB)로 일반 루빈의 22TB/s급 대역폭에 근접한 21TB/s 이상을 낼 수 있다는 계산이 성립한다.
삼성의 13Gbps가 CPX를 겨냥해 설계된 것이라는 근거는 없지만, "속도로 용량 부족을 상쇄"하는 설계 여유의 실질적 가치를 보여주는 사례로 해석된다.
밍치궈 루머는 아직 엔비디아 공식 확인 전 단계이며, CPX에 삼성 HBM4가 채택된다는 근거도 현재는 없다.
03 CPX 역할 변화: 저비용 프리필 GPU에서 루빈급 연산기로
최초 CPX 컨셉(2025년 공개)은 30페타플롭스 연산기 + 저비용 128GB GDDR7 조합으로, 비싼 HBM을 배제해 프리필 비용을 낮추는 전략이었다.
새 루머대로 연산 성능이 일반 루빈에 근접하면 GDDR7의 공급 속도가 병목이 될 수 있어, HBM4 채택이 사실상 불가피해진다.
결과적으로 CPX는 "저비용 프리필 전용 GPU"에서 "거대 컨텍스트를 최대한 빨리 처리하는 전용 GPU"로 성격이 바뀐다.
에이전틱 AI(코드 저장소 읽기·검색·툴 호출·로그 재확인·서브 에이전트 호출)가 대규모 프리필 수요를 촉발한 배경으로 지목된다.
04 전략적 의미
젠슨 황은 GTC 타이베이에서 루빈 GPU, 베라 CPU, NV링크, 네트워크, HBM4, 전력·냉각을 하나로 묶은 "멀티랙 시스템"으로 설명했다. 부품 하나(HBM 속도)가 바뀌면 시스템 전체 구성을 다시 계산할 수 있다는 뜻이다.
프리필(CPX)과 디코드(루빈)의 역할을 분리하면, 하나의 루빈이 긴 프리필과 디코드를 동시에 처리하며 GPU 자원을 다투는 문제를 해소할 수 있다.
밍치궈에 따르면 CPX가 프리필과 KV캐시 생성을 맡고, KV캐시를 RDMA로 루빈에 전달하는 1대1 구성을 엔비디아가 권장한다.
HBM 공급이 빠듯해지는 2027년 시점에는 디램 다이 절감분이 곧바로 GPU 출하량 증가로 연결될 수 있다는 점에서 공급망 차원의 전략적 함의가 크다.
05 핵심 비교표구성 메모리 대역폭(추정) 디램 다이 수(상대 계산) 일반 루빈 단독 288GB HBM4 약 22TB/s 12단×8개 기준 96개 루빈+CPX(168GB) 조합 288GB+168GB=456GB 루빈 22TB/s + CPX 약 21TB/s 루빈+CPX 합산 152개 루빈 2개 조합(비교군) 288GB×2=576GB 22TB/s×2 192개 CPX 단독(가정) 168GB (24GB×8단×7개) 약 21TB/s (핀속도 11.3Gbps 이상 시) 56개
루빈을 CPX로 대체하는 구성이면 HBM 총량이 576GB→456GB로 약 21% 감소 한다.
반대로 기존 루빈 옆에 CPX를 추가하는 구성이면 HBM 총량이 288GB→456GB로 약 58% 증가한다. 두 시나리오는 결과가 정반대이므로 "CPX 탑재=HBM 수요 58% 증가"로 단순화하면 안 된다.
06 활용 시나리오
대규모 코딩 에이전트: 코드 저장소 검색·툴 호출·로그 재조회 등 반복 작업으로 컨텍스트가 커질수록 프리필 전용 CPX의 처리 속도 이점이 부각된다.
초장문 컨텍스트 처리: 수십만~수백만 토큰 입력을 어텐션 계산과 함께 처리할 때, CPX가 이를 전담하고 결과(KV캐시)만 루빈에 넘기는 파이프라인 분업이 가능하다.
메모리 제약 데이터센터: HBM 공급이 부족한 2027년경, 8단 HBM4 기반 CPX 조합으로 동일 웨이퍼 자원에서 더 많은 GPU를 만들 여지가 생긴다.
시스템 설계 관점: 특정 부품(HBM 속도)의 성능이 오르면 다른 부품(적층 수, 용량)을 낮춰 전체 균형을 재조정하는 식의 설계 유연성 확보 사례로 참고할 수 있다.
07 현황 및 전망
트렌드포스는 내년 HBM 비트 공급이 50~60% 늘어도 수요 증가를 따라잡기 어렵다고 전망한다.
엔비디아는 루빈 울트라에서도 12단 HBM4 외에 8단 HBM4, 8단 HBM4E 등 용량을 낮춘 구성을 검토 중이라고 언급했다.
현재까지 삼성전자가 CPX용 HBM을 공급한다는 확정 정보는 없다. SK하이닉스도 11.7Gbps HBM4를 공개했고 루빈 공급망에서 강한 위치를 유지 중이며, 엔비디아는 루빈용 HBM4 공급사로 삼성전자·SK하이닉스·마이크론을 모두 언급했다.
다음 검증 지점은 10월 20~22일 베를린 GTC이며, 젠슨 황이 21일 키노트를 맡는다. 현재 공식 프로그램에는 루빈 CPX나 168GB HBM4가 명시되어 있지 않아, 연산 성능(30페타플롭스 유지 여부)과 메모리 사양(128GB GDDR7 대 168GB HBM4) 변경 여부가 확인의 관건이다.
08 용어 사전
HBM4: 4세대 고대역폭 메모리로, 표준 핀 속도는 8Gbps이며 삼성전자는 최대 13Gbps까지 달성했다고 발표했다.
루빈 CPX(Rubin CPX): 엔비디아가 프리필(입력 처리) 전용으로 구상한 GPU로, 최초에는 저비용 GDDR7 메모리를 채택했다.
프리필(Prefill): AI가 입력된 긴 컨텍스트를 한 번에 처리하며 KV캐시를 생성하는 연산 단계로, 대규모 행렬 계산이 필요해 연산 성능에 민감하다.
디코드(Decode): 프리필 이후 실제 답변을 순차적으로 생성하는 단계로, 모델 가중치와 KV캐시를 오래 유지해야 하므로 메모리 용량이 중요하다.
KV캐시: 프리필 단계에서 생성되어 이후 답변 생성(디코드)에 계속 재사용되는 중간 연산 결과 캐시.
RDMA: 서버 간 CPU 개입 없이 메모리를 직접 주고받는 전송 방식으로, CPX가 만든 KV캐시를 루빈에 전달하는 데 쓰인다고 언급됐다.
VIDEO