Chase AIMORNING DIGEST · 2026-09-04 · Chase AI🎬 영상
GPT-6 Astra, 벤치마크와 비용 모두에서 Fable 5.1을 압박하며 반격에 나서다
Chase AI: OpenAI의 GPT-6 Astra는 대부분 벤치마크에서 Anthropic Fable 5.1을 앞서고, 동일 성능 대비 비용은 압도적으로 저렴하다.
01핵심 개요
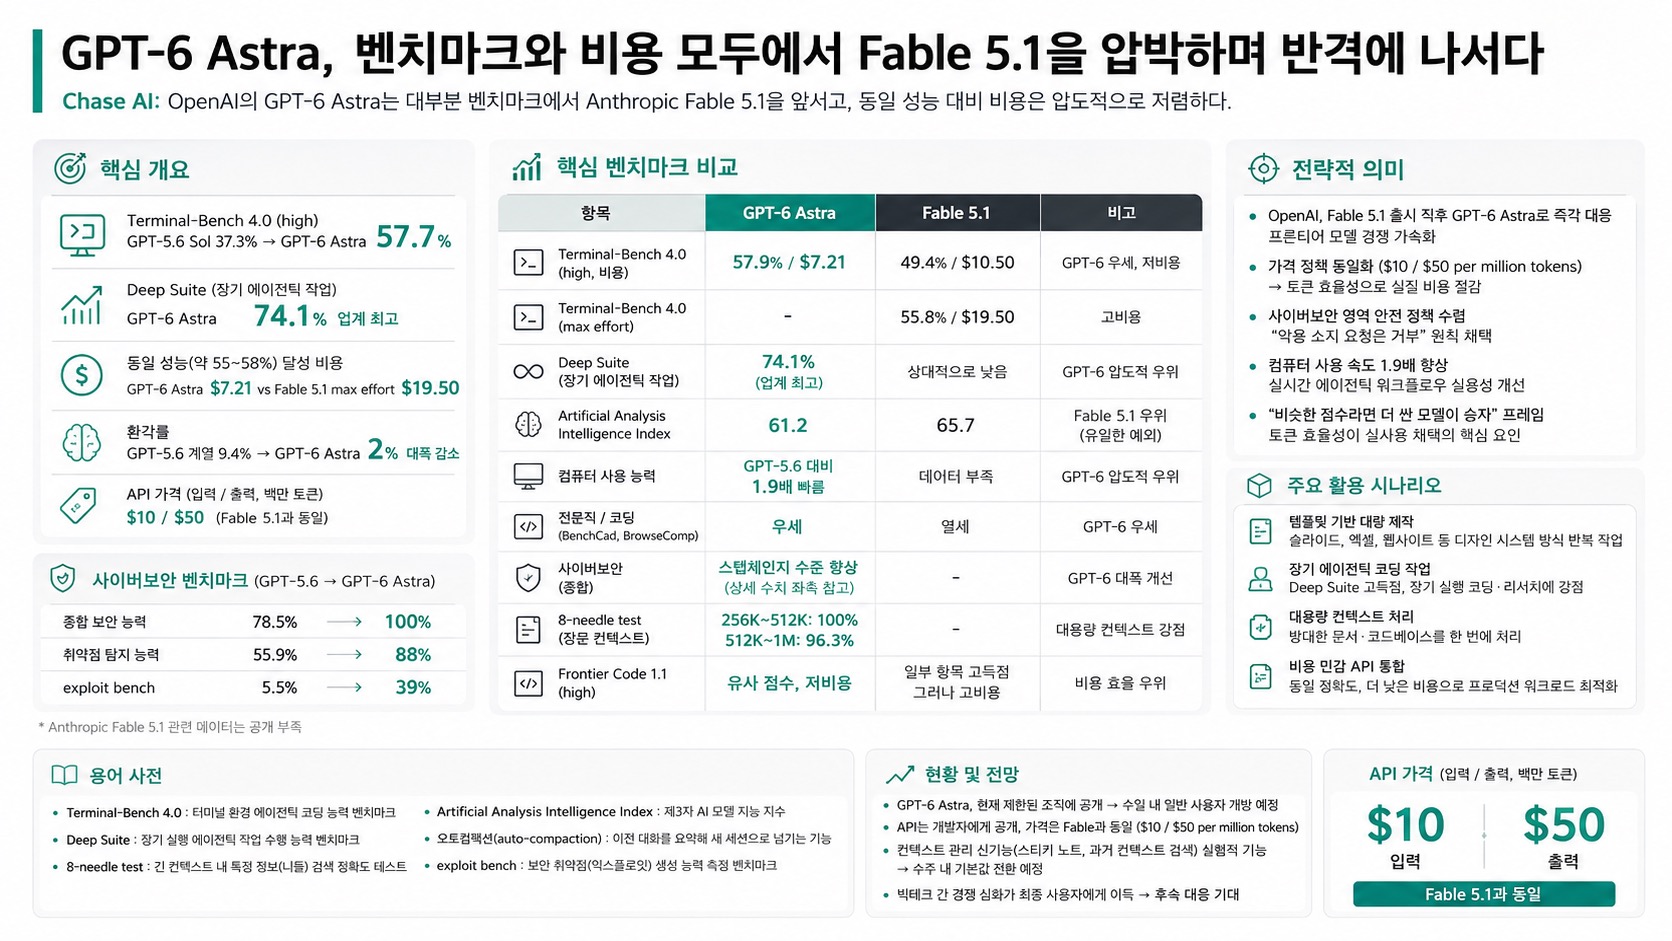
- Terminal-Bench 4.0에서 GPT-5.6 Sol 37.3% → GPT-6 Astra 57.7%로 급등.
- Deep Suite(장기 에이전틱 작업 벤치마크)에서 74.1%로 업계 최고 기록.
- 동일 성능(약 55~58%) 달성 비용: GPT-6 Astra $7.21 vs Fable 5.1 max effort $19.50.
- 환각률 GPT-5.6 계열 9.4% → GPT-6 Astra 2%로 대폭 감소.
- API 가격은 입력 $10/백만 토큰, 출력 $50/백만 토큰으로 Fable과 동일하게 책정.
02핵심 주장 / 논점 구조
- Chase AI는 "raw 벤치마크 점수만으로는 부족하다"며 점수 대비 비용(cost-per-score)을 핵심 평가축으로 제시한다.
- GPT-6 Astra는 컴퓨터 사용, 전문직 벤치마크(BenchCad, BrowseComp), 코딩, 학술, 과학·헬스, 사이버보안 등 거의 전 영역에서 Fable 5.1을 앞서거나 대등하다.
- 유일한 예외는 Artificial Analysis Intelligence Index로, GPT-6이 61.2점을 기록해 Fable 5.1의 65.7점에 못 미친다.
- 결론적으로 "비슷한 점수라면 더 싼 모델이 승자"라는 프레임으로, GPT-6 Astra의 토큰 효율성이 실사용 채택의 결정적 요인이 될 것이라 주장한다.
03벤치마크 비교
- 컴퓨터 사용: GPT-6 Astra가 압도적 우위. Fable 5.1은 관련 데이터 자체가 부족.
- 전문직/코딩: BenchCad, BrowseComp에서 GPT-6 우세. Terminal-Bench 4.0은 37.3%→57.7%로 급등, Deep Suite 74.1%로 최고점.
- 사이버보안: GPT-5.6 대비 78.5%→100%, 55.9%→88%, exploit bench 5.5%→39%로 스텝체인지 수준 향상.
- 장문 컨텍스트: 8-needle 테스트에서 256K~512K 토큰 구간 100%, 512K~1M 토큰 구간도 96.3% 유지 — 대용량 컨텍스트를 상시 활용하는 사용자에게 강점.
- 예외 지표: Artificial Analysis Intelligence Index에서만 Fable 5.1(65.7)이 GPT-6 Astra(61.2)를 앞섬.
04전략적 의미
- OpenAI는 Anthropic의 Fable 5.1 출시 직후 곧바로 GPT-6 Astra로 맞대응하며 프론티어 모델 경쟁의 속도를 끌어올렸다.
- 가격 정책을 Fable과 동일하게($10/$50 per million tokens) 맞추면서도 토큰 효율성으로 실질 비용을 낮춰, "동일 가격표, 더 낮은 실사용 비용" 전략을 구사한다.
- 사이버보안 영역에서 Anthropic과 마찬가지로 "모델이 너무 강력해 악용 소지가 있는 요청은 거부한다"는 안전 정책을 채택, 프론티어 모델 안전 기준이 업계 표준으로 수렴하는 흐름을 보여준다.
- 컴퓨터 사용 속도가 GPT-5.6 대비 1.9배 빨라지면서 Codex 음성 모드 등 실시간 에이전틱 워크플로우의 실용성이 크게 개선된다.
05핵심 워크플로우 또는 비교표
| 항목 | GPT-6 Astra | Fable 5.1 |
|---|
| Terminal-Bench 4.0 (high, 비용) | 57.9% / $7.21 | 49.4% / $10.50 |
| Terminal-Bench 4.0 (max effort) | - | 55.8% / $19.50 |
| Deep Suite | 74.1% (업계 최고) | 상대적으로 낮음 |
| Artificial Analysis Intelligence Index | 61.2 | 65.7 (Fable 우위) |
| 환각률 | 2% | GPT-5.6 계열 대비 우위 언급 없음 |
| 컴퓨터 사용 속도 | GPT-5.6 대비 1.9배 | 데이터 부족 |
| API 가격 | $10/$50 (백만 토큰) | $10/$50 (백만 토큰, 동일) |
| Frontier Code 1.1 (high) | 유사 점수, 저비용 | 일부 항목 고득점이나 고비용 |
06활용 시나리오
- 템플릿 기반 대량 제작: 슬라이드 덱, 엑셀 문서, 웹사이트 등 하나의 참조 템플릿을 주면 동일한 스타일로 다른 주제 콘텐츠를 생성하는 "디자인 시스템" 방식의 반복 작업에 적합.
- 장기 에이전틱 코딩 작업: Deep Suite 고득점이 보여주듯, 여러 세션에 걸친 장기 실행 코딩·리서치 태스크에 강점.
- 대용량 컨텍스트 처리: 방대한 문서·코드베이스를 한 번에 던져 넣고 작업해야 하는 사용자(리서치, 대규모 리팩터링)에게 유리.
- 비용 민감 API 통합: 동일 정확도를 더 낮은 비용으로 얻을 수 있어, 대량 호출이 필요한 프로덕션 워크로드에 비용 최적화 이점.
07현황 및 전망
- GPT-6 Astra는 현재 제한된 조직에만 공개된 상태이며, 수일 내 일반 사용자에게도 개방될 예정이다.
- API는 이미 개발자에게 열려 있고, 가격은 Fable과 동일한 수준으로 책정됐다.
- 컨텍스트 관리 신기능("스티키 노트" 방식의 다중 메모, 과거 컨텍스트 검색 가능)은 현재 실험적 기능으로 Codex 설정에서 수동 활성화해야 하며, 수주 내 기본값으로 전환될 예정이다.
- Chase AI는 "빅테크 간 경쟁 심화가 결국 최종 사용자에게 이득"이라며 향후 Anthropic과 OpenAI의 후속 대응을 기대한다는 입장을 밝혔다.
08용어 사전
- Terminal-Bench 4.0: 터미널 환경에서의 에이전틱 코딩 능력을 측정하는 벤치마크.
- Deep Suite: 장기 실행 에이전틱 작업 수행 능력에 초점을 맞춘 코딩 벤치마크.
- 8-needle test: 긴 컨텍스트 윈도우 내 여러 개의 특정 정보(니들)를 정확히 찾아내는지 측정하는 장문 컨텍스트 평가 방식.
- Artificial Analysis Intelligence Index: 여러 벤치마크를 종합한 제3자 AI 모델 지능 지수.
- 오토컴팩션(auto-compaction): 컨텍스트 윈도우가 가득 찼을 때 이전 대화를 요약해 새 세션으로 넘기는 기능.
- exploit bench: 모델이 보안 취약점(익스플로잇)을 생성할 수 있는 능력을 측정하는 사이버보안 벤치마크.