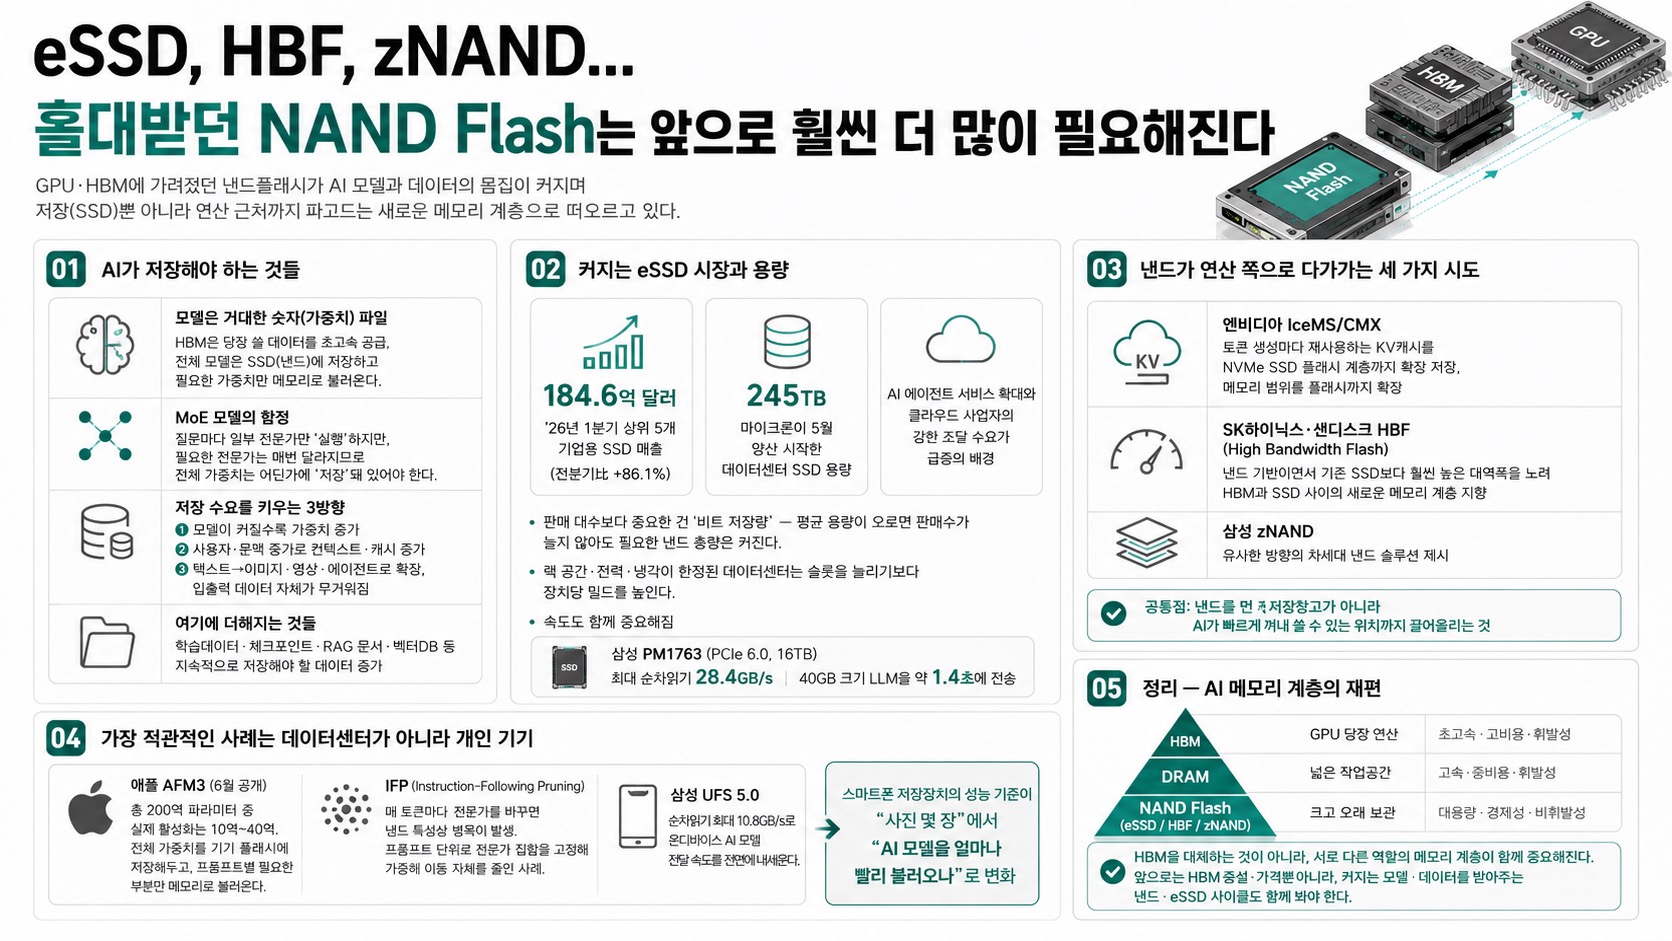
01AI가 저장해야 하는 것들
- AI 모델은 결국 거대한 숫자(가중치) 파일 — HBM은 GPU 옆에서 당장 쓸 데이터를 초고속 공급하지만 비싸고 휘발성이라, 모델 전체는 SSD(낸드)에 저장해두고 필요한 가중치만 빠른 메모리로 불러온다.
- 혼합전문가(MoE) 모델의 함정: 질문마다 일부 전문가만 '실행'하지만, 어떤 전문가가 필요할지는 매번 달라지므로 전체 가중치는 어딘가에 '저장'돼 있어야 한다 — 실행 축소가 저장 축소를 의미하지 않는다.
- 저장 수요를 키우는 3방향: ①모델이 커질수록 가중치 증가 ②사용자·문맥 증가로 컨텍스트·캐시 증가 ③텍스트→이미지·영상·에이전트로 확장되며 입출력 데이터 자체가 무거워짐. 여기에 학습데이터·체크포인트·RAG 문서·벡터DB까지 더해진다.
02커지는 eSSD 시장과 용량
184.6억달러26년 1분기 상위5개 기업용 SSD 매출(전분기比 +86.1%)
245TB마이크론이 5월 양산 시작한 데이터센터 SSD 용량
- AI 에이전트 서비스 확대와 클라우드 사업자의 강한 조달 수요가 급증의 배경. 마이크론은 이 245TB 제품의 용도로 AI 데이터레이크·클라우드·대규모 오브젝트 스토리지를 제시.
- 판매 대수보다 중요한 건 '비트 저장량' — 평균 용량이 오르면 판매수가 늘지 않아도 필요한 낸드 총량은 커진다. 렉 공간·전력·냉각이 한정된 데이터센터는 슬롯을 늘리기보다 장치당 밀도를 높인다.
- 속도도 함께 중요해짐: 삼성이 7월 양산 시작한 PCIe 6.0 기반 PM1763(16TB)은 최대 초당 28.4GB 순차읽기로, 40GB 크기 LLM을 약 1.4초에 전송 가능.
03낸드가 연산 쪽으로 다가가는 세 가지 시도
- 엔비디아 IceMS/CMX: LLM이 토큰 생성마다 재사용하는 KV캐시를 NVMe SSD 플래시 계층까지 확장 저장 — 비싼 GPU 메모리에만 붙잡아두지 않고 메모리 범위를 플래시까지 넓힌다.
- SK하이닉스·샌디스크 HBF(하이 밴드위스 플래시): 낸드 기반이면서 기존 SSD보다 훨씬 높은 대역폭을 노려 HBM과 SSD 사이 새 메모리 계층을 만드는 접근. 삼성도 'zNAND'로 유사한 방향 제시.
- 공통점: 낸드를 먼 저장창고가 아니라 AI가 빠르게 꺼내 쓸 수 있는 위치까지 끌어올리는 것.
04가장 직관적인 사례는 데이터센터가 아니라 개인 기기
- 애플 AFM3(6월 공개): 코어 어드밴스드 모델은 총 200억 파라미터 중 실제 활성화는 10억~40억뿐이지만, 입력마다 필요한 전문가가 달라 전체 가중치를 기기 플래시에 저장해두고 프롬프트별로 필요한 부분만 메모리로 불러온다.
- 낸드는 D램만큼 빠르지 않아, 매 토큰마다 전문가를 바꾸면 병목이 생긴다. 애플은 IFP(Instruction-Following Pruning)로 프롬프트 단위로 전문가 집합을 고정해 가중치 이동 자체를 줄였다 — 낸드 특성에 맞춰 모델 동작 방식을 바꾼 사례.
- 삼성 UFS 5.0도 순차읽기 최대 10.8GB/s로 온디바이스 AI 모델 전달 속도를 전면에 내세운다. 스마트폰 저장장치의 성능 기준이 "사진 몇 장"에서 "AI 모델을 얼마나 빨리 불러오나"로 바뀌고 있다.
05정리 — AI 메모리 계층의 재편
- GPU 당장 연산 = HBM, 넓은 작업공간 = D램, 크고 오래 보관 = 낸드 — 낸드가 HBM을 대체하는 게 아니라 서로 다른 역할의 메모리 계층 자체가 중요해지는 것.
- 앞으로 AI 메모리를 볼 때는 HBM 증설·가격뿐 아니라, 계속 커지는 모델·데이터를 받아주는 낸드·기업용 SSD 사이클도 함께 봐야 한다.