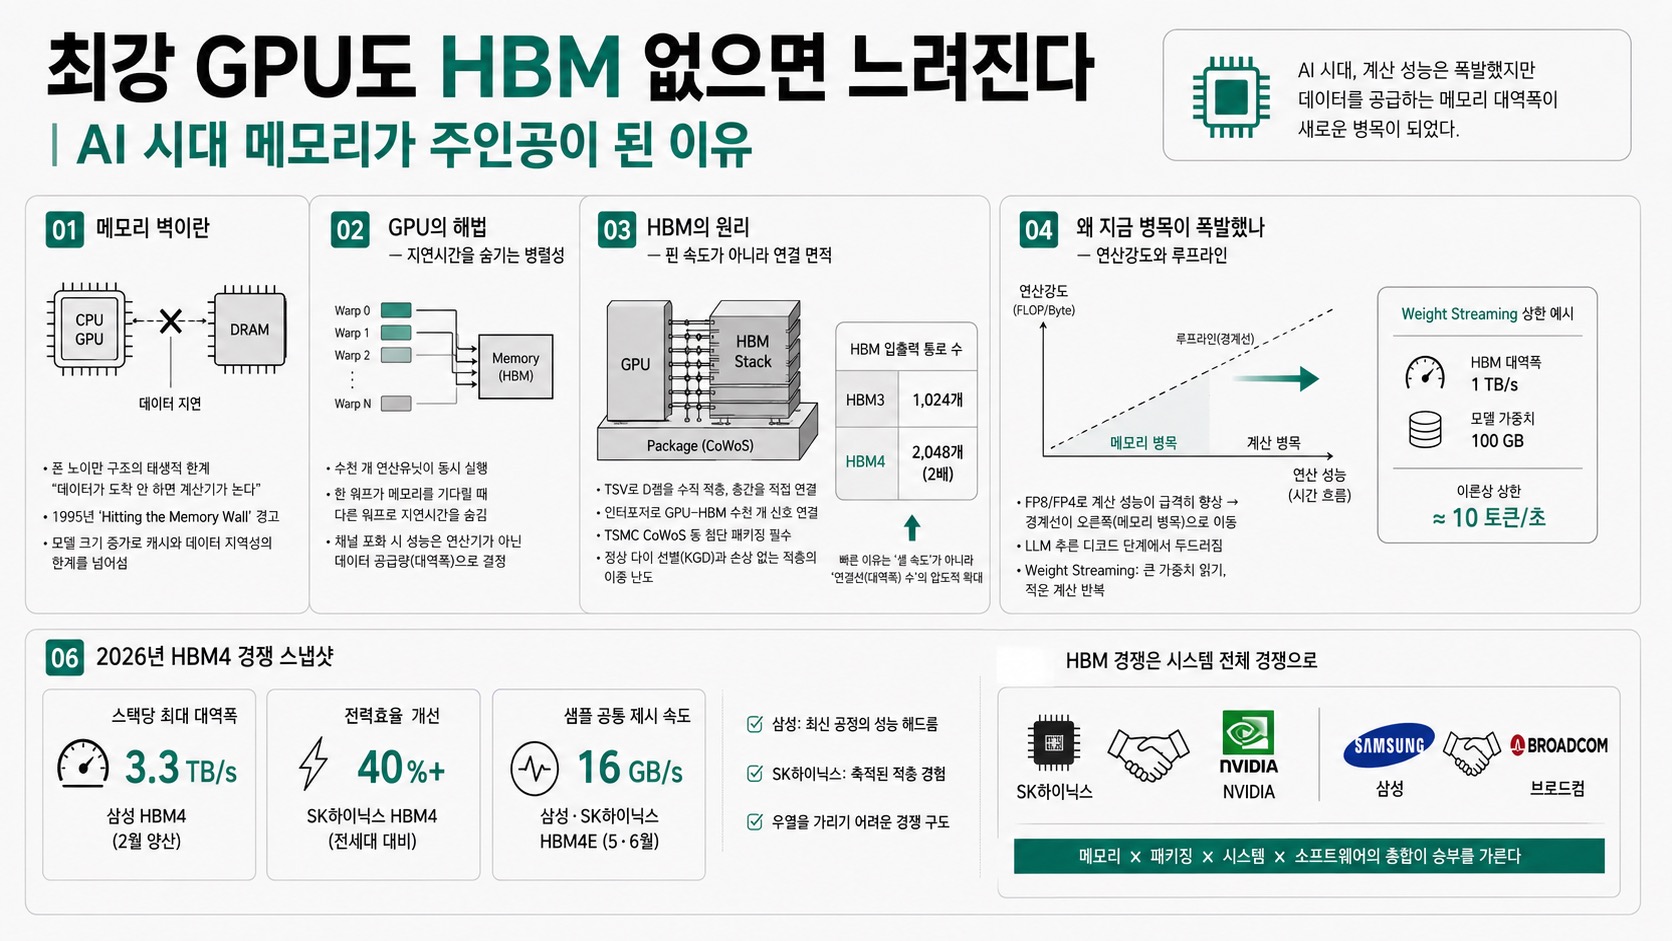
01메모리 벽이란
- 계산장치(CPU/GPU)와 저장장치(D램)가 분리된 폰 노이만 구조는 태생적으로 "데이터가 도착 안 하면 계산기가 논다"는 약점을 가진다 — 1995년 논문 'Hitting the Memory Wall'에서 이미 경고된 문제.
- 기존엔 캐시(L1~L3)와 데이터 지역성(locality)으로 이 벽을 숨겨왔지만, 수백GB에 달하는 AI 모델 가중치는 온칩 캐시에 담을 수 없고 재사용 패턴도 캐시 감당 범위를 넘어선다.
02GPU의 해법 — 지연시간을 숨기는 병렬성
- GPU는 수천 개 연산유닛이 동시에 도는 만큼 데이터 공급 통로(대역폭)도 함께 넓어야 한다. 한 워프가 메모리를 기다리는 동안 다른 워프를 실행해 지연시간을 숨기지만, 메모리 채널 자체가 포화되면 성능은 계산기 수가 아니라 데이터 공급량으로 결정된다.
03HBM의 원리 — 핀 속도가 아니라 연결 면적
1024개HBM3 입출력 통로 수
2048개HBM4 입출력 통로 수(2배)
- HBM이 빠른 이유는 셀 하나하나가 빨라서가 아니라 GPU 바로 옆에 압도적으로 많은 연결선을 만들어 한꺼번에 데이터를 보내기 때문 — TSV(실리콘관통전극)로 디램을 수직으로 쌓아 층간을 직접 연결.
- GPU-HBM 사이 수천 개 신호를 잇는 인터포저, 이를 패키징하는 TSMC 코워스(CoWoS) 등 첨단 패키징 능력이 부족하면 GPU·HBM이 준비돼도 완제품이 나올 수 없다.
- HBM 제조는 정상 다이(KGD) 선별과 손상 없는 적층이라는 이중 난도의 싸움 — 적층 정렬이 어긋나거나 접점 일부만 붙지 않아도 전체 스택이 불량 처리된다.
04왜 지금 병목이 폭발했나 — 연산강도와 루프라인
- 연산강도(1바이트당 계산 횟수)가 낮으면 메모리 대역폭이 병목이 된다. AI칩이 FP8/FP4 저정밀 연산으로 계산 성능을 급격히 높이면서, 루프라인 모델의 경계가 오른쪽(메모리 병목 쪽)으로 이동 — 예전엔 계산이 병목이던 작업이 이제 메모리에 먼저 막힌다.
- 특히 LLM 추론의 디코드 단계(토큰 생성)에서 두드러진다 — 배치가 작으면 가중치 재사용률이 낮아 매번 거대한 가중치를 읽고 적은 계산만 하는 'weight streaming' 현상 발생. HBM 대역폭 1TB/s, 가중치 100GB 가정 시 이론상 초당 약 10토큰이 상한.
05계층화되는 AI 메모리
- 최신 시스템은 HBM 외에도 CPU 쪽 소캠(SOCAMM), CXL 메모리, SSD를 계층적으로 활용 — 엔비디아 베라 루빈도 CPU LPDDR5X와 GPU HBM4를 NVLink C2C로 연결하고 KV캐시 일부를 CPU 메모리로 옮긴다.
- HBM4에서 베이스 다이는 단순 받침대가 아니라 고객 맞춤 로직칩에 가까워짐 — 삼성은 자체 파운드리 4나노 베이스다이, SK하이닉스는 TSMC 협업 확대로 차별화.
062026년 HBM4 경쟁 스냅샷
3.3TB/s삼성 HBM4 스택당 최대 대역폭(2월 양산)
40%+SK하이닉스 HBM4 전력효율 개선(전세대 대비)
16GB/s삼성·SK하이닉스 HBM4E 샘플 공통 제시 속도(5·6월)
- 삼성은 최신 공정의 성능 헤드룸, SK하이닉스는 축적된 적층 경험을 각각 앞세우며 우열을 가리기 어려운 경쟁 구도. SK하이닉스-엔비디아, 삼성-브로드컴 협력 발표 등 HBM 경쟁은 메모리사 단독전이 아닌 시스템 전체 경쟁으로 바뀌고 있다.