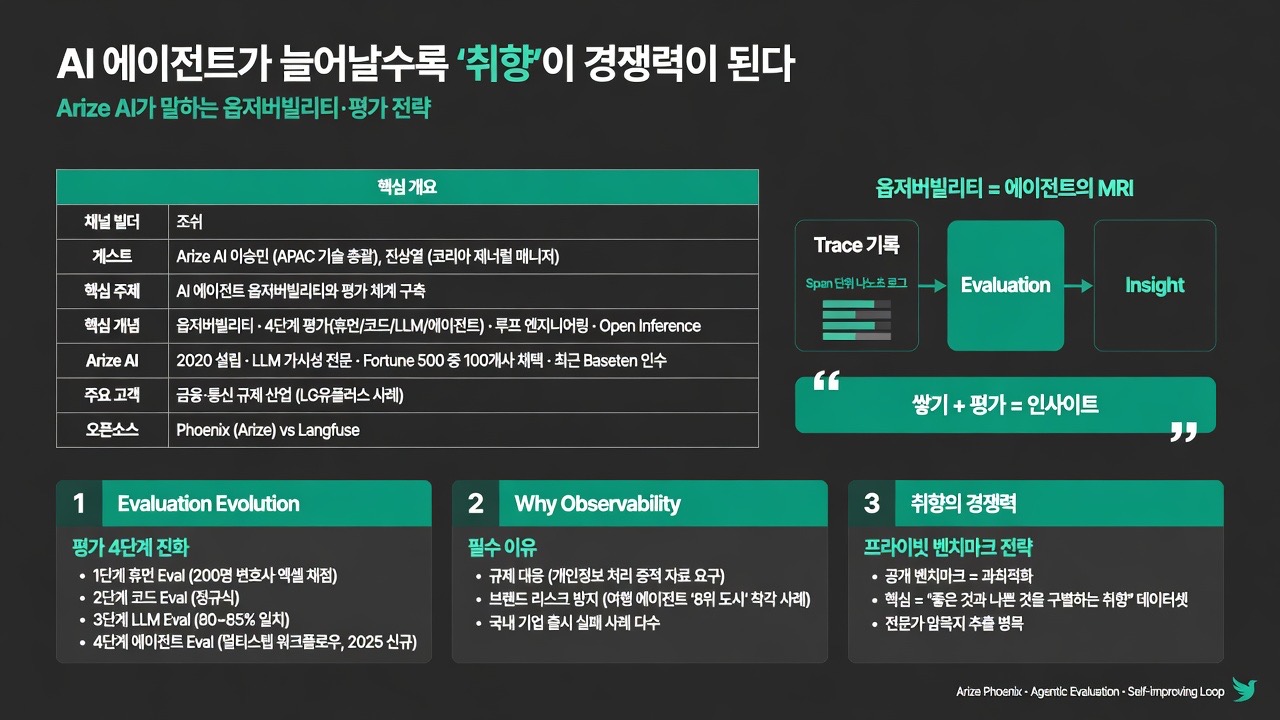
01핵심 개요 (표)
| 항목 | 내용 |
|---|---|
| 채널 | 빌더 조쉬 Builder Josh |
| 게스트 | Arize AI 이승민(APAC 기술 총괄), 진상열(코리아 제너럴 매니저) |
| 핵심 주제 | AI 에이전트 옵저버빌리티(관측성)와 평가(evaluation) 체계 구축, 프라이빗 벤치마크·데이터셋 전략 |
| 핵심 개념 | 옵저버빌리티, 4단계 평가(휴먼/코드/LLM/에이전트 이벨), 루프 엔지니어링(셀프 임프루빙), 오픈 인퍼런스(Open Inference) 규격 |
| 화자 배경 | 이승민: 톰슨로이터 AI랩(법률 AI 웨스트로) 4년 → AWS 전문가서비스팀 → 2025년 6월 Arize AI APAC 총괄 합류(APAC 1호 직원) |
| 화자 배경 | 진상열: 보안 엔지니어 출신 → SI 미국 법인 → 아마존 리테일 → 카카오모빌리티 → AWS(이승민과 같은 팀) → Arize AI 코리아 GM |
| 회사 개요 | Arize AI는 2020년 설립된 AI/LLM 가시성(observability) 전문 스타트업, 포춘500 중 100개 기업이 채택. 최근 바이너리스(Baseten)에 인수 소식 |
| 주요 고객군 | 금융·통신사 등 1% 오류도 허용 안 되는 규제 산업, 국내 사례로 LG유플러스 공개 |
| 오픈소스 도구 | Arize의 오픈소스 트레이싱 툴 '피닉스(Phoenix)', 경쟁 오픈소스로 한국에서 유명한 '랭퓨즈(Langfuse)' 언급 |
02핵심 기능/내용 구조
- 옵저버빌리티는 "에이전트의 MRI" — Arize AI는 스스로를 "사람이 아니라 AI 에이전트를 찍는 엑스레이·MRI 회사"로 소개한다. ChatGPT를 쓸 때 내부에서 무슨 일이 일어나는지 알 수 없듯, 기업이 만든 에이전트도 내부 동작을 모르면 왜 잘못된 답변이 나왔는지 분석할 수 없다는 문제의식에서 출발했다. 옵저버빌리티는 "쌓기(트레이스 기록) + 평가(evaluation) = 인사이트"라는 단순한 공식으로 요약되며, 에이전트의 모든 행동을 최소 단위인 '스팬(span)' 수준까지 쪼개 나노초 단위로 기록한다 (10:53).
- 왜 옵저버빌리티가 필수인가 — 규제 대응과 브랜드 리스크 방지 — 금융·의료·국방처럼 1% 오류도 허용되지 않는 규제 산업은 감독 당국이 "개인정보 처리를 어떻게 하고 있냐"고 물으면 증적 자료로 답해야 한다. 국내에서도 관련 가이드라인이 작년 말 나와 올해부터 강제성을 띠기 시작했고, 실제로 옵저버빌리티 부재로 심사에 탈락해 에이전트 서비스를 준비해놓고도 출시하지 못한 국내 기업 사례가 언급됐다. 또 다른 예로, 여행 에이전트가 프랑스의 '8위(도시명)'와 미국의 동명 도시를 착각해 항공권을 잘못 예약하면 브랜드 신뢰를 잃고 경쟁사에 고객을 뺏길 수 있다는 시나리오도 제시됐다 (14:20).
- 평가(eval)는 2단계에서 4단계로 진화했다 — 2018~2022년에는 사람이 직접 채점하는 '휴먼 이벨'(예: 법률 AI 시절 변호사 200명에게 엑셀로 채점받은 사례)과 정규식 기반 '코드 이벨' 두 가지뿐이었다. 2022년 ChatGPT 등장 이후 LLM이 채점하는 'LLM 이벨'이 3번째로 등장했고, 사람 평가와 80~85% 정도 일치하지만 나머지 15~20% 격차, 특히 도메인 전문 지식을 온전히 반영하지 못하는 한계가 있다(LG유플러스 사례로 확인). 이 한계를 넘기 위해 올해부터 Arize가 출시한 4번째 방식이 '에이전트 이벨'로, 단순 LLM 호출 1회가 아니라 복잡한 평가 전용 에이전트(멀티스텝 워크플로우)를 만들어 인간 전문가 수준의 판단을 흉내낸다 (21:53).
- 평가는 "건강검진"이자 "여정" — 룰베이스부터 시작하라 — 평가를 처음 도입할 때는 체중계처럼 가장 간단한 지표(룰베이스: 예를 들어 사내 AI 대화에 주식·부동산·코인 언급이 섞였는지 탐지)부터 시작해 점점 고도화(BMI→MRI 비유)하는 여정으로 접근해야 한다는 조언이 나온다. 평가를 잘하는 조직과 못하는 조직의 차이는 결국 "사고가 터지느냐 안 터지느냐"와 "비용 관리가 되느냐"로 갈린다. 실제 사례로 커서(Cursor)와 윈드서프(Windsurf)의 경쟁에서 커서는 자체 모델로 비용을 관리했지만 윈드서프는 모델 비용을 그대로 엔트로픽·OpenAI에 지불하는 구조였기에 고객이 늘수록 적자가 커져 장기적으로 유지되지 못했다는 분석이 제시됐다 (25:40).
- LLM 이벨과 에이전트 이벨의 차이 — 앤드류 응의 '에이전틱 워크플로우' 개념 — 2024년 앤드류 응 교수가 "GPT-3.5로도 GPT-4.5 이상의 성능을 뽑을 수 있다"고 한 강연을 인용하며 설명한다. 글을 쓸 때 리서치→작성→리뷰 3단계로 모델을 3번 호출(=에이전틱 워크플로우, 요즘은 '하네스'라는 용어로 축약)하면 모델 1회 호출보다 결과가 낫다는 원리를, 평가에도 그대로 적용한 것이 에이전트 이벨이다. 즉 LLM 이벨은 모델과 프롬프트 2개 요소만 바꿀 수 있어 한계가 있지만, 에이전트 이벨은 웹서치로 실시간 데이터를 검증하는 단계까지 포함하는 등 워크플로우 자체를 정교하게 설계할 수 있다 (29:20).
- 좋은 데이터셋 = "좋은 것과 나쁜 것을 구별할 수 있는 것" — 공개 벤치마크는 이미 모델 학습 데이터로 흡수되어 "과최적화"되었기 때문에, 실제 현실 성능과 벤치마크 점수가 괴리되는 문제가 발생한다. 이를 해결하려면 기업 각자의 '커스텀(프라이빗) 벤치마크'가 필요한데, 이는 바리스타가 좋은 커피와 나쁜 커피를 구별하는 것처럼 도메인 전문가의 암묵지(취향)를 데이터로 추출하는 작업이다. 문제는 훌륭한 전문가일수록 바쁘고, 비싸고, 자신의 노하우(직업 안정성의 원천)를 쉽게 공유하려 하지 않는다는 점 — 이 병목이 현재 업계에서 가장 큰 걸림돌로 지목됐다 (32:52).
- 셀프 임프루빙 루프 엔지니어링 — 3일간 83번의 자동 실험 — 이승민 총괄이 금융 도메인 고객사를 위해 직접 실행한 실험이 소개됐다. 과거에는 에이전트를 배포하고 전문가 피드백을 받아 개선하는 데 버전 사이 4~5일~1주가 걸렸지만, 루프 엔지니어링은 AI가 검색 리콜(정답 포함 확률, 처음 52%에서 시작)을 자동으로 측정하고 하이드(HyDE) 기법, 리랭커, 임베딩 모델, 청크 사이즈 등을 스스로 바꿔가며 3일간 83회 실험을 사람 개입 없이 반복해 91점까지 끌어올렸다. 톰슨로이터 시절 변호사 200명이 6개월 걸려 정확도 3%p를 올렸던 것과 비교하며 극적인 생산성 차이를 강조했다. 같은 원리로 프롬프트를 자동 개선하는 '옵티마이즈(Optimize)' 기능도 시연됐다 (57:52).
03기술적 맥락
Arize AI의 기술적 핵심은 '오픈 인퍼런스(Open Inference)'라는 자체 데이터 규격이다. 기존 오픈텔레메트리(OpenTelemetry)를 기반으로 LLM 가시성에 필요한 요소를 추가한 것으로, 랭체인·파이썬·자바스크립트·자바 등 어떤 언어·프레임워크로 에이전트를 만들든 동일한 규격으로 트레이스를 남길 수 있게 한다. 콘센트 규격처럼 "표준화되어 있으면 누구나 믿고 꽂아 쓸 수 있다"는 비유로 설명되며, 일부 퍼블릭 클라우드 업체도 자체 인퍼런스 규격으로 채택하는 등 사실상 업계 표준으로 자리잡고 있다고 언급됐다.
에이전트 트레이싱은 모든 액션을 '스팬'이라는 최소 단위로 쪼개 기록하며, 이렇게 쌓인 라이브 트레이스는 '애드 투 데이터셋(Add to Dataset)' 기능으로 즉시 평가용 데이터셋으로 전환될 수 있다. 좋았던 대화나 특정 전문가의 판단만 골라 모아 별도 데이터셋을 만들고, 이를 기반으로 "이 사람의 판단 기록을 반영한 에이전트를 설계해줘"라는 형태로 역으로 에이전트를 생성하는 '루프 엔지니어링'까지 이어진다. 무료 오픈소스 도구인 '피닉스(Phoenix)'는 도커 이미지로 손쉽게 구동 가능하며, 클로드 코드·코덱스·제미니 CLI 같은 개발 에이전트에도 플러그인 형태로 트레이스 수집을 붙일 수 있다.
04전략적 의미
영상의 핵심 메시지는 "에이전트가 늘어날수록 사람이 직접 할 일은 줄어들지만, 그 대신 에이전트가 무엇을 좋은 결과로 볼지 판단하는 기준(데이터셋·벤치마크·취향)을 설계하는 역할이 더 중요해진다"는 것이다. 프롬프트 엔지니어링은 이미 "정복"되었고, 오케스트레이션 레이어를 짜는 AI 엔지니어의 역할도 루프 엔지니어링으로 상당 부분 자동화될 것이라는 전망이 나온다. 결국 자동화되기 어려운 마지막 영역은 도메인에 대한 '취향'—무엇이 좋고 나쁜지를 가려내는 안목—이며, 이는 실패를 많이 거쳐야 형성되는 인간 고유의 자산으로 제시된다.
비즈니스 관점에서는 2026년 하반기 글로벌 트렌드로 "에이전트의 ROI를 증명하라"는 압박이 커지고 있다는 점이 강조된다. 특정 벤더(예: 클로드)의 프론티어 모델에만 의존하지 않고, 정량적 평가 결과를 근거로 저비용 오픈소스 모델(GLM, Qwen 등)로 교체하거나 단순 작업은 자체 소형 모델로 분리해 비용을 절감하는 전략(LG유플러스 사례: 품질 유지하며 운영비 약 1/3 절감)이 실제로 확산되고 있다. 또한 스스로 쌓은 트레이스·데이터셋·벤치마크는 회사만의 지적재산이자 차별화 포인트가 되므로, "자가 인프라 세팅 능력"이 향후 조직 경쟁력의 핵심 축으로 부상할 것으로 전망된다.
05핵심 워크플로우 또는 비교표
| 평가(eval) 유형 | 시기 | 방식 | 장점 | 한계 |
|---|---|---|---|---|
| 휴먼 이벨 | ~2022년 이전 | 사람(도메인 전문가)이 직접 채점 | 최고 품질의 데이터셋 | 매우 비싸고 느림(예: 변호사 200명, 6개월에 정확도 3%p 개선) |
| 코드 이벨 | ~2022년 이전 | 정규식 등 룰베이스 탐지 | 빠르고 저렴 | 단순 패턴만 탐지, 의미 판단 불가 |
| LLM 이벨 | 2022년~ | LLM 1회 호출로 채점 | 사람 대비 80~85% 근접, 경향성 파악 가능 | 모델·프롬프트 2요소만 조정 가능, 도메인 지식 반영 한계 |
| 에이전트 이벨 | 2026년~ (Arize 신기능) | 평가 전용 멀티스텝 에이전트(하네스) | 인간 전문가 수준 판단 근접, 실시간 웹검증 등 포함 가능 | 구축 난이도 높음 |
| 도입 단계 | 활동 | 비고 |
|---|---|---|
| 1단계 | 트레이스 쌓기 | 피닉스(무료 오픈소스) 등으로 즉시 시작 가능 |
| 2단계 | 룰베이스 평가 | 시스템 프롬프트로 원치 않는 행동 차단 |
| 3단계 | LLM/에이전트 평가 도입 | 허깅페이스 공개 데이터셋으로 우선 테스트 |
| 4단계 | 프라이빗 벤치마크·데이터셋 구축 | 트레이스 기반 자체 데이터셋 생성, 루프 엔지니어링·프롬프트 자동 최적화 |
06활용 시나리오
- 규제 산업의 컴플라이언스 대응: 금융·통신사가 AI 에이전트의 개인정보 처리 과정을 감독 당국에 증적 자료로 제출해야 할 때, 옵저버빌리티 트레이스를 근거 자료로 활용해 심사 통과 및 서비스 출시를 가능하게 한다.
- 모델 교체·비용 최적화 의사결정: 실시간 번역 데모처럼 여러 모델(하이쿠, 그록, GPT 계열 등)을 동일 데이터셋으로 평가해 레이턴시·품질을 정량 비교하고, "바이브 체크"가 아닌 숫자 근거로 프로덕션 모델을 결정한다.
- 검색/RAG 파이프라인 자동 개선: 리콜 등 검색 품질 지표를 목표로 설정하고, 하이드·리랭커·임베딩 모델·청크 사이즈 조합을 AI가 자동으로 실험(루프 엔지니어링)해 사람이 수개월 걸릴 개선을 며칠로 단축한다.
- 1인 기업/솔로 빌더의 도메인 특화 에이전트 구축: 허깅페이스 공개 데이터셋으로 시작해 자신의 트레이스 데이터를 반영한 한국어·도메인 특화 데이터셋으로 점진 고도화하며, 자신만의 프라이빗 벤치마크를 자산화한다.
07현황 및 전망
현재 업계는 공개 벤치마크의 신뢰도 저하(모델의 벤치마크 과최적화)로 인해 "프라이빗 벤치마크"를 직접 구축하려는 움직임이 막 시작된 단계로 소개된다. 그 선두 사례로 대고객 에이전트 전문 SI 기업 '시에라 AI(Sierra AI)'의 '타우벤치(Tau-bench, 영상 내 '타워벤치'로 발음)'가 언급되는데, 항공·은행·텔코 등 도메인별로 세분화된 공개 벤치마크로 모델 순위를 매기지만, 이 역시 공개된 이상 학습 데이터로 흡수될 위험이 있어 기업들은 이를 참고해 각자의 비공개(클로즈드) 벤치마크를 가져야 한다는 것이 업계의 방향으로 제시된다. Arize는 8월 밋업에서 이 벤치마크 데이터셋 추출 과정을 다룰 예정이라고 예고했다.
장기 전망으로는, 프롬프트 엔지니어링이 이미 자동화(정복)되었듯 AI 엔지니어의 오케스트레이션 작업도 루프 엔지니어링으로 상당 부분 대체될 것이며, 최종적으로 사람에게 남는 차별화 요소는 도메인에 대한 '취향'(안목)이라는 진단이 제시된다. 또한 Arize AI는 최근 바이너리스(Baseten)에 인수된 것으로 알려졌는데, 이는 AI 옵저버빌리티에 국한되지 않고 인프라·서빙 레이어·애플리케이션까지 아우르는 통합 서비스로 확장하려는 전략의 일환으로 설명되며, 브랜드와 한국 커뮤니티 운영은 그대로 유지된다고 밝혔다. 발화자들은 한국에서도 글로벌 시장에서 성공하는 AI 에이전트가 나올 수 있다는 기대를 표명하며, 이를 위한 데이터셋·벤치마크·트레이싱·비용 최적화 지원을 이어가겠다고 밝혔다.
08용어 사전
| 용어 | 설명 |
|---|---|
| 옵저버빌리티(Observability) | AI 에이전트의 내부 동작(입출력, 판단 과정)을 낱낱이 기록·관찰하는 능력. 영상에서는 "쌓기+평가=인사이트" 공식으로 설명 |
| 스팬(Span) | 에이전트 액션을 기록하는 최소 단위. 하나의 시작과 끝이 있는 개별 동작(툴 호출, 모델 응답 등)을 지칭 |
| 오픈 인퍼런스(Open Inference) | Arize AI가 만든 LLM/에이전트 트레이싱 데이터 표준 규격. 오픈텔레메트리 기반 확장 |
| 오픈텔레메트리(OpenTelemetry) | 소프트웨어 시스템의 로그·트레이스를 표준화해 수집하는 기존 업계 관측성 기술 |
| LLM 이벨(LLM Eval) | LLM에게 다른 LLM의 답변을 채점시키는 평가 방식 |
| 에이전트 이벨(Agent Eval) | 평가 자체를 멀티스텝 에이전트(하네스)로 수행해 인간 전문가 수준 판단을 흉내내는 평가 방식 |
| 하네스(Harness) | 여러 모델 호출을 조합한 에이전틱 워크플로우를 가리키는 업계 축약 용어 |
| 루프 엔지니어링(Loop Engineering) | 실험-평가-개선을 반복하며 AI가 스스로 파이프라인·프롬프트를 최적화하는 셀프 임프루빙 기법 |
| 하이드(HyDE) | 가상의 답변을 먼저 생성해 검색 품질을 높이는 검색 증강 기법(Hypothetical Document Embeddings) |
| 리랭커(Reranker) | 1차 검색 결과를 재정렬해 더 관련성 높은 문서를 상위로 올리는 모델/모듈 |
| 리콜(Recall) | 검색된 문서 중 정답이 포함되어 있을 확률을 나타내는 지표 |
| 프라이빗/커스텀 벤치마크 | 공개 벤치마크의 과최적화 문제를 피하기 위해 기업이 자체 도메인 데이터로 만든 비공개 평가 기준 |
| 골든 데이터셋(Golden Dataset) | 도메인 전문가의 판단(취향)을 반영해 좋음/나쁨을 구별할 수 있게 만든 고품질 정답 데이터셋 |
| 시에라 AI(Sierra AI) / 타우벤치(Tau-bench) | 대고객 AI 에이전트 구축 SI 기업과, 이 회사가 만든 도메인별(항공·은행·텔코 등) 공개 벤치마크 |
| 피닉스(Phoenix) | Arize AI가 만든 무료 오픈소스 트레이싱 도구. 도커로 간단히 구동 가능 |
| 랭퓨즈(Langfuse) | 한국에서 널리 쓰이는 경쟁 오픈소스 LLM 옵저버빌리티 도구 |
| 알릭스(Arize AX) | Arize의 상용(유료) 플랫폼 버전, 데이터셋 편집·자동 생성 기능 포함 |
| 옵티마이즈(Optimize) | Arize의 프롬프트 자동 개선 기능. 데이터셋만 연결하면 AI가 반복 실험으로 프롬프트를 스스로 고도화 |
| 무브 37(Move 37) | 알파고가 이세돌과의 대국에서 둔 인간이 예상 못한 창의적인 수. 루프 엔지니어링이 인간이 가지 않은 경로를 탐색해 돌파구를 찾는 것에 비유됨 |