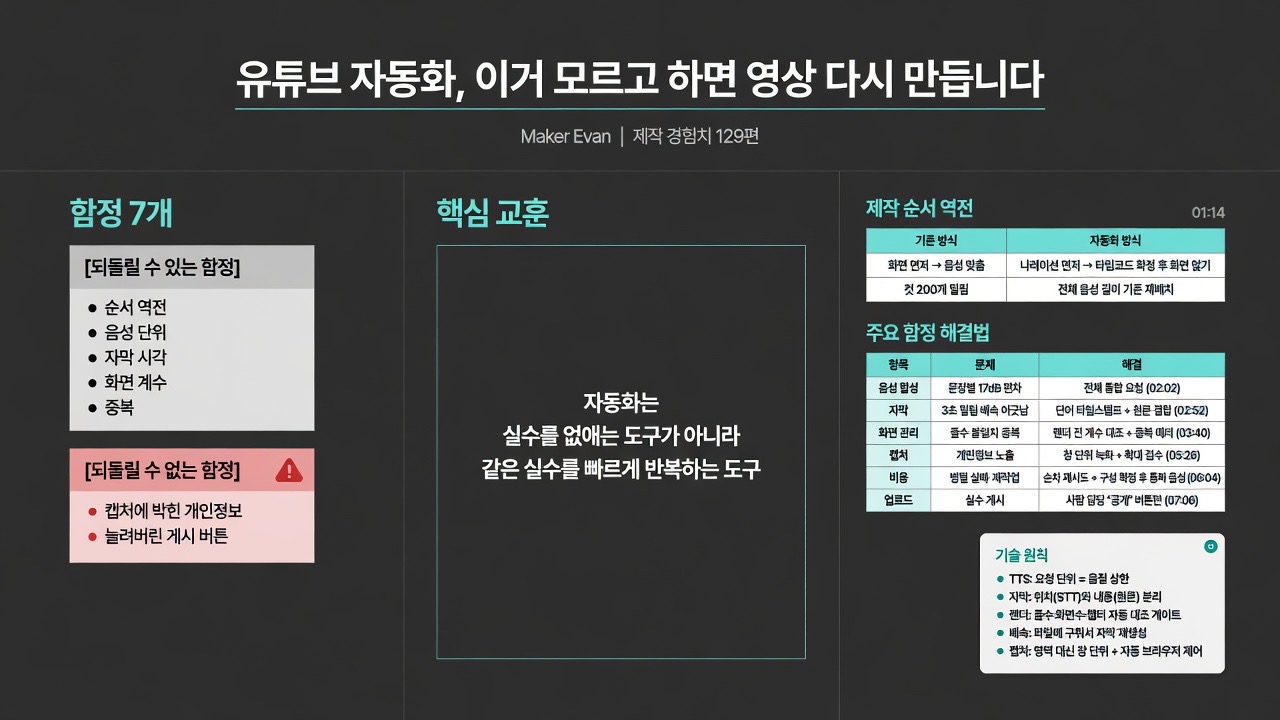
제작 순서 역전 — 나레이션 먼저, 화면은 나중 사람이 편집할 때는 화면을 먼저 짜고 음성을 맞추지만, 자동화에서는 음성 길이를 만들어보기 전엔 알 수 없어 화면과 어긋난다. 컷이 200개면 하나만 밀어도 뒤가 전부 밀리므로, 나레이션으로 시각(타임코드)을 먼저 확정하고 화면을 그 위에 얹는 순서로 뒤집었다. (01:14)
음성 합성 단위 — 문장별 분할이 아닌 전체 통합 요청 문장 단위로 따로 합성하면 구간별 음량 편차가 17dB(옆사람 말소리와 속삭임 차이 수준)까지 벌어지고 억양도 매번 끊긴다. 컴프레서로 음량만 보정해서는 해결되지 않았고, 대본 전체를 한 번의 요청으로 합성하니 편차가 크게 줄었다. (02:02)
자막 동기화 — 단어 단위 타임스탬프 + 원문 텍스트 결합 음성 인식이 만든 자막을 문장 덩어리째 붙이면 3초씩 밀리고, 글자수 기준 분할도 말 속도가 균등하지 않아 어긋난다. 해결책은 단어별 등장 시각만 음성 인식에서 가져오고 실제 글자는 원문(고유명사 오타 방지)을 쓰는 방식이다. 배속을 파일에 구워 넣을 경우 자막도 최종 배속 파일 기준으로 다시 만들어야 하며, 그렇지 않으면 10분 영상 기준 끝부분에서 45초가 밀린다. (02:52)
화면 개수·중복 관리 — 렌더 전 계수 대조 + 중복 시 강제 에러 대본 줄수와 화면수가 어긋나면 챕터 전체가 밀리므로 렌더 전에 챕터별 줄수와 화면수를 대조해 다르면 멈춘다. 같은 화면(카드·목록·캡처)이 반복되면 아예 에러로 생성을 중단시켜, 이를 "같은 말을 두 번 하고 있다"는 신호로 활용한다. (03:40)
캡처 사고 — 확대 검수 + 창 단위 녹화 캡처는 이미 게시된 뒤 발견되는 사고라 가장 위험하다. 축소 미리보기에서는 안 보이던 대화 제목, 파일 경로, 로그인 이메일, 사용 금액이 확대하면 드러난다. 화면 영역 지정 녹화는 겹친 다른 창까지 찍히므로, 창 단위 캡처와 자동화 도구로 특정 웹페이지만 여는 방식으로 전환했다. (05:26)
생성 도구 비용 — 순차 재시도 + 통짜 음성의 트레이드오프 이미지·영상 생성을 병렬로 던지면 API가 몰려 셋 다 실패하므로 한 장씩 순서대로 처리하고, 실패 시 프롬프트를 바꾸지 말고 같은 요청을 그대로 재시도한다. 썸네일 한글은 받침·모음이 깨질 수 있어 한 글자씩 대조 검수하고, 틀리면 획이 단순한 표현으로 문구 자체를 바꾼다. 음성을 대본 전체로 통짜 합성하면 품질은 좋지만 한 줄만 고쳐도 전체(5천자 등)를 다시 태워야 해 비용이 크므로, 분량·구성을 먼저 확정한 뒤 음성을 만드는 순서로 바꿨다. (06:04)
업로드 — 게시 직전 한 칸만 사람이 담당 업로드 화면은 다음 버튼이 매번 같은 위치에 있어 연속 클릭이 검수용 초안을 실수로 공개 게시까지 밀어버릴 수 있다(실제 사고 경험). 파일 업로드~자막까지는 자동화하되 "공개 상태" 결정 버튼만 사람이 직접 누르는 규칙을 세웠고, 예약 게시 시 날짜 기본값이 내일로 잡히는 점과 지난 시각은 예약 불가라는 점도 함정으로 지적했다. (07:06)
03기술적 맥락
TTS(음성 합성) 단위의 물리적 한계: 문장을 잘라 개별 API 호출로 합성하면 각 호출이 억양 곡선을 처음부터 새로 시작하므로, 후처리(컴프레서·게인 보정)로는 문장 간 자연스러운 흐름을 복원할 수 없다. 합성 요청 단위 자체가 음질의 상한을 결정한다.
자막-오디오 동기화의 근본 문제: 음성 인식(STT)이 반환하는 타임스탬프는 신뢰하되 텍스트는 신뢰하지 않는 "위치와 내용 분리" 전략이 핵심이다. 단어 단위 타임코드 + 원문 텍스트 결합이 문장 덩어리 붙이기나 글자수 균등분할보다 정확하다.
렌더링 파이프라인의 계수 검증: 대본 줄수·화면 수·챕터 수를 렌더 전 자동 대조하는 게이트를 두어, 어긋남을 "애니메이션이 음성과 안 맞는다"는 눈에 보이는 증상이 아니라 "계수 불일치"라는 근본 원인 단계에서 차단한다.
속도 처리 위치의 중요성: 재생 속도(배속)를 플레이어 옵션으로 걸면 미리보기와 최종 파일이 달라지므로, 배속을 파일 자체에 렌더링하고 자막도 그 최종 파일 기준 시각으로 재생성해야 한다.
캡처 자동화 도구의 스코프 제한: 전체 화면 영역 녹화 대신 창 단위 캡처, 웹 페이지는 자동화 도구로 해당 페이지만 별도로 열어 캡처 범위를 물리적으로 좁히는 방식.
04전략적 의미
자동화는 실수 제거 도구가 아니라 실수 증폭 도구라는 프레임 전환이 핵심 메시지다. 사람이 손으로 만들 때는 한두 컷의 오차를 즉석에서 고치지만, 자동화 파이프라인은 같은 오차를 200개 컷·129편에 걸쳐 동일하게 반복 생산한다.
증상 발생 지점과 원인 발생 지점의 분리라는 디버깅 원칙이 전체 7개 사례를 관통한다. 음량이 튀면 음량이 아니라 합성 단위를, 자막이 밀리면 자막이 아니라 시각 출처를, 화면이 안 맞으면 화면이 아니라 줄수를 봐야 한다는 것이다.
되돌릴 수 있는 실수와 되돌릴 수 없는 실수를 구분해 자동화 범위를 설계하는 접근은 일반적인 자동화/AI 파이프라인 설계에도 적용 가능한 원칙이다. 비용이 드는 재작업(음성·자막·화면)은 자동화하되, 게시·개인정보 노출처럼 되돌릴 수 없는 지점은 반드시 사람이 마지막 확인을 담당한다.
1인 또는 소규모 팀이 콘텐츠 생산을 스케일업할 때, 품질 저하가 아니라 되돌릴 수 없는 사고(개인정보 유출, 오게시)가 실질적인 리스크의 핵심이라는 시사점을 준다.
05핵심 워크플로우 또는 비교표
구분
기존 방식 (문제 발생)
개선 방식 (에반의 해법)
제작 순서
화면 먼저 → 음성 맞춤
나레이션(타임코드) 먼저 → 화면을 붙임
음성 합성 단위
문장별 개별 합성
대본 전체 1회 요청으로 합성
자막 시각
STT 문장 덩어리 그대로 사용
단어 단위 시각 + 원문 텍스트 결합
배속 처리
재생 속도로 처리(미리보기와 결과물 불일치)
배속을 파일에 구워넣고 자막도 재생성
화면-대본 정합성
사후 발견
렌더 전 챕터별 줄수·화면수 자동 대조
화면 중복
방치
중복 감지 시 생성 강제 중단(에러 처리)
캡처 검수
축소 미리보기로 확인
확대해서 한 장씩 확인 + 창 단위 녹화
이미지/영상 생성 실패
병렬 요청, 프롬프트 수정 재시도
순차 요청, 동일 프롬프트 그대로 재시도
업로드 공개 결정
전 과정 자동 클릭
공개 상태 버튼만 사람이 수동 클릭
유형
함정
되돌림 가능 여부
되돌릴 수 있음(비용만 발생)
제작 순서, 음성 합성 단위, 자막 시각, 화면 계수, 화면 중복
다시 만들면 복구
되돌릴 수 없음(사고)
캡처에 노출된 개인정보/경로/계정, 눌려버린 게시 버튼
이미 노출·게시되어 원상복구 불가
06활용 시나리오
1인 유튜버·크리에이터의 자동화 파이프라인 구축: 대본→음성→자막→화면 자동 생성 파이프라인을 만들 때 순서 설계(나레이션 우선)와 계수 검증 게이트를 처음부터 반영해 재작업 비용을 줄인다.
AI 콘텐츠 제작 도구(TTS·STT·이미지 생성 API) 통합 개발자: 음성 합성 요청 단위 설계, 단어 단위 타임스탬프 활용, 병렬 요청 실패 처리 로직(순차 재시도) 등 API 사용 패턴을 실무에 바로 적용할 수 있다.
화면 녹화/캡처 기반 튜토리얼 제작자: 개인정보·계정 정보 노출 방지를 위한 창 단위 캡처, 확대 검수, 자동화 도구를 통한 페이지 단독 오픈 습관을 체크리스트로 활용한다.
업로드 자동화(RPA/봇) 설계자: 되돌릴 수 없는 최종 단계(게시, 발송, 결제 확정 등)는 사람이 수동으로 확인하는 "안전장치 1칸" 설계 원칙을 다른 자동화 도메인(이메일 발송, 결제 승인 등)에도 응용할 수 있다.
07현황 및 전망
에반은 현재 129편의 영상을 자동화 파이프라인으로 제작한 경험을 바탕으로 각 함정을 하나씩 메워왔으며, 이번 영상은 그 시행착오를 정리해 공유하는 후속편 성격이다(전편은 "유튜브 제작을 스킬로 묶은" 내용).
자동화 도구(TTS, STT, 이미지/영상 생성 API)의 신뢰도가 계속 높아지고 있지만, 영상에서 지적된 문제들(음량 편차, 자막 어긋남, 한글 깨짐, 병렬 요청 실패)은 여전히 현재 시점 생성형 AI 도구들의 공통적 한계로 남아있다.
향후 방향으로는 되돌릴 수 없는 지점(게시, 개인정보 노출)에 대한 사람의 최종 검수를 유지하면서, 나머지 반복 작업의 자동화 범위를 계속 넓혀가는 하이브리드 워크플로우가 계속될 것으로 보인다. 영상 말미에 시청자 제보를 요청해 다음 영상에 추가 함정 사례를 반영하겠다고 밝혔다.
08용어 사전
용어
설명
TTS (Text-to-Speech)
텍스트를 음성으로 변환하는 합성 기술. 합성 요청 단위(문장별 vs 전체)에 따라 음량·억양 일관성이 달라진다
STT (Speech-to-Text)
음성을 텍스트로 변환하는 인식 기술. 자막 생성에 쓰이며 고유명사 인식 오류가 잦아 위치(타임스탬프)만 활용하는 게 안전하다
dB (데시벨)
음량 크기 단위. 영상에서 언급된 17dB 편차는 옆 사람 말소리와 속삭임 수준의 차이에 해당
배속 굽기
재생 속도를 플레이어 옵션이 아닌 파일 자체에 렌더링해 고정하는 방식. 미리보기와 최종 결과물의 불일치를 방지
렌더 전 계수 대조
영상 렌더링 전에 대본 줄수와 화면(컷) 수를 자동으로 세어 일치 여부를 검증하는 절차
창 단위 캡처
화면 전체나 임의 영역이 아니라 특정 애플리케이션 창만 선택해 녹화·캡처하는 방식으로 개인정보 노출을 방지