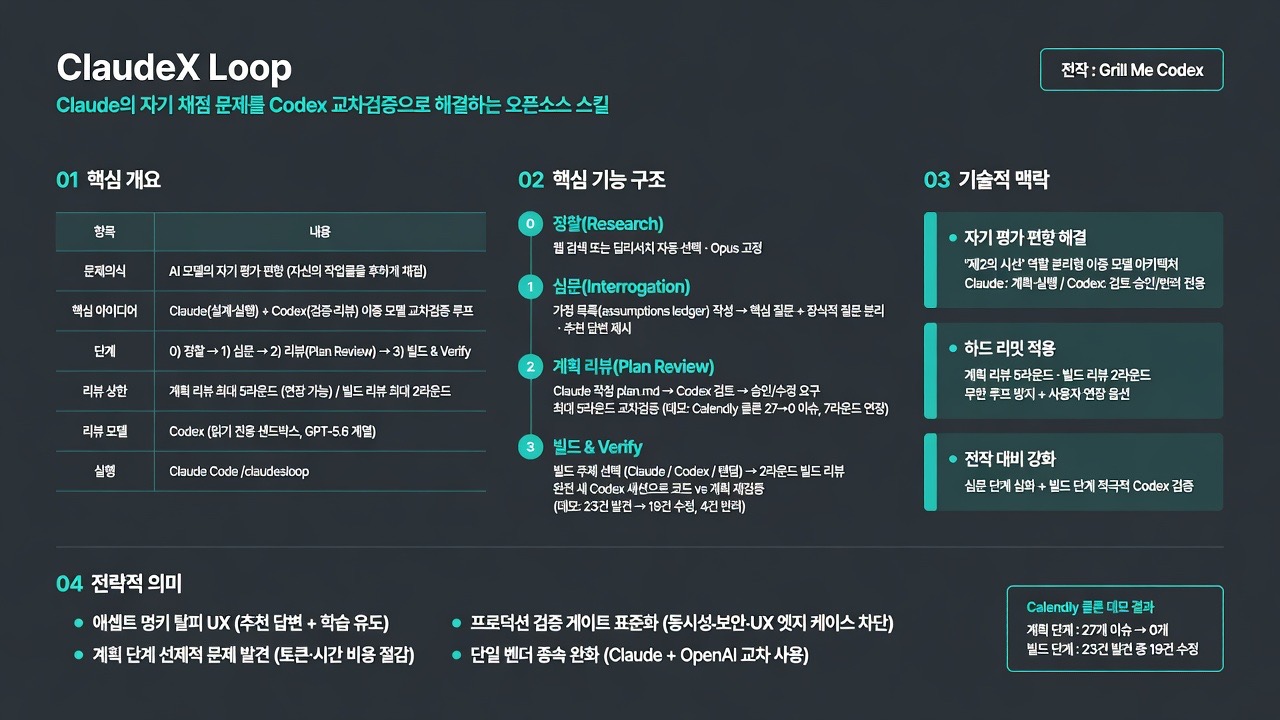
Calendly 클론 프로젝트에서 계획 단계 27→0개 이슈(7라운드), 빌드 단계 23건 발견 중 19건 수정·4건 반려
실행 주체
Claude Code 슬래시 커맨드 /claudesloop
02핵심 기능/내용 구조
정찰(Research) 단계 — 웹 검색 또는 딥리서치 선택: 사용자가 스트림오브컨시어스니스로 요청을 던지면, 스킬이 표준 웹 검색(서브에이전트 다건 파견)과 풀 딥리서치 중 방식을 고르게 한다. 스킬은 기본적으로 Opus에 고정되어 있어 Fable에서 딥리서치를 돌릴 때 발생하는 과도한 사용량 소모를 방지한다 (05:01).
심문(Interrogation) 단계 — 강화된 플랜 모드 질의: 딥리서치가 끝나면 '가정 목록(assumptions ledger)'을 만들고, 이어서 '핵심(load-bearing)' 질문과 '장식적(cosmetic)' 질문 두 단계로 나눠 사용자와 합의를 맞춘다. 각 질문에는 추천 답변이 함께 제시된다 (06:02).
계획 리뷰(Plan Review) 단계 — Codex와의 최대 5라운드 교차검증: Claude가 표준 plan.md를 작성하면 Codex가 읽기 전용 샌드박스에서 이를 검토해 승인 또는 수정 요구를 보낸다. Claude가 동의/반박 후 재수정하는 과정을 최대 5라운드까지 반복하며, 필요 시 라운드 수를 연장할 수 있다 (07:36, 데모에서는 7라운드까지 연장).
빌드(Build) 단계 — 시공 주체 선택과 2라운드 빌드 리뷰: 계획이 승인되면 Claude가 빌드할지, Codex가 빌드할지, 혹은 특정 파트(예: 이미지 생성)만 Codex에 맡기는 탠덤 빌드를 할지 선택한다. 어느 쪽이 빌드하든 다른 모델이 결과물을 재검토하며, 이 빌드 리뷰 루프는 기본 2라운드로 설정돼 있다 (08:41).
완전히 새로운 컨텍스트로 코드 대 스펙 재검증: 빌드 완료 후 완전히 기억이 없는 새 Codex 세션이 투입되어, 계획서와 실제 코드를 대조 검증한다. 데모에서는 23건의 문제를 발견해 19건은 즉시 수정, 4건은 반려되었다 (10:29).
03기술적 맥락
자기 평가 편향(self-grading bias) 문제: 어떤 LLM이든 자신이 만든 계획이나 코드를 평가하라고 하면 스스로에게 후한 점수를 준다. 이는 단일 모델 파이프라인의 구조적 한계이며, ClaudeX Loop는 이를 "제2의 시선(second pair of eyes)"을 투입해 구조적으로 해결한다.
역할 분리형 이중 모델 아키텍처: Claude는 계획 수립과 코드 실행을 담당하고, Codex(GPT-5.6 계열)는 읽기 전용 샌드박스에서 검토·승인/반려 역할만 수행한다. 역할이 분리되어 있어 한쪽이 다른 쪽을 견제하는 구조가 성립한다.
하드 리밋을 통한 무한루프 방지: 계획 리뷰는 5라운드, 빌드 리뷰는 2라운드로 상한을 두어 토큰을 무한히 소모하는 상황을 막는다. 다만 상한에 도달해도 사용자가 라운드 연장을 선택할 수 있는 탈출구가 있다.
모델 교체 가능성: Codex 대신 로컬 모델을 리뷰어로 투입하는 것도 스킬 설계상 지원되며, 각 단계의 라운드 수 등 변수는 사용자가 직접 조정할 수 있다.
전작(Grill Me Codex) 대비 변경점: 심문 단계의 질의가 더 깊어졌고(enhanced interrogation), 실행(빌드) 단계에서도 Codex를 더 적극적으로 개입시켜 코드 자체에 대한 검증을 강화했다.
04전략적 의미
"애셉트 멍키(accept monkey)" 탈피를 유도하는 UX 설계: 스킬은 추천 답변을 제시하면서도, 이해가 안 되면 계속 설명을 요구하라고 권장한다. 이는 단순 승인 반복이 아니라 사용자가 도메인을 학습하며 판단력을 기르도록 설계된 워크플로우다.
토큰/시간 비용의 선제적 절감: 문제를 빌드 이후가 아니라 계획 단계에서 미리 잡아내면, 잘못된 코드를 작성하고 다시 고치는 데 드는 반복 토큰 소모를 피할 수 있다. 발표자는 이를 "많은 시간과 돈을 절약한다"고 명시했다.
프로덕션 이전 검증 게이트의 표준화: 동시성 버그(중복 예약), 보안 결함(평문 토큰 저장), UX 결함(시간대 밀림, 종일 이벤트 처리 오류) 등은 개별 개발자가 놓치기 쉬운 엣지 케이스인데, 교차검증 루프가 이를 구조적으로 걸러낸다.
단일 벤더 종속 완화: Claude와 Codex(OpenAI 계열)를 교차 사용하는 워크플로우는 특정 모델 제공사의 판단 편향에 전적으로 의존하지 않는 실무 패턴을 보여준다.
05핵심 워크플로우 또는 비교표
단계
담당 모델
산출물
반복 상한
0. 정찰(Research)
Claude(Opus)
웹 검색 결과 또는 딥리서치 리포트
1회
1. 심문(Interrogation)
Claude
가정 목록(assumptions ledger), 핵심/장식적 질문 답변
1회(반복 질의 가능)
2. 계획 리뷰(Plan Review)
Claude ↔ Codex
plan.md, 승인 또는 수정 요구 목록
기본 5라운드(연장 가능, 데모에서 7라운드)
3. 빌드(Build)
Claude 또는 Codex(선택/탠덤)
실제 코드베이스
—
4. 빌드 검증(Build Review)
Codex(새 컨텍스트)
코드 대 스펙 대조 발견 목록(수정/반려 분류)
기본 2라운드
데모 지표
계획 리뷰 단계
빌드 검증 단계
발견된 이슈 수
1라운드차 27건 → 7라운드 후 0건(승인)
23건
처리 결과
전량 반영 후 승인
19건 수정, 4건 반려
대표 이슈
중복 예약 제약 컴파일 불가, OAuth 연결 흐름 문제, 동시 재예약 시 두 건 모두 성공하는 동시성 버그
매 회의 후 시간 그리드 밀림, 관리 토큰 평문 저장, 종일 일정이 잘못된 시간대를 차단
06활용 시나리오
그린필드 프로젝트 초기 설계 검증: 새 SaaS 앱(예: Calendly 클론)을 처음부터 설계할 때, 계획 단계에서 Codex의 교차검증을 거쳐 구조적 결함(동시성, 인증 흐름)을 코드 작성 전에 제거한다.
기존 프로젝트에 대형 기능 추가 전 게이트: "기능을 추가하기 전"에 스킬을 호출하도록 설계되어 있어, 리팩터링이나 신규 기능 도입 시 계획 리뷰를 표준 절차로 삽입할 수 있다.
보안·동시성 민감 도메인의 사전 결함 발견: 결제, 예약, 인증처럼 엣지 케이스가 치명적인 도메인에서 평문 토큰 저장이나 이중 승인 같은 문제를 프로덕션 이전에 걸러낸다.
AI 활용 학습 도구로서의 활용: 초보 개발자가 추천 답변을 무비판적으로 수락하는 대신, "더 설명해줘"를 반복 요청하며 도메인 지식을 습득하는 학습 루프로 사용할 수 있다.
07현황 및 전망
발표 시점 기준 ClaudeX Loop는 이미 공개되어 실사용 데모(Calendly 클론)가 시연되었으며, 전작 Grill Me Codex에서 심문 단계와 빌드 단계 검증을 강화한 후속 버전이다.
발표자는 리뷰 루프가 5라운드 상한에서 실제로 막힌 것이 이번이 처음이라고 언급했는데, 이는 대부분의 경우 5라운드 이내에 합의에 도달함을 시사하면서도 상한 연장 기능이 실제로 필요할 수 있음을 보여준 사례다.
로컬 모델을 Codex 대신 리뷰어로 투입하는 확장 경로가 스킬 설계상 이미 열려 있어, 향후 완전 온디바이스 또는 저비용 교차검증 조합으로 확장될 가능성이 있다.
다만 이 영상은 스킬 제작자 본인의 홍보 성격(자체 유료 강의 스폰서 언급 포함)이 섞여 있어, 실제 도입 전 별도 채널의 재현·검증이 필요하다.
08용어 사전
용어
설명
ClaudeX Loop
Claude와 Codex를 교차검증 루프로 엮은 오픈소스 Claude Code 스킬. 전작명은 Grill Me Codex
자기 채점(self-grading) 문제
LLM이 자신의 결과물을 평가할 때 항상 후하게 평가하는 구조적 편향
Load-bearing 질문
프로젝트의 기본 기능/구조를 좌우하는 핵심 질문(예: 어느 구글 계정을 쓸지)
Cosmetic 질문
기본 기능에는 영향을 주지 않는 장식적·부가적 결정 사항
Assumptions ledger
딥리서치 이후 스킬이 자동 생성하는, 프로젝트에 대해 가정한 전제 목록
plan.md
Claude가 심문 단계 종료 후 작성하는 표준 실행 계획 문서
탠덤 빌드(tandem build)
프로젝트의 특정 부분(예: 이미지 생성)만 다른 모델이 맡아 함께 빌드하는 방식
데드락 상태(deadlock state)
Claude와 Codex가 상한 라운드까지 합의에 이르지 못한 상태로, 수락·연장 중 선택 가능