01핵심 개요
| 항목 | 내용 |
|---|---|
| 채널 | 티타임즈TV (프롬프트 엔지니어링의 마법 시리즈) |
| 출연 | 강수진 박사 |
| 주제 | 클로드 페이블5, GPT 5.6, 키미 K3 세 모델의 동일 프롬프트 실전 비교 실험 |
| 핵심 결론 | 모델 성능 차이는 모델 자체보다 "설정값"(추론 강도 등)에서 크게 갈리며, 키미 K3는 토큰 단가가 싸도 추론량이 압도적으로 많아 총비용이 더 비쌀 수 있음 |
| 실험 방식 | 자체 제작 비교 플랫폼 "컴페어 LRMG"(바이브 코딩으로 클로드 코드와 함께 제작)로 동일 프롬프트를 세 모델에 실시간 투입 |
| 테스트 과제 | (1) 항해(범선) 게임 코딩 (2) 인테리어 PPT(프레젠테이션) 생성 (3) 미술관 전시 홈페이지 생성 |
02핵심 기능/내용 구조
영상은 두 가지 검증 가설을 세우고 실험으로 확인하는 구조다.
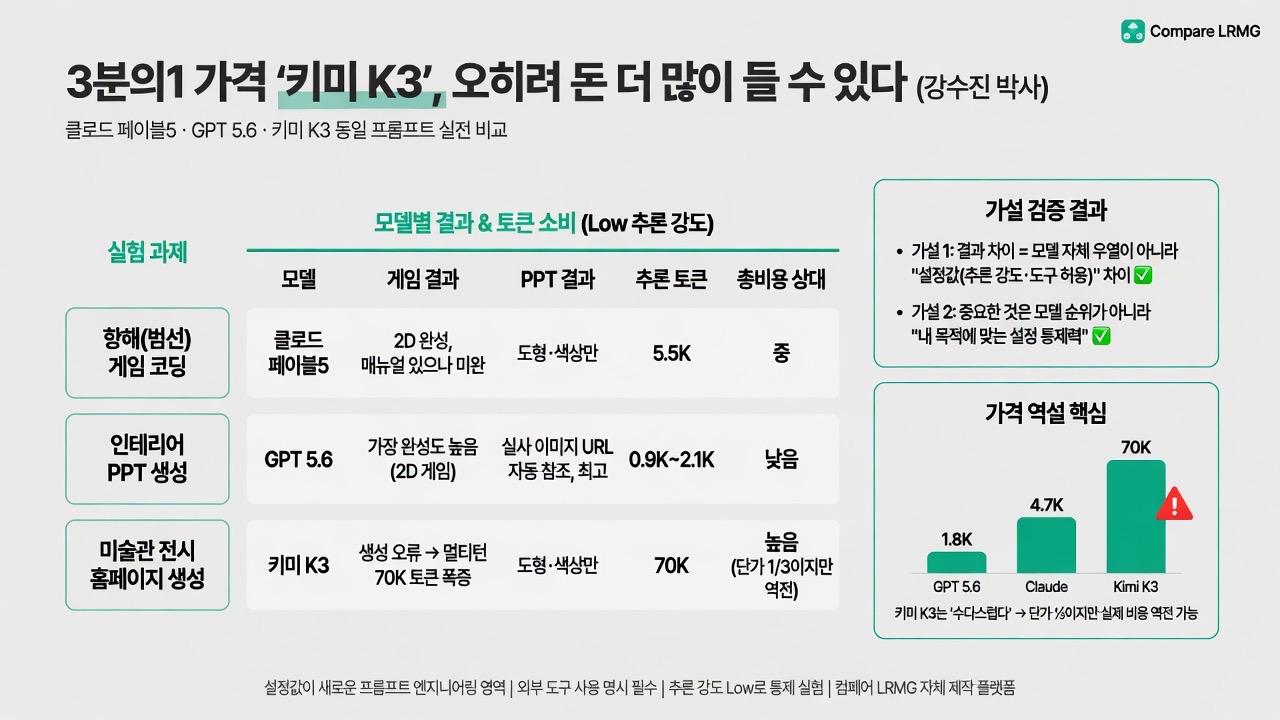
- 가설 1: 동일한 프롬프트를 넣어도 세 모델(클로드 페이블5, GPT 5.6, 키미 K3)의 결과가 다른 이유는 모델 자체의 우열이 아니라 "설정값"(디폴트로 어떤 옵션이 켜져 있는지) 차이에서 온다.
- 가설 2(검증 대상): 중요한 건 모델 순위가 아니라, 같은 조건을 맞췄을 때 원하는 결과가 나오는지, 즉 "내 목적에 맞는 설정을 할 수 있느냐"다.
실험은 00:00 항해 게임 만들기 시연으로 시작한다. 오픈AI가 GPT 5.6 공개 당시 자사 홈페이지에 올린 "예쁜 데모"(프롬프트 한 줄로 만든 3D 느낌의 범선 게임)를 그대로 넣으면 그 결과가 재현되지 않는다는 점을 먼저 짚고, 강 박사가 직접 다듬은(컨트롤 키, 사운드, 게임 매뉴얼 명시 등을 추가한) 프롬프트로 세 모델에 동일하게 입력했다.
결과는 08:52 구간에서 확인된다. GPT 5.6은 예쁜 데모보다는 못하지만 2D 게임 형태로 완성됐고, 클로드 페이블5는 매뉴얼은 그럴듯하나 미완성 느낌, 키미 K3는 아예 생성이 끝나지 않고 오류가 발생했다. 이어 키미 K3를 멀티턴으로 재요청했을 때 추론 토큰이 70K까지 치솟는 장면이 08:52 이후 등장하며, GPT/클로드는 0.9K~5.5K 수준에 그친 것과 극명하게 대비된다.
두 번째 과제인 인테리어 PPT 생성(14:33)에서는 반대로 GPT가 가장 우수했다. 원인은 모델 성능이 아니라 "외부 도구(이미지 URL 참조) 사용 여부"였다. GPT는 스스로 이미지 소스 URL을 참조해 실사 이미지를 넣었지만, 클로드와 키미는 도형·색상으로만 표현해 완성도가 떨어졌다.
03기술적 맥락
- 추론(reasoning) 강도 옵션의 모델별 차이: 클로드 페이블5는 사고(thinking)를 끌 수 없고 항상 켜져 있으며 강도만 조절 가능. GPT 5.6은 강도(Low/Medium/High 등) 조절이 가능. 키미 K3도 기본으로 사고가 켜져 있지만 조절 옵션이 Low/High/Max 세 단계뿐으로 상대적으로 "러프"하다. 이 때문에 실험에서는 세 모델 모두 공통으로 선택 가능한 "Low" 옵션으로 통제했다.
- 토큰 소비량 격차: 동일 과제에서 키미 K3의 추론 토큰이 약 70K까지 치솟은 반면 다른 모델은 0.9K~5.5K 수준에 그쳐, 최대 수십 배 차이가 발생했다. 강 박사는 "키미 모델은 굉장히 수다스럽다"고 표현했다.
- 가격 역설: 키미 K3의 토큰 단가는 다른 모델 대비 약 3분의 1 수준으로 저렴하다고 알려져 있으나, 추론 토큰을 훨씬 많이 소모하기 때문에 실제 과제 완료 총비용은 오히려 더 비쌀 수 있다는 점이 실험으로 확인됐다.
- 통제 불가능했던 변수: 프로바이더별 정책 차이로 사고 모드 켜고 끄기, 온도(temperature) 등 세부 옵션 통일이 불가능했다는 한계를 강 박사가 명시적으로 밝힘.
- 실험 플랫폼: "컴페어 LRMG"라는 이름의 자체 제작 도구로, 시중 상용 툴이 아니라 이번 데모 시연을 위해 바이브 코딩(클로드 코드 활용)으로 만든 것.
04전략적 의미
- 모델 선택 기준의 재정의: "어떤 모델이 1등이냐"보다 "내가 하려는 과제에 맞게 설정을 세분화해서 쓸 수 있느냐"가 실질적으로 더 중요하다는 메시지. 커뮤니티에서 도는 모델 순위나 평판에 휘둘리기보다 자기 목적에 맞는 설정 조합을 찾는 것이 핵심 역량이라는 주장.
- 비용 관리의 함정: 토큰 단가만 보고 저렴한 모델을 선택하면 추론량 폭증으로 총비용이 역전될 수 있다는 실무적 경고. 특히 API 대량 사용이나 배치 작업에서 이 역설이 큰 비용 차이로 이어질 수 있다.
- 프롬프트에 명시해야 할 것들: "외부 도구/URL을 사용해도 된다"처럼 모델이 스스로 판단하지 않는 부분은 프롬프트에 직접 지시해야 한다는 교훈. 프런티어 모델이라도 알아서 다 해주지 않는다.
- 설정값 = 새로운 프롬프트 엔지니어링 영역: 추론 강도를 무조건 최대(Max)로 놓는 게 능사가 아니며, 프롬프트를 더 구체적으로 짜면 낮은 추론 강도로도 충분히 좋은 결과를 낼 수 있다는 실용적 팁.
05핵심 워크플로우·방법론
- 가설 설정: "차이는 모델이 아니라 설정에서 온다"는 가설을 먼저 세우고, 실험으로 참/거짓을 검증하는 구조로 진행. (01:48)
- 조건 통제 시도: 대상 모델 3종(클로드 페이블5, GPT 5.6, 키미 K3) 각각의 추론 강도 옵션을 최대한 동일한 수준(Low)으로 맞춤. 통제 불가능한 항목(사고 모드 온오프, 프로바이더 정책)은 명시적으로 한계로 인정.
- 동일 프롬프트 실시간 투입: 자체 제작 비교 플랫폼에서 세 모델에 같은 프롬프트를 동시에 입력하고 실시간으로 결과·추론 토큰량을 관찰.
- 평가 루브릭 적용: 기본 구현 완성도(한글 UI 깨짐 여부), 게임 로직의 물리적 정합성(충돌 처리 등), 모바일 반응형 여부 등 항목별로 평가.
- 저강도(Low)와 고강도(High) 비교: 같은 프롬프트라도 추론 강도를 올리면 결과물이 더 정교해짐을 별도로 확인.
- 결론 도출: 모델 순위보다 "내 과제 목표 달성 여부"를 기준으로 삼고, 설정값을 과제에 맞게 세분화하는 것이 실전 활용의 지름길이라고 정리.
06활용 시나리오
- AI 코딩 비용 최적화: 반복적으로 코드/게임/웹페이지를 생성하는 업무에서 모델 선택 시 토큰 단가뿐 아니라 실제 추론 토큰 소비량까지 함께 비교해 총비용을 예측하는 데 활용.
- 프레젠테이션 자동 생성 워크플로우 설계: PPT나 슬라이드를 AI로 만들 때, 원하는 결과(예: 실사 이미지 포함)를 얻으려면 "외부 이미지 소스 URL을 참조하라"는 지시를 프롬프트에 명시적으로 넣어야 한다는 점을 실무 체크리스트로 반영.
- 모델별 추론 강도 튜닝 가이드 수립: 팀 내에서 특정 과제(게임 코딩, 문서 생성 등)별로 어떤 모델·어떤 추론 강도 조합이 비용 대비 품질이 최적인지 자체 벤치마크를 만들 때 참고 자료로 활용.
- 바이브 코딩 프로토타입 제작 참고: 강 박사가 만든 "컴페어 LRMG"처럼, 클로드 코드를 활용해 자체 비교/평가 도구를 빠르게 만드는 방식 자체를 벤치마킹.
07현황 및 전망
- 실험 시점 기준 GPT 5.6, 클로드 페이블5, 키미 K3가 "프런티어" 모델로 함께 언급되며, 오픈AI가 GPT 5.6 공개 시 데모로 보여준 예쁜 결과물은 체리피킹된 것이라 실제 프롬프트로는 재현되지 않는다는 점이 확인됨.
- 키미 K3는 저렴한 토큰 단가로 주목받고 있으나, 추론량 폭증 문제로 실사용 시 기대와 다른 비용 구조가 나타날 수 있다는 실무적 주의가 필요한 상황.
- 강 박사는 향후에도 "설정값을 과제에 맞게 세분화"하는 방향이 추론 모델을 잘 활용하는 지름길이 될 것이라 전망하며, 모델 순위 경쟁보다 목적 기반 설정 최적화가 중요해질 것으로 내다봄.
08용어 사전
| 용어 | 한줄설명 | 비유·예시 |
|---|---|---|
| 추론 강도(Reasoning Effort) | AI가 답을 내기 전 얼마나 깊게 생각할지 정하는 옵션 | 시험 문제를 빨리 풀지, 검산까지 꼼꼼히 할지 정하는 것 |
| 추론 토큰 | 모델이 답을 만들기 전 내부적으로 "생각"하는 데 쓴 토큰 수 | 답을 쓰기 전 연습장에 낙서한 분량 |
| 체리 피킹(cherry picking) | 가장 잘 나온 결과만 골라 홍보에 쓰는 것 | 백 장 찍고 제일 잘 나온 한 장만 프로필 사진으로 쓰기 |
| 멀티턴(multi-turn) | 한 번에 끝내지 않고 대화를 이어가며 결과를 수정 요청하는 방식 | 재단사에게 옷을 맞추며 여러 번 수선 요청하는 것 |
| 원샷(one-shot) | 한 번의 프롬프트 입력만으로 결과를 받는 방식 | 리허설 없이 한 번에 촬영을 끝내는 것 |
| 바이브 코딩(vibe coding) | AI와 대화하듯 요청해가며 코드를 즉흥적으로 만들어가는 개발 방식 | 설계도 없이 감으로 가구를 짜맞추는 것 |