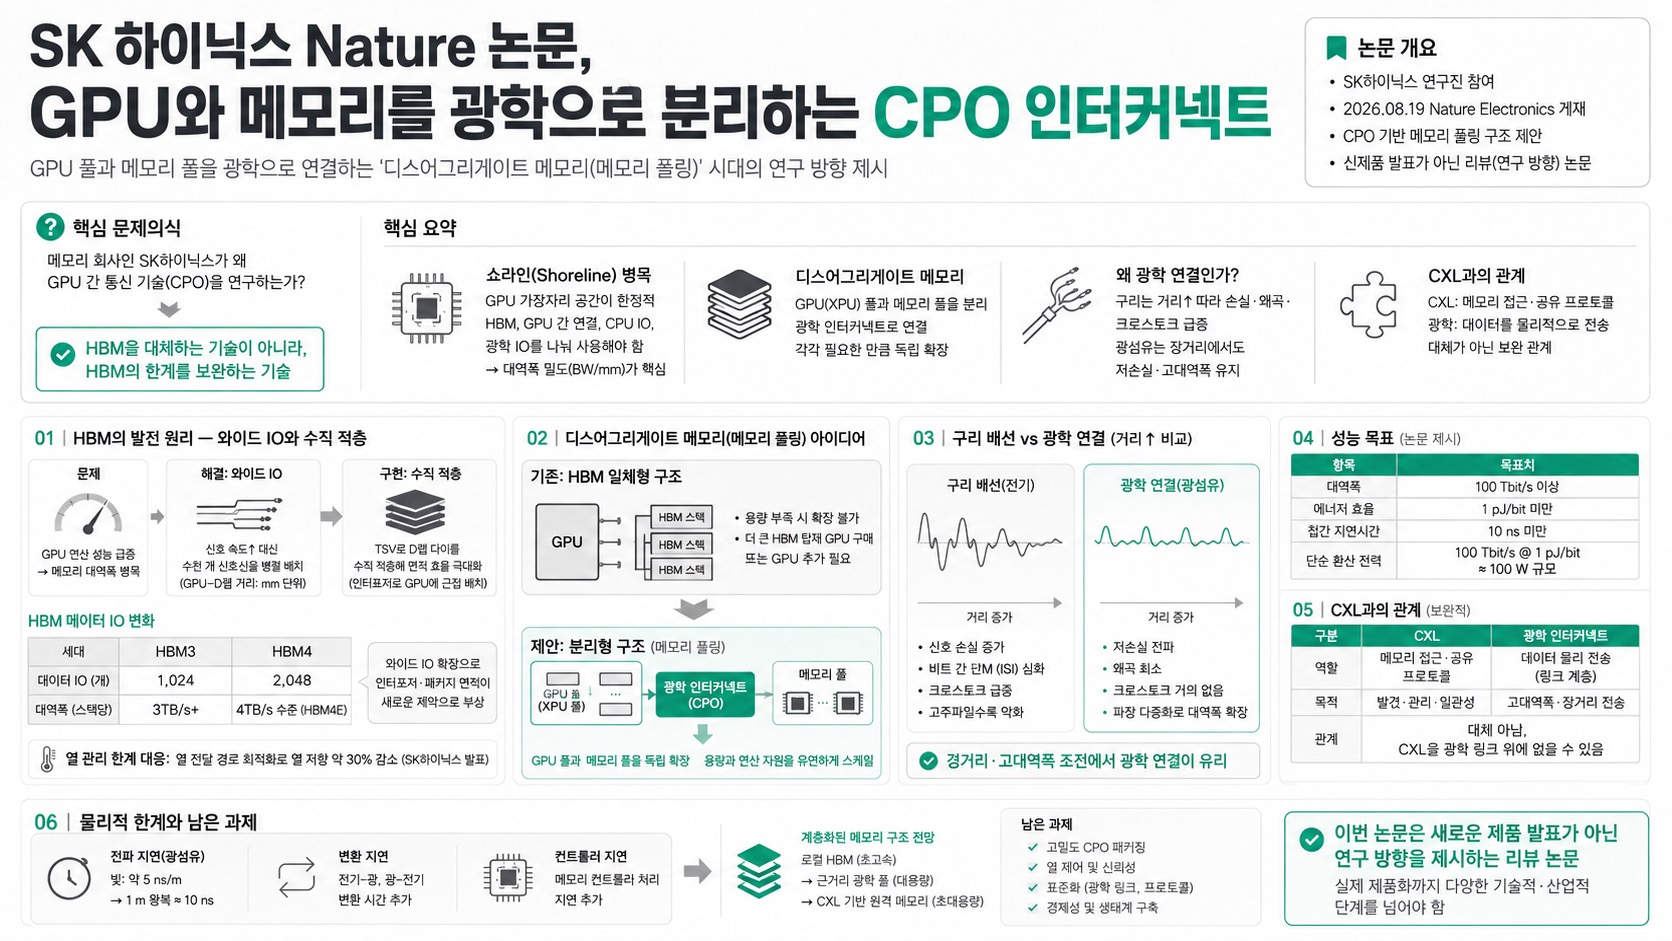
01핵심 개요
| 항목 | 내용 |
|---|---|
| 형식 | 안될공학(진행자 "패치")이 SK하이닉스 연구진이 참여해 2026년 8월 19일 Nature Electronics에 게재한 논문을 해설하는 기술 분석 영상. 구글 플로우로 자체 제작한 비교 영상까지 활용해 개념을 시각화 |
| 화자 | 패치 (안될공학 운영자) |
| 핵심 문제의식 | 메모리 회사인 SK하이닉스가 왜 GPU 간 통신 기술인 CPO(코패키지드 옵틱스)를 연구하는가, 그리고 이것이 HBM을 대체하는 기술인가 아니면 HBM의 한계를 보완하는 기술인가 |
| 핵심 내용 | (1) HBM은 GPU 옆에 메모리를 붙이는 방식으로 대역폭 문제를 풀어왔으나 GPU 가장자리(쇼라인) 공간이 한정된 새로운 병목으로 떠오름, (2) 논문은 GPU 풀과 메모리 풀을 분리하고 그 사이를 광학 인터커넥트로 연결하는 "디스어그리게이트 메모리(메모리 풀링)" 구조를 제시, (3) 이 논문은 신제품 발표가 아니라 향후 연구 방향을 제시하는 리뷰 논문, (4) CXL과는 목적이 다른 보완재이며 광신호 변환·전파 지연 등 넘어야 할 물리적 제약이 다수 남아있음 |
02핵심 기능/내용 구조
- HBM의 발전 원리 — 와이드 IO와 수직 적층: GPU 연산 성능이 빠르게 높아지면서 메모리 대역폭이 병목이 되자, 업계는 신호선 하나의 속도를 높이는 대신 GPU와 D램 사이 거리를 mm 단위로 좁히고 수천 개의 신호선을 병렬로 배치하는 "와이드 IO" 방식을 택했다. HBM3까지 1024개였던 데이터 IO가 HBM4에서는 2048개로 두 배가 됐다. 이렇게 넓은 인터페이스를 감당하면서 충분한 용량까지 확보하려면 D램 다이를 옆으로 늘어놓기보다 TSV(실리콘관통전극)로 수직 적층하는 편이 면적 효율이 훨씬 높았고, 이렇게 만들어진 HBM 스택들을 GPU 가까이 배치하기 위해 인터포저가 쓰이게 됐다. 즉 "인터포저 공간 부족이 HBM 적층의 출발점"이라는 통념은 절반만 맞는 설명이며, 실제로는 HBM 확장이 거듭되면서 인터포저·패키지 면적이 나중에 새로운 제약으로 떠오른 것이라고 화자는 바로잡는다(영상 09:03).
- 쇼라인(Shoreline) 병목 — GPU 가장자리 공간의 한계: HBM 스택을 GPU에 붙이려면 GPU 쪽에도 수천 개의 신호를 받아줄 입출력 회로가 필요하고, 이 회로는 주로 칩의 가장자리(업계 용어로 "쇼라인")를 차지한다. 그런데 칩 둘레 길이는 무한정 늘릴 수 없고, 이 한정된 공간을 HBM뿐 아니라 GPU 간 고속 연결, CPU IO, 향후 광학 IO까지 나눠 써야 한다. 그래서 전체 대역폭 수치뿐 아니라 "칩 둘레 1mm당 얼마나 많은 데이터를 뽑아낼 수 있는가"를 뜻하는 밴드위스 덴서티(대역폭 밀도)가 핵심 지표로 부상했다. SK하이닉스가 올해 공개한 HBM에서 열 전달 경로를 별도로 만들어 열 저항을 약 30% 낮춘 것도 이런 적층 확장의 물리적 한계와 연결된 시도다.
- 디스어그리게이트 메모리(메모리 풀링) 아이디어: AI 추론에서 모델 자체와 KV캐시가 메모리를 계속 잡아먹으면서, GPU 연산력은 남아있는데 HBM 용량만 먼저 바닥나는 상황이 생길 수 있다. 그러나 HBM은 GPU와 한 패키지로 묶여 설계되기 때문에 서버 D램처럼 나중에 추가로 꽂을 수 없고, 용량이 부족하면 처음부터 더 큰 HBM을 탑재한 GPU를 사거나 GPU 자체를 더 투입해야 한다. 이 문제의 해법으로 논문이 제시하는 것이 GPU(XPU) 풀과 메모리 풀을 물리적으로 분리해 각각 필요한 만큼 독립적으로 늘리는 "디스어그리게이트 메모리(메모리 풀링)" 구조다(영상 약 08:05 부근).
- 왜 광학 연결이 필요한가 — 구리 배선의 거리 한계: 메모리를 GPU에서 떼어내면 HBM이 갖던 짧은 연결 거리(수 mm)의 이점도 함께 사라진다. 거리가 수십 cm에서 수 m로 늘어나면 구리 배선(패키지 내부 배선, PCB 트레이스, 서버 간 케이블 포함)에서는 주파수가 높아질수록 손실이 커지고, 앞선 비트의 흔적이 뒤 비트에 섞이는 신호 왜곡, 인접 배선 간 크로스토크가 급격히 악화된다. 화자는 구글 플로우로 제작한 비교 영상을 통해 구리 배선은 거리가 늘수록 신호 품질이 떨어지지만 광섬유는 동일 거리를 손상 없이 통과하는 모습을 시각적으로 보여준다(영상 약 15:52). 광학 연결은 전기-광 변환 비용이 있지만, 일단 빛으로 바뀐 뒤에는 거리가 늘어나도 손실·간섭이 크게 줄고 파장다중화로 대역폭도 늘릴 수 있어 장거리·고대역폭 조건에서 유리해진다.
- 논문이 제시하는 성능 목표와 CXL과의 관계: 논문에 인용된 추세에 따르면 연산 성능은 2년마다 약 3배씩 늘었지만 인터커넥트 대역폭은 같은 기간 약 1.4배 증가에 그쳤다. 이 격차를 메우기 위해 논문은 차세대 인터커넥트의 장기 목표로 100Tbit/s 이상 대역폭, 비트당 1피코줄 미만 에너지, 10나노초 미만 칩간 지연시간을 제시한다(단순 계산 시 100Tbit/s를 비트당 1피코줄로 옮기면 약 100W 규모 전력에 해당). CXL과 비교하면, HBM4 한 스택이 이미 3TB/s를 넘고 HBM4E는 약 4TB/s에 이르는 반면 CXL 4.0 x16 링크 하나는 한 방향 기준 약 256GB/s 수준으로 목표로 하는 데이터 이동 규모 자체가 다르다. CXL은 메모리를 "어떻게 발견·공유·접근할지" 정하는 프로토콜이고, 광학 연결은 그 데이터를 "물리적으로 어떻게 옮길지" 담당하는 계층이라 두 기술은 대체 관계가 아니라 CXL 프로토콜을 광학 링크 위에 얹는 조합도 가능한 보완 관계다(영상 약 13:46).
- 물리적 한계와 남은 과제 — 이 논문의 성격: 전기 링크를 광섬유로 바꿔도 원격 메모리가 로컬 HBM과 완전히 동등해지지는 않는다. 빛은 광섬유에서 1m 이동에 약 5나노초가 걸리므로 GPU에서 1m 떨어진 메모리는 왕복 전파 시간만 약 10나노초가 추가되고, 여기에 전기-광 변환 시간과 메모리 컨트롤러 처리 시간까지 더해진다. 그래서 실제 시스템은 GPU 바로 옆의 가장 빠른 로컬 HBM부터 더 멀리 있는 대용량 풀드 메모리까지 속도·용량에 따라 계층화될 가능성이 높다. 화자는 이번 Nature Electronics 논문이 새로운 광학 메모리 제품 발표가 아니라 CPO와 옵티컬 컴퓨트 인터커넥트 기술을 정리하고 향후 연구 방향을 제시한 "리뷰 논문"이며, 실제 제품화까지는 패키징·열 제어·표준화·신뢰성 등 넘어야 할 단계가 많이 남아있다고 정리한다.
03기술적 맥락
이 영상의 핵심은 SK하이닉스가 GPU용 통신 기술(CPO)을 연구하는 이유를 HBM 발전사의 연장선에서 설명하는 데 있다. HBM은 "짧은 거리 + 많은 신호선"이라는 와이드 IO 철학으로 대역폭 문제를 풀어왔지만, GPU 가장자리(쇼라인)라는 물리적 공간의 한계에 부딪히고 있다. 논문이 제안하는 CPO 기반 메모리 풀링 구조는 HBM을 없애는 것이 아니라, GPU 패키지 안에 모든 고성능 메모리를 욱여넣어야 한다는 제약에서 벗어나 일부 메모리를 광학 인터커넥트로 떨어뜨려 배치하려는 시도다. 다만 광섬유의 물리적 전파 지연(약 5ns/m), 전기-광 변환 비용, 메모리 풀 자체의 병렬 대역폭 확보 필요성 등은 여전히 해결해야 할 과제로 남아있다.
04전략적 의미
첫째, HBM의 미래를 "언제 사라지는가"가 아니라 "GPU에서 얼마나 많은 메모리를 얼마나 멀리 떼어내도 AI 성능을 유지할 수 있는가"라는 질문으로 재정의해야 한다는 점이 이번 논문의 가장 큰 관점 전환이다. 둘째, 메모리 회사인 SK하이닉스가 광학 인터커넥트(CPO) 연구에 뛰어든 것은 향후 HBM 매출이 "적층 경쟁"뿐 아니라 "메모리 풀 + 광학 연결" 생태계 전체로 확장될 수 있음을 시사하며, 메모리 기업의 사업 범위가 광학 부품·패키징 영역까지 넓어질 가능성을 보여준다. 셋째, CXL과 광학 인터커넥트가 경쟁이 아닌 계층적 보완 관계로 발전할 경우, AI 데이터센터의 메모리 아키텍처는 "로컬 HBM - 근거리 광학 풀 - CXL 기반 원격 메모리"의 다단계 계층으로 재편될 가능성이 있다. 넷째, 이 논문이 리뷰 논문 성격이라는 점은 아직 상용화 시점을 예단하기 이르다는 뜻이며, 투자·산업 분석 시에는 "기술 방향성 제시" 단계와 "제품 양산" 단계를 구분해서 봐야 한다.
05핵심 워크플로우 또는 비교표
| 구분 | 로컬 HBM (기존 방식) | 광학 인터커넥트 기반 메모리 풀 (논문 제안) |
|---|---|---|
| 배치 위치 | GPU 패키지 내부, 수 mm 이내 | GPU 패키지 외부, 수십cm~수m 거리 |
| 연결 방식 | 전기 신호(와이드 IO, 수천 개 병렬 신호선) | 광학 신호(전기-광 변환 후 광섬유 전송) |
| 대역폭 수준 | HBM4 한 스택 3TB/s 초과, HBM4E 약 4TB/s | 논문 장기 목표 100Tbit/s 이상 |
| 확장 제약 | GPU 가장자리(쇼라인) 면적 한정, 패키지와 한 세트로 묶임 | 별도 배치 가능해 용량 확장 자유도 높음 |
| 지연 시간 | 매우 짧음(물리적으로 인접) | 광섬유 전파 지연 추가(1m당 약 5ns, 왕복 약 10ns) + 변환 비용 |
| 유사 기술과의 관계 | - | CXL과는 대체가 아닌 보완(프로토콜 vs 물리 전송 계층) |
06활용 시나리오
- 반도체/메모리 산업 분석가: HBM 적층 경쟁이 한계에 부딪힐 시점과 메모리 풀링·광학 인터커넥트 기술이 상용화되는 시점을 함께 추적해, SK하이닉스 등 메모리 기업의 중장기 사업 포트폴리오 변화(광학 부품·패키징 진출 여부)를 예측하는 데 참고할 수 있다.
- AI 인프라/데이터센터 설계 담당자: GPU 클러스터 설계 시 "GPU당 HBM 용량 고정" 방식과 "메모리 풀 공유" 방식의 트레이드오프(지연시간 vs 용량 확장성)를 검토하는 참고 자료로 활용할 수 있다.
- 투자자/증권 애널리스트: CPO 기술이 실제 제품이 아닌 리뷰 논문 단계임을 인지하고, 관련 테마주(광통신 부품, 코패키지드 옵틱스 관련 기업)에 대한 투자 시점을 "연구 발표"와 "양산 로드맵 공개"를 구분해 판단하는 데 활용할 수 있다.
- 반도체 엔지니어/연구자: 밴드위스 덴서티(대역폭 밀도), 비트당 에너지(피코줄/비트) 등 논문이 제시한 핵심 성능 지표를 후속 연구나 사내 로드맵 수립 시 벤치마크로 참고할 수 있다.
07현황 및 전망
2026년 8월 19일 Nature Electronics에 게재된 이번 논문은 SK하이닉스 연구진이 참여했지만 신제품 발표가 아니라, GPU와 메모리를 광학 인터커넥트로 연결하는 CPO(코패키지드 옵틱스) 기술의 연구 방향을 정리한 리뷰 논문이다. HBM은 HBM4(2048개 데이터 IO), HBM4E(약 4TB/s) 등으로 계속 발전 중이며 16단 적층과 커스텀 HBM, HBM5도 이어질 예정이지만, 동시에 GPU 가장자리 공간(쇼라인) 제약이 새로운 병목으로 부상하면서 메모리 일부를 광학 연결로 GPU 밖에 배치하는 "메모리 풀링" 구조가 장기 연구 방향으로 제시됐다. 화자는 실제 제품화까지 패키징, 열 관리, 표준화, 신뢰성 확보 등 넘어야 할 단계가 많이 남아있다고 강조하며, 앞으로 주목할 지점은 "HBM이 언제 사라지는가"가 아니라 "GPU에서 메모리를 얼마나 떼어내도 AI 성능을 유지할 수 있는 범위가 얼마나 넓어지는가"라고 결론짓는다.
08용어 사전
| 용어 | 한줄설명 | 비유 |
|---|---|---|
| CPO(코패키지드 옵틱스) | 반도체 칩 가까이에 광통신 부품을 직접 결합해 칩 간 데이터를 빛으로 주고받는 기술 | 컴퓨터 칩 옆에 작은 광케이블 정거장을 붙이는 것 |
| HBM(고대역폭 메모리) | D램을 수직으로 쌓아 GPU 바로 옆에 배치해 대역폭을 극대화한 메모리 | 고속도로 차선을 수천 개로 늘려 짧은 구간에 많은 차를 보내는 것 |
| 쇼라인(Shoreline) | GPU 칩 가장자리에서 외부 입출력 신호를 처리하는 한정된 공간 | 항구의 부두 길이 — 아무리 배가 많아도 정박할 부두 공간은 한정됨 |
| 디스어그리게이트 메모리(메모리 풀링) | GPU와 메모리를 한 세트로 묶지 않고 각각 독립적으로 확장 가능하게 분리하는 구조 | 회사에서 개인 서랍 대신 공용 창고를 두고 필요할 때마다 꺼내 쓰는 방식 |
| 밴드위스 덴서티(대역폭 밀도) | 칩 둘레 단위 길이(예: 1mm)당 처리할 수 있는 데이터 전송량 | 부두 1m당 하역할 수 있는 화물량 |
| CXL | 외부 메모리를 CPU/가속기에 연결해 용량을 확장하고 여러 장치가 공유하게 해주는 프로토콜 | 여러 사무실이 공용 창고를 예약·사용하는 규칙 |
| TSV(실리콘관통전극) | D램 칩을 수직으로 쌓을 때 층간 신호를 전달하기 위해 칩을 관통시키는 미세 배선 | 여러 층 건물을 관통하는 엘리베이터 통로 |