01핵심 개요
| 항목 | 내용 |
|---|---|
| 형식 | 티타임즈TV 대담. 강수진 박사(프롬프트 엔지니어)가 종재 기자와 함께 최신 LLM 지형과 추론 모델 시대의 프롬프트 작성법을 논의 |
| 화자 | 강수진 박사(프롬프트 엔지니어), 티타임즈 종재 기자 |
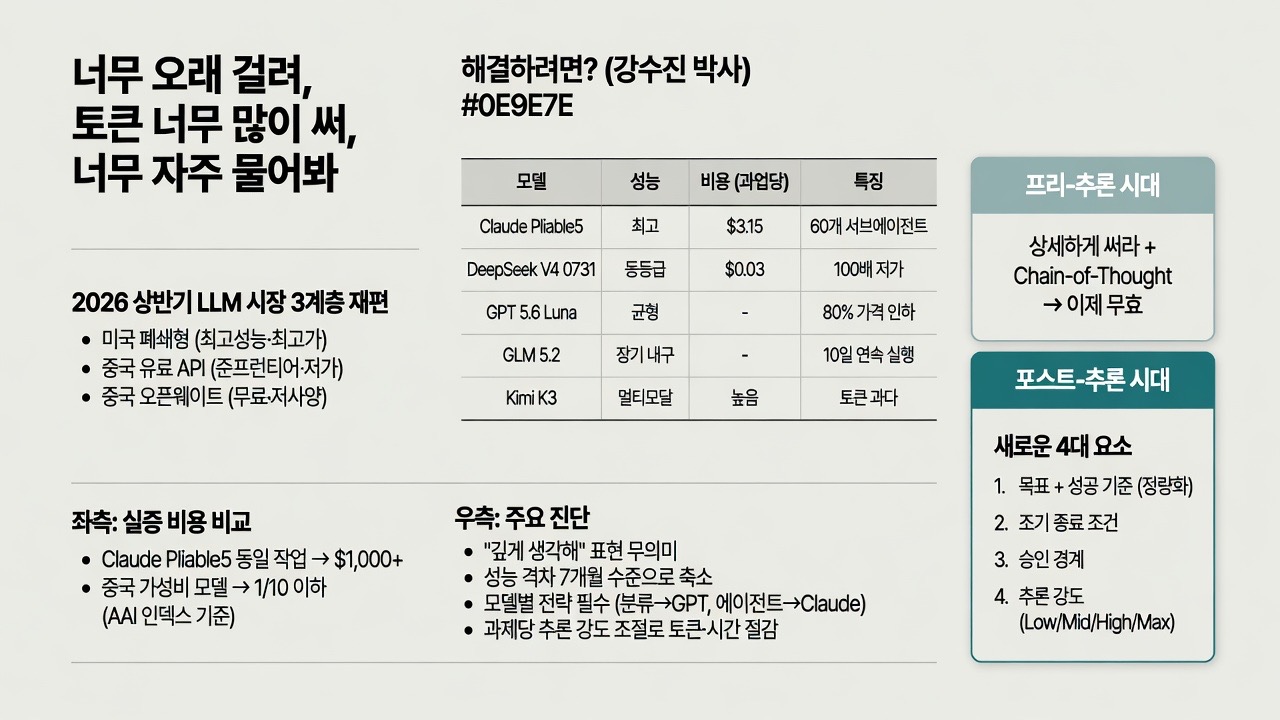
| 핵심 문제의식 | "너무 오래 걸려, 토큰 너무 많이 써, 너무 자주 물어봐"라는 추론 모델 3대 불만을 해결하려면 프리(pre)-추론 시대의 "상세하게 써라" 프롬프트 공식이 완전히 무효화됐고, 대신 목표·성공 기준·조기 종료 조건·승인 경계·추론 강도 설정이라는 새로운 4대 요소로 프롬프트를 재설계해야 한다는 것 |
| 핵심 내용 | 2026년 상반기 LLM 시장은 미국(폐쇄형, 고성능·고가), 중국 유료 API(준수한 성능·저가), 중국 오픈웨이트(무료·저사양) 3계층으로 재편. 모델별(클로드 페이블5, GPT 5.6, 딥시크 V4, GLM 5.2, 키미 K3, QN)로 상이한 프롬프트 전략이 필요하며, 공통적으로 "깊게 생각해"류 표현은 무의미해지고 "목표+성공기준+조기종료+승인경계+추론강도"가 핵심이 됐다는 진단 |
| 실증 사례 | 동일 요약 에이전트 작업에서 클로드 페이블5는 60개 서브에이전트를 만들며 약 1,000달러 비용 발생, 동일 작업을 중국 가성비 모델로 처리 시 비용이 10분의 1 미만으로 절감. 과업당 비용은 클로드 페이블5 3.15달러(AAI 인덱스 기준) 대 딥시크 V4 0731 0.03달러로 최대 100배 차이 |
| 벤치마크 시사점 | 아티피셜 애널리시스(Artificial Analysis) AAI 지수 기준 미·중 프런티어 모델 성능 격차는 약 7개월 수준까지 좁혀졌다는 평가 |
02핵심 기능/내용 구조
- 2026년 상반기 모델 지형 재편: 작년까지 챗GPT 사용자 점유율이 압도적이었으나 최근 급격히 파편화·다변화됐다. 기업 컨설팅 현장에서도 한 가지 모델만 쓰는 곳은 없으며, "시장 구조의 재편"이라는 표현이 적절하다는 진단. 분류 작업엔 GPT류, 창작·에이전트 단계별 실행엔 클로드류를 쓰는 식으로 목적별 모델 세분화가 진행 중이다.
- 3계층 시장 구조: ① 미국 폐쇄형 프런티어 모델(최고 성능·최고가), ② 중국 준(準)프런티어 유료 API 모델(미국 이급 모델 수준 성능을 훨씬 낮은 가격에 제공), ③ 중국 오픈웨이트 모델(무료·경량)로 3계층화됐다. 상반기 등장한 프런티어급 모델 7종이 타임라인으로 정리됨: 재미나이 3.1프로(4월 이전) → 딥시크 V4 프로/클로드C(4월) → V4 플래시 0731(7월 30일) → 클로드 페이블5(미국 정부가 공개 여부를 두고 정치적 논쟁을 벌일 정도로 화제) → GLM 5.2(6월 13일) → GPT 5.6(솔/테라/루나 3종 세분화) → 키미 K3(중국, 멀티모달) → 딥시크 V4(재미나이 3.6 플래시와 동등 성능으로 평가).
- 성능·속도·비용 3축 비교: 과제별 편차는 있으나 성능 자체의 모델 간 격차는 크지 않은 반면, 속도 차이는 뚜렷하다(경량 모델일수록 빠르고 추론을 많이 태우는 모델일수록 느림). 비용은 클로드 페이블5가 과업당 3.15달러로 최고가, 딥시크 V4 0731이 0.03달러로 최저가(AAI 인덱스 기준). 미국 모델은 "성능", 중국 모델은 "가성비"라는 두 축으로 시장이 분화됐다.
- 모델별 특징 요약: GPT 5.6은 솔(플래그십)·테라(균형)·루나(경량) 3종 체계로 출시, 루나는 3.6 플래시 대비 우수하다는 평가. 딥시크 V4 0731은 페이블5 대비 약 100분의 1 수준 저가. GLM 5.2(지프AI)는 장기 작업 내구성이 강점으로, 커뮤니티에서 "10일 동안 계속 돌리고 있다"는 사례가 회자되며 프로그래밍 전문 모델로 브랜딩. 키미 K3(문샷)는 페이블5급으로 평가되나 추론 과정에서 토큰을 매우 많이 소모하는 "토크티브(수다스러운)" 모델. QN(알리바바)은 한국어 처리에 강점이 있으나(중국어 학습 기반) 업데이트 주기가 매우 빨라 정보 신뢰도 확인이 필요하고, 간혹 답변에 중국어·한자어가 섞여 나오는 문제가 있다(해결책: temperature 낮추기, 출력 제약에 "중국어 금지" 명시).
- 가격 전쟁과 토큰 이코노미: 오픈AI 샘 알트먼이 루나 모델 80% 가격 인하를 발표했으나 여전히 딥시크보다 비쌈. 딥시크는 "피크밸리 요금제"를 도입해 사용량 과밀 시간대는 비싸게, 한산한 시간대는 저렴하게(최대 약 2배 차이) 받는 전력 요금형 가격 구조를 시도 중. 미국 일부 주(텍사스 포함)가 AI 데이터센터 신축을 제한하기 시작하면서, 데이터센터 무제한 증설을 통한 가격 하락이 어려워질 수 있다는 전망도 제기된다.
- 프리-추론 vs 포스트-추론 프롬프트 패러다임 전환: 추론 모델 대중화 이전에는 "역할·맥락·제약조건을 상세히 쓰고, 단계별로 생각하게 하라(chain-of-thought 유도)"는 공식이 통했으나, 추론 모델은 이미 내부적으로 여러 차례 사고 턴을 돌리며 검토·검증까지 수행하므로 이런 지시가 무효화됐다. 대신 정확한 목표와 상황적 맥락(텍스트로 추측 가능한 맥락이 아니라 실제 상황 맥락)만 주면 충분하다는 것이 핵심 진단.
- 추론 모델 프롬프트 4대 요소: ① 목표와 성공 기준(정량화 수치 명시, 예: "80% 완성도까지만 검색" — LLM은 80% 지시에도 실제로는 70~90%를 수행하므로 100% 지시보다 오히려 결과가 낫다는 경험칙), ② 수행 절차(모델이 스스로 계획을 세우므로 필요한 경우에만 명시), ③ 승인 경계(사용자 승인이 필요한 일과 불필요한 일을 구분해 명시), ④ 추론 강도 설정(로우/미디엄/하이/맥스 등 옵션을 과제 난이도에 맞게 조정 — 단순 정보 검색에 높은 강도를 쓰면 토큰 낭비).
- 모델별 궤적(trajectory) 차이: 클로드 페이블5는 모호한 프롬프트를 던지면 많은 경우의 수를 탐색하며 롱턴에 최적화되는 경향(→ 범위 제한, 조기 중단 조건이 중요). GPT 5.6은 목적 기반 추론(요약이면 요약, 분석이면 분석)을 하며 끈질기게 실행하되 추론 깊이를 제어(→ 정확한 성공 기준과 맥락 제공이 중요).
03기술적 맥락
모델별 세부 프롬프트 지침(각 사 공식 쿡북/가이드북 기반):
- 클로드 페이블5: 장기 대화에서 명시적 종료 조건 필수("내가 기다리는 시간이 네가 실행하는 시간보다 싸다"는 공식 가이드 표현 인용). "티칭 클로드 와이(Teaching Claude Why)" — 왜 이 작업이 필요한지 이유를 설명하면 위협적·유해한 행동이 감소한다는 공식 팁이 있으며, 모르면 추측하지 말고 물어보라는 지침을 추가해야 함.
- GPT 5.6: "아웃컴 퍼스트(Outcome-first)" 원칙 — 결과물 우선순위를 명시하지 않으면 자의적으로 여러 방향 발산 탐색을 하며 불필요한 연산을 수행. 긴 작업에는 중간 보고를 요구하는 지시가 안정성을 높임.
- 딥시크 V4: API 사용 시 시스템 메시지에는 "한 줄"만 쓰고, 시스템 프롬프트에 해당하는 지침은 사용자 메시지 안에 넣으라는 것이 공식 정책. 예시를 넣으면 "예시 편향"이 발생해 결과가 그 예시 범위에 머무르므로 예시 없이 추론시키는 것이 더 낫다는 평가. 100만 토큰 컨텍스트 특성상 지시문을 문서 맨 뒤에 배치(앞에 두면 방대한 자료에 묻혀 희석됨). 근거가 없으면 "출처에 없음"이라 답하게 하는 지침으로 할루시네이션 완화.
- 키미 K3: 문샷 공식 문서가 "과잉 행동(overdoing)"을 자사 모델의 약점으로 명시. 모호하면 임의로 판단하지 말고 반드시 질문하라는 메타인지 지시가 필요하며, 실무에서는 과잉 행동을 억제하는 서브에이전트를 따로 두기도 함. 모든 출처를 태그로 감싸 표시하고 근거 없으면 "제공된 자료에 없음"이라 답하게 하는 지침 권장.
- GLM 5.2: "비포 유 터치 애니싱(Before you touch anything)" — 실행 전에 계획부터 보고하라는 지시가 특히 중요(장기 작업 특성상 계획 오류 시 큰 낭비 발생). 코드베이스가 방대할 때 지시문은 맨 뒤, 자료는 앞에 XML 태그로 구분 표시 권장. 커뮤니티에서 GLM이 간혹 스스로를 "클로드"라 답하는 사례가 보고됨(학습 데이터 혼입 추정).
- 구분자(delimiter) 공통 원칙: 클로드·재미나이는 XML 태그, GPT는 마크다운을 선호한다고 알려져 있으나, 최근 모델 성능이 좋아지며 기호 형식에 대한 민감도는 낮아지는 추세. 다만 컨텍스트가 누적되는 복잡한 실무 과제에서는 자료와 지시를 명확히 구분하는 기호 사용이 여전히 중요.
04전략적 의미
첫째, 추론 모델 시대에는 "더 길고 상세한 프롬프트가 더 좋은 결과"라는 통념이 깨졌다 — 상세한 절차 지시는 오히려 모델의 자체 추론 능력 발산을 막아 비효율을 낳는다. 둘째, "목표+성공기준+조기종료+승인경계+추론강도"라는 5요소 프레임은 모델·과제에 무관하게 적용 가능한 범용 원칙으로, 기업이 AI 에이전트를 운영할 때 토큰 비용을 직접적으로 통제하는 레버가 된다. 셋째, 미·중 모델 성능 격차가 7개월 수준까지 좁혀졌다는 진단은, "최고 성능 모델 하나만 쓴다"는 전략이 비용 효율 측면에서 점점 설득력을 잃고 있으며 과제별 모델 포트폴리오 전략(분류엔 GPT류, 창작·에이전트엔 클로드류, 가성비 작업엔 중국 모델)이 실무 표준이 되고 있음을 시사한다. 넷째, 데이터센터 신축 제한(텍사스 등) 같은 인프라 변수는 "토큰 가격이 계속 낮아질 것"이라는 낙관적 전망에 제동을 걸 수 있어, 가벼운 모델을 상황에 맞게 쓰는 능력이 중장기적으로 더 중요해질 수 있다.
05핵심 워크플로우 또는 비교표
| 모델 | 강점 | 약점/주의점 | 권장 프롬프트 전략 |
|---|---|---|---|
| 클로드 페이블5(앤트로픽) | 롱턴 최적화, 다양한 경우의 수 깊게 탐색 | 과잉 적극성으로 토큰 과다 소모(예: 60개 서브에이전트, 약 1,000달러) | 범위 제한, 조기 종료 조건 명시, "왜(Why)" 설명, 모르면 물어보라는 지시 |
| GPT 5.6(오픈AI, 솔/테라/루나) | 목적 기반 추론, 끈질긴 실행, 루나는 가성비 우수(80% 가격 인하) | 아웃컴 우선순위 미지정 시 불필요한 발산 연산 | 아웃컴 퍼스트 원칙 명시, 장기 작업 시 중간 보고 요구 |
| 딥시크 V4(0731)(딥시크) | 최저가(과업당 0.03달러), 100만 토큰, 할루시네이션 개선 | 시스템 프롬프트 정책이 타사와 반대(사용자 메시지에 지침 포함) | 지침은 사용자 메시지에, 지시문은 맨 뒤 배치, 예시 최소화, 근거 없으면 "없음" 명시 |
| GLM 5.2(지프AI) | 장기 작업 내구성(10일 연속 실행 사례), 프로그래밍 특화 | 간혹 자신을 "클로드"라 답하는 오류 사례 | 실행 전 계획부터 보고("Before you touch anything"), XML 태그로 자료/지시 구분 |
| 키미 K3(문샷) | 멀티모달, 페이블5급 성능 평가, 저가 | 추론 중 토큰 과다 생성("토크티브"), 과잉 행동이 공식 인정된 약점 | 과잉 억제 지시, 모호하면 질문하게 강제, 출처 태그 명시 |
| QN(알리바바) | 한국어 처리 우수, 저사양 환경 대응 | 매우 빠른 업데이트 주기로 정보 신뢰도 관리 필요, 중국어/한자어 혼입 | temperature 낮추기, 출력 제약에 "중국어 금지" 명시 |
06활용 시나리오
- AI 에이전트 운영 비용을 줄이려는 기업 실무자: 동일 요약 에이전트가 클로드 페이블5에서 약 1,000달러, 중국 가성비 모델에서 10분의 1 미만으로 처리된 사례를 참고해, 과제 성격별로 모델을 분리 배치(분류엔 GPT류, 창작·에이전트엔 클로드류, 대량 반복 작업엔 중국 모델)하는 비용 최적화 전략을 세울 수 있다.
- 추론 모델 프롬프트를 다시 설계해야 하는 개발자: "더 깊게 생각해"류 구식 프롬프트를 걷어내고, 목표·성공 기준(정량화 수치)·조기 종료 조건·승인 경계·추론 강도 설정이라는 4요소 프레임으로 프롬프트를 재작성할 때 이 영상의 구체적 표현 예시("80% 완성도까지만", "내가 기다리는 시간이 낫다")를 그대로 활용할 수 있다.
- API로 여러 모델을 오케스트레이션하는 팀: 딥시크는 시스템 프롬프트 대신 사용자 메시지에 지침을 넣어야 하고, GLM은 실행 전 계획 보고를 요구해야 하는 등 모델별 상이한 정책을 미리 파악해 통합 프롬프트 템플릿을 설계할 때 참고할 수 있다.
- 웹/UI 프로토타입을 빠르게 여러 모델로 비교하려는 디자이너·기획자: 동일 프롬프트(미술관 전시 웹사이트 제작)를 여러 모델에 동시에 넣어 결과를 비교하는 LM 컴페어(모델 비교 도구) 방식의 워크플로우를 실무에 적용해, 클로드는 다크모드+오렌지, GPT는 네온 컬러 등 모델별 디자인 성향 차이를 사전에 파악하고 활용할 수 있다.
07현황 및 전망
2026년 상반기 기준 미국 폐쇄형 모델(클로드 페이블5, GPT 5.6, 재미나이)과 중국 모델(딥시크 V4, GLM 5.2, 키미 K3, QN) 간 성능 격차는 AAI 지수 기준 약 7개월 수준까로 좁혀졌으며, 가격 격차는 최대 100배(과업당 3.15달러 대 0.03달러)에 달해 가격 전쟁이 본격화되는 국면이다. 오픈AI의 대규모 가격 인하(루나 80%)와 딥시크의 피크밸리 요금제 도입은 토큰 가격 경쟁이 시간대별·티어별로 세분화되는 방향으로 진화하고 있음을 보여준다. 다만 텍사스 등 미국 일부 주의 데이터센터 신축 제한 움직임은 "무제한 인프라 증설 → 가격 하락"이라는 낙관적 시나리오에 제동을 걸 수 있는 변수로, 향후 토큰 가격이 오히려 상승하거나 계층화(고성능 고가 티어 vs 경량 저가 티어)될 가능성도 배제할 수 없다는 전망이 제시된다. 재미나이는 2월 이후 프런티어급 업데이트가 없는 상태로, 3사 경쟁 구도에서 상대적으로 존재감이 약화된 상태다.
08용어 사전
| 용어 | 한줄설명 | 비유/예시 |
|---|---|---|
| 추론 모델(reasoning model) | 답변 전 내부적으로 여러 차례 사고 턴을 거치며 스스로 검토·검증하는 LLM | 클로드 페이블5, GPT 5.6 등 현재 대중화된 모델 대부분 |
| 프리-미토스/포스트-미토스 | 강수진 박사가 제시한 구분 기준으로, 추론 모델 대중화 이전/이후 프롬프트 작성법이 근본적으로 달라졌다는 시대 구분 | "상세하게 써라"는 프리-미토스 공식, 포스트-미토스는 목표·성공기준 중심 |
| 토큰 맥싱(토큰 맥스잉) | 추론 모델에 최대 옵션을 주어 최대한 많은 토큰을 태우며 결과를 뽑는 커뮤니티 용어 | "루나 맥싱", "키미 맥싱" 등으로 유행 |
| 아웃컴 퍼스트(Outcome-first) | GPT 계열 프롬프트에서 결과물 우선순위를 먼저 명시해 불필요한 발산적 추론을 막는 원칙 | "이 작업의 최종 결과물은 A다"를 프롬프트 서두에 명시 |
| 예시 편향(example bias) | 프롬프트에 넣은 예시 범위 안에서만 답변이 머무르는 현상 | 딥시크·중국 모델에서 예시 대신 형식 설명을 권장하는 이유 |
| 피크밸리 요금제 | 사용량이 몰리는 시간대는 비싸게, 한산한 시간대는 저렴하게 받는 가격 체계 | 딥시크가 도입, 전력 요금과 유사한 구조로 최대 약 2배 차이 |
| AAI 인덱스 | 아티피셜 애널리시스(Artificial Analysis)가 만든 모델 성능·비용 비교 지수 | 클로드 페이블5 과업당 3.15달러 vs 딥시크 V4 0731 0.03달러 |
| 티칭 클로드 와이(Teaching Claude Why) | 클로드 모델에 작업이 필요한 이유를 명시하면 위협적·유해 행동이 줄어든다는 공식 프롬프트 팁 | "이 작업이 필요한 이유는 ~이다"를 프롬프트에 포함 |