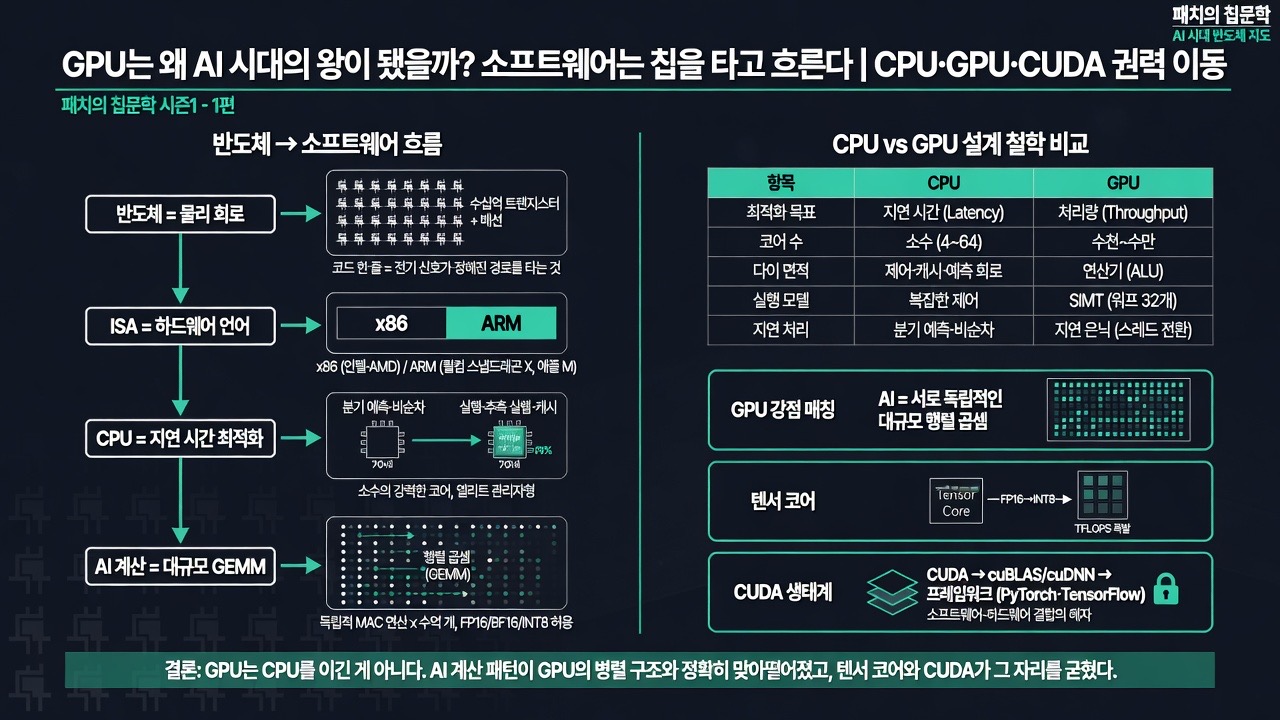
01핵심 개요
| 항목 | 내용 |
|---|---|
| 형식 | 안될공학 채널 신규 시리즈 "패치의 칩문학 시즌1: AI 시대 반도체 지도" 1편. 패치가 단독 진행하는 설명형 영상. |
| 화자 | 패치(진행자, 채널명 "패치의 칩문학" 코너 담당) |
| 핵심 문제의식 | "GPU가 왜 AI 시대의 왕이 됐을까?"라는 질문에 "병렬 계산을 잘해서"라는 답만으로는 부족하며, AI가 요구하는 계산 방식 자체가 바뀌었다는 근본 원인을 반도체는 하드웨어라는 관점 → ISA → CPU → AI 계산의 정체(행렬 곱셈) → GPU → CUDA → NPU 순서로 한 줄로 꿰어 설명. |
| 핵심 내용 | 반도체는 물리 회로이므로 소프트웨어는 결국 하드웨어 구조를 타야 한다. CPU는 지연 시간 최적화(범용성)에, GPU는 처리량 최적화(병렬성)에 최적화된 정반대 설계 철학을 가진다. AI 딥러닝 연산은 대부분 서로 독립적인 대규모 행렬 곱셈(GEMM)이라 GPU의 병렬 구조와 절묘하게 맞아떨어졌고, 여기에 텐서 코어와 CUDA 생태계가 더해지며 계산 권력이 CPU에서 GPU로 이동했다. |
| 시리즈 구조 | 시즌1 "AI 시대 반도체 지도"의 1편. 다음 2편은 HBM(메모리 병목)을 다루고, 3편에서 엔비디아·CUDA 생태계가 왜 칩보다 강한 해자인지를 본격적으로 파고들 예정이라고 예고. |
| 결론 한 줄 | GPU가 CPU를 그냥 이긴 게 아니라, AI라는 계산 패턴이 GPU의 병렬 구조와 맞아떨어졌고 텐서 코어가 그 강점을 키웠고 CUDA 생태계가 그 자리를 굳혔다. |
02핵심 기능/내용 구조
- 반도체는 하드웨어다: 칩 안에는 수십억~1천억 개에 가까운 트랜지스터(전기 신호를 켜고 끄는 스위치)가 복잡한 배선으로 연결되어 논리 회로를 이루고, 이 회로가 덧셈·곱셈·비교·저장·이동 같은 동작을 수행한다. 컴퓨터는 추상적인 마법 상자가 아니라 물리적으로 만들어진 회로 위에서만 움직이며, 소프트웨어는 결국 어딘가의 물리 회로를 타야 한다. 코드 한 줄이 실행된다는 건 칩 안에서 전기 신호가 정해진 배선과 논리 회로를 지나간다는 뜻이다.
- ISA(명령어 집합 구조) — 소프트웨어와 하드웨어 사이의 언어: CPU가 알아듣는 명령어의 문법으로, 같은 덧셈이라도 어떤 비트 패턴으로 표현할지, 메모리에서 값을 가져오는 명령의 형식, 조건 분기 명령의 형식 등을 정해놓은 약속이다. x86(인텔·AMD, 전통적 PC·서버 시장 중심)과 ARM(스마트폰·태블릿, 아이폰·안드로이드·애플 M시리즈)이 대표적인 두 계열이며, 단순 브랜드 차이가 아니라 소프트웨어-하드웨어 간 대화 언어 자체가 다르다. ARM 윈도우에서 x86 프로그램을 돌리려면 에뮬레이션/바이너리 번역이 필요하며(마이크로소프트의 프리즘, 애플의 로제타2가 대표 사례), 번역은 공짜가 아니므로 반도체 경쟁은 단순 속도가 아니라 ISA·OS 지원·기존 앱 호환·개발자 생태계까지 포함하는 문제다. PC용 ARM 칩 대표 사례로 퀄컴 스냅드래곤 X 시리즈가 언급된다.
- CPU = 지연 시간 최적화(범용성의 왕): CPU(중앙 처리 장치)는 운영체제 구동, 프로그램 실행, 입출력 처리, 네트워크 요청 등 예측하기 어려운 다양한 일을 처리하는 범용 장치다. 핵심 기술 6가지: ① 명령어 해석(비트 패턴을 회로 동작으로 변환) ② 제어 장치(연산 순서·유닛·저장 위치를 조율하는 "교통 관제탑") ③ 캐시(코어 옆의 고속 메모리, L1<L2<L3 계층으로 속도-용량 타협) ④ 분기 예측(조건문 분기 시 다음 명령을 미리 예측해 파이프라인이 멈추지 않게 함, 틀리면 되돌아감) ⑤ 비순차 실행(먼저 처리 가능한 명령을 순서 재배치해 유휴 연산기 최소화) ⑥ 추측 실행(예측한 경로를 미리 실행, 멜트다운·스펙터 취약점이 이 기술과 관련). 이런 판단 회로에 트랜지스터 면적을 많이 쓰기 때문에 CPU는 "소수의 강력한 코어"로 복잡한 일을 처리하는 칩이 된다(비유: 회사의 엘리트 관리자 몇 명).
- AI 계산의 정체 = 대규모 행렬 곱셈(GEMM): 딥러닝은 문장·이미지·음성을 숫자로 바꿔 행렬(숫자가 빽빽한 표) 형태로 곱하고 더한다. 이 일반 행렬 곱셈을 업계에서는 GEMM이라 부르며, 이를 잘게 쪼갠 최소 단위가 곱셈-누적(MAC, multiply-accumulate)이다. AI 칩의 성능 지표인 TFLOPS는 초당 이 연산을 몇 번 수행하는지를 나타낸다. 결정적 특징은 이 수많은 MAC 연산이 상당 부분 서로 독립적이라는 점 — 한 칸의 답을 내는 데 옆 칸의 결과를 기다릴 필요가 없어 동시 처리(병렬성)가 가능하다. 또한 AI 신경망은 수치 오차에 관대해 저정밀도 연산(FP32→FP16/BF16 혼합 정밀도로 학습, INT8/FP8까지 낮춰 추론)을 적극 활용할 수 있어 비트 수를 줄여 더 많은 연산을 더 빠르게 처리한다.
- GPU = 처리량 최적화(병렬 계산의 왕): GPU(그래픽 처리 장치)는 원래 게임 화면의 수백만 픽셀을 각자 독립적으로 계산하는 병렬 문제를 풀기 위해 설계됐다. CPU와 정반대 철학 — 다이 면적 대부분을 제어·캐시가 아니라 연산기에 쏟아부어 단순 코어를 수천 개 배치했다. 실행 모델은 SIMT(단일 명령, 다중 스레드)이며, 엔비디아 GPU에서는 스레드 32개 묶음(워프)이 같은 명령을 동시 수행하고, 코어·스케줄러·공유 메모리를 묶은 연산 블록을 SM(스트리밍 멀티프로세서)이라 부른다. CPU가 캐시·예측으로 지연을 줄이는 반면 GPU는 한 무리의 스레드가 데이터를 기다리면 즉시 다른 무리로 전환해 연산기를 놀리지 않는 지연 은닉 방식을 쓴다. 2017년 볼타(Volta) 세대부터 탑재된 텐서 코어는 작은 행렬 블록의 곱셈-누적을 한 번의 동작으로 처리하며 혼합 정밀도를 하드웨어로 지원해 GEMM 가속을 한 단계 더 끌어올렸다.
- CUDA = GPU를 실제로 쓸 수 있게 만든 작업 운영 체계: 엔비디아가 만든 GPU 범용 계산 플랫폼으로, 개발자가 스레드 배치·메모리 이동·연산 순서를 손수 다루지 않아도 되게 감싸준다. 소프트웨어 스택 구조는 GPU 하드웨어 → 드라이버 → CUDA 런타임(컴파일러) → 라이브러리(cuBLAS, cuDNN, NCCL 등) → 파이토치/텐서플로 같은 프레임워크 순으로 층을 이룬다. CUDA 위에 연구자-프레임워크-클라우드-기업 인프라가 서로 맞물리는 선순환 생태계가 쌓이면서 엔비디아 GPU가 AI의 기본 플랫폼으로 굳어졌다. 엔비디아의 진짜 해자는 칩 자체가 아니라 GPU(공장)와 CUDA(작업 지시 체계) 및 그 위 생태계 전체라는 점이 강조된다(엔비디아·CUDA 해자의 상세 분석은 3편 예고).
- NPU = 효율의 왕: NPU(신경망 처리 장치)는 자주 쓰이는 AI 연산을 더 적은 전력으로 처리하는 전용 회로로, 스마트폰·노트북의 사진 보정·음성 인식·배경 흐림·실시간 번역 같은 온디바이스 AI에 적합하다. 대표 내부 구조는 시스톨릭 어레이(곱셈-누적 유닛을 격자로 배열해 데이터가 심장 박동처럼 흐르며 재사용되는 방식, 구글 TPU가 대표 사례)이며, 성능은 TOPS(초당 조 단위 연산)와 전력당 효율을 뜻하는 와트당 TOPS로 측정한다. 다만 특정 연산에 맞춰 회로가 고정된 주문형 반도체에 가까워 GPU만큼 자유롭게 프로그래밍하기 어렵다는 트레이드오프가 있다.
03기술적 맥락
프로그래머빌리티(얼마나 다양한 일을 자유롭게 시킬 수 있는가)를 하나의 축으로 놓으면, 왼쪽 끝의 CPU는 가장 범용적이지만 AI 규모의 병렬 연산에는 코어 수가 너무 적고, 오른쪽 끝의 NPU/ASIC은 정해진 연산에는 가장 효율적이지만 변화에 취약하다. GPU는 그 사이에서 AI 규모를 감당할 만큼 병렬적이면서도 텐서 코어로 행렬 연산을 전용 가속하고, 새로운 모델 구조를 따라갈 만큼 프로그래밍이 자유로우며, 결정적으로 CUDA라는 소프트웨어 생태계까지 갖춘 절묘한 균형점에 위치한다. 이 영상은 "GPU가 병렬 계산을 잘해서 이겼다"는 통념적 설명을 넘어, ISA(하드웨어 언어)→CPU 설계 철학(지연 최적화)→AI 연산의 본질(독립적 행렬 곱셈)→GPU 설계 철학(처리량 최적화)→CUDA(소프트웨어 스택)까지 인과 사슬 전체를 연결해 설명하는 것이 핵심 차별점이다.
04전략적 의미
첫째, 반도체 경쟁력은 칩의 속도만이 아니라 ISA·OS 지원·기존 소프트웨어 호환성·개발자 생태계까지 포함하는 종합적 문제라는 점에서, 새로운 칩 아키텍처(예: 온디바이스 ARM 진영, 커스텀 AI 칩)가 시장에 진입하려면 하드웨어 성능 이상의 소프트웨어 스택 구축이 필수적이다. 둘째, AI 시대 계산 권력이 CPU에서 GPU로 이동한 근본 원인은 "AI가 요구하는 계산 패턴(대규모 독립적 행렬 곱셈)"과 "GPU의 설계 철학(처리량 최적화·대량 병렬 코어)"이 구조적으로 맞아떨어졌기 때문이며, 이는 특정 회사의 마케팅이 아니라 계산 패턴과 하드웨어 구조의 정합성 문제로 해석해야 한다. 셋째, 엔비디아의 경쟁 우위는 GPU 칩 자체보다 CUDA 소프트웨어 스택과 그 위에 쌓인 생태계(프레임워크 최적화, 라이브러리, 클라우드 인프라, 개발자 관성)에 있다는 점에서, 경쟁사가 따라잡으려면 칩 성능 경쟁을 넘어 생태계 전체를 복제해야 하는 훨씬 높은 진입장벽에 부딪힌다. 넷째, GPU·NPU 중 무엇을 쓸지는 "범용성이 필요한 대규모 학습·클라우드 추론(GPU)"과 "정해진 기능을 낮은 전력으로 반복하는 엣지 기기(NPU)"로 용도가 명확히 갈리므로, AI 인프라 설계 시 워크로드 성격에 따른 칩 선택 기준으로 활용할 수 있다.
05핵심 워크플로우 또는 비교표
| 구분 | CPU | GPU | NPU |
|---|---|---|---|
| 설계 철학 | 지연 시간 최적화 | 처리량(throughput) 최적화 | 전력 효율 최적화 |
| 코어 구성 | 소수의 강력한 코어 | 수천 개의 단순 연산 유닛 | 곱셈-누적 유닛의 격자(시스톨릭 어레이) |
| 지연 대응 방식 | 캐시(L1/L2/L3) + 분기 예측 + 비순차/추측 실행 | 지연 은닉(대기 스레드 무리를 즉시 다른 무리로 전환) | 데이터 격자 재사용(고정 회로) |
| 강점 영역 | 범용 처리, 예측 불가능한 조건 분기 | 대규모 학습, 클라우드 대규모 추론 | 온디바이스 AI(전력·발열 제한 환경) |
| 성능 지표 | 클럭·IPC 등 | TFLOPS(초당 곱셈-누적 횟수) | TOPS, 와트당 TOPS |
| 대표 예시/기술 | x86(인텔·AMD), ARM(애플 M시리즈) | 엔비디아 GPU, 텐서 코어(2017년 볼타 세대~), CUDA | 구글 TPU(시스톨릭 어레이), 스마트폰 NPU |
| 한계 | AI 규모 병렬 연산에 코어 수 부족 | 단일 작업 지연시간은 CPU보다 불리 | 프로그래밍 자유도 낮음(주문형 회로) |
| 한 줄 정의 | 범용성의 왕 | 병렬 계산의 왕 | 효율의 왕 |
06활용 시나리오
- AI 인프라 설계자의 칩 선택 기준 수립: 클라우드 대규모 학습·추론 워크로드는 GPU(범용성+병렬성+CUDA 생태계)를, 전력·발열이 제한된 엣지/온디바이스 AI 기능은 NPU를 선택하는 의사결정 기준으로 이 영상의 CPU/GPU/NPU 비교표를 활용할 수 있다.
- 반도체·AI 관련주 투자자의 밸류체인 이해: 엔비디아의 경쟁 우위가 GPU 칩 자체가 아니라 CUDA 소프트웨어 스택과 생태계(프레임워크·라이브러리·클라우드 인프라·개발자 관성)에 있다는 설명은, 경쟁사(AMD, 커스텀 ASIC 진영 등)의 실질적 진입장벽을 평가할 때 참고할 수 있다.
- 개발자의 아키텍처 이해 및 온보딩 자료: ISA(x86 vs ARM), 파이프라인/분기 예측/비순차 실행 같은 CPU 개념과 SIMT/워프/SM 같은 GPU 개념을 처음 접하는 개발자에게 물리 회로부터 소프트웨어 스택까지 이어지는 인과 구조를 설명하는 입문 교육 자료로 쓸 수 있다.
- 시리즈 후속편(HBM, 메모리 병목) 학습을 위한 선행 지식 확보: GPU가 아무리 연산을 잘해도 메모리 대역폭이 부족하면 "메모리 바운드" 상태에 빠진다는 이 영상의 마지막 문제 제기는, 다음 2편(HBM)과 3편(CUDA 해자) 시청 전 배경지식으로 활용할 수 있다.
07현황 및 전망
영상은 시즌1 "AI 시대 반도체 지도"의 1편으로, GPU가 AI 시대 계산의 왕이 된 이유(ISA→CPU 철학→AI 연산의 본질→GPU 철학→텐서 코어→CUDA 생태계)를 인과적으로 정리했다. 마지막에 "GPU가 아무리 계산을 잘해도 데이터를 제때 가져오지 못하면 멈춘다"는 메모리 병목(메모리 바운드) 문제를 제기하며, HBM(고대역폭 메모리)이 이 병목을 해소하는 핵심 부품이라는 점을 예고했다. 2편에서는 D램·대역폭·메모리 병목과 HBM이 왜 AI 시대의 핵심 부품이 됐는지를 다루고, 3편에서는 엔비디아·CUDA 생태계가 왜 칩 자체보다 강한 해자인지를 본격적으로 분석할 예정이라고 밝혔다. 결론적으로 AI 시대 반도체 지도의 첫 번째 권력 이동은 "CPU에서 GPU로, 범용 처리에서 병렬 계산으로, 단일 칩 경쟁에서 데이터센터 전체 시스템 경쟁으로"라는 세 축의 동시 전환으로 요약된다.
08용어 사전
| 용어 | 한줄설명 | 비유/예시 |
|---|---|---|
| ISA (Instruction Set Architecture) | 소프트웨어가 하드웨어에 명령을 내리는 문법 약속, 명령어 집합 구조 | x86(인텔·AMD), ARM(애플 M시리즈) — 같은 "덧셈"도 표현 방식이 다름 |
| x86 | 인텔·AMD CPU 계열의 ISA, 전통 PC·서버 시장 중심 | 윈도우 PC의 기본 명령어 체계 |
| ARM | 스마트폰·태블릿에서 강한 ISA 계열 | 아이폰, 안드로이드, 애플 M시리즈 칩 |
| 에뮬레이션/바이너리 번역 | 한 ISA의 명령을 다른 ISA가 이해할 수 있게 실시간 변환하는 것 | MS 프리즘(윈도우 on ARM), 애플 로제타2(인텔→애플 실리콘) |
| 파이프라인 | 여러 명령을 컨베이어 벨트처럼 겹쳐 처리해 처리 속도를 높이는 CPU 기법 | 공장 조립 라인처럼 명령 단계를 겹쳐 처리 |
| 분기 예측 | 조건 분기 시 다음에 실행될 명령을 미리 추측해 파이프라인 정지를 막는 기술 | 맞으면 시간 절약, 틀리면 되돌아가 다시 계산 |
| 비순차 실행 | 앞선 명령이 대기 중일 때 뒤의 독립적 명령을 먼저 처리해 유휴 연산기를 줄이는 기법 | 결과는 원래 순서로 재정렬해 출력 |
| 추측 실행 | 예측한 분기 경로를 실제로 미리 실행해보는 기법 | 멜트다운·스펙터 보안 취약점과 연관된 기술 |
| GEMM (General Matrix Multiplication) | 일반 행렬 곱셈, 딥러닝 핵심 연산 대부분이 이 형태로 구현됨 | 챗봇의 다음 단어 예측, 이미지 생성 AI의 연산 핵심 |
| MAC (Multiply-Accumulate, 곱셈-누적) | 두 수를 곱해 기존 합에 더하는 단일 동작, GEMM의 최소 단위 | AI 칩이 1초에 몇 번 하는지가 TFLOPS |
| TFLOPS | 초당 조 단위 부동소수점 연산(곱셈-누적) 횟수, AI 칩 성능 지표 | AI 칩 스펙시트에 표기되는 핵심 숫자 |
| 혼합 정밀도 (Mixed Precision) | 학습 시 FP16/BF16로 대부분 연산하고 핵심 부분만 FP32로 받치는 기법 | 추론 시엔 INT8·FP8까지 낮춰 속도·효율 극대화 |
| SIMT (Single Instruction, Multiple Threads) | 하나의 명령을 다수의 스레드가 동시에 실행하는 GPU 실행 모델 | 엔비디아 GPU에서 스레드 32개 묶음이 워프 |
| 워프 (Warp) | 엔비디아 GPU에서 같은 명령을 동시 수행하는 스레드 32개의 최소 단위 | SIMT 실행의 기본 단위 |
| SM (Streaming Multiprocessor) | 코어·스케줄러·공유 메모리를 묶은 GPU의 연산 블록 | GPU 내부의 "작은 공장 단위" |
| 지연 은닉 (Latency Hiding) | 한 스레드 무리가 데이터를 기다리면 즉시 다른 무리로 전환해 연산기를 놀리지 않는 GPU 기법 | CPU의 캐시·예측과 대비되는 GPU식 지연 대응 |
| 텐서 코어 (Tensor Core) | 작은 행렬 블록의 곱셈-누적을 한 번의 동작으로 처리하는 GPU 전용 유닛 | 2017년 엔비디아 볼타 세대부터 탑재, GEMM을 통째로 가속 |
| CUDA | 엔비디아가 만든 GPU 범용 계산 플랫폼, 개발자가 GPU를 계산 자원으로 쓰게 해주는 작업 체계 | "공장(GPU)을 굴리는 작업 지시서 체계" |
| CUDA 런타임 | 개발자 코드를 GPU 실행 형태로 바꿔주는 컴파일러 계층 | 소프트웨어 스택에서 드라이버 위, 라이브러리 아래 |
| cuBLAS | 행렬·벡터 계산을 빠르게 처리하는 CUDA 라이브러리 | 소프트웨어 스택의 라이브러리 계층 |
| NCCL | GPU 간 데이터를 주고받게 해주는 CUDA 통신 라이브러리 | 멀티 GPU 학습 시 통신 담당 |
| NPU (Neural Processing Unit) | AI 신경망 연산에 특화된 전용 회로, 낮은 전력으로 처리 | 스마트폰의 사진 보정·음성 인식·실시간 번역 |
| 시스톨릭 어레이 (Systolic Array) | 곱셈-누적 유닛을 격자로 배열해 데이터가 심장 박동처럼 흐르며 재사용되는 NPU 내부 구조 | 구글 TPU가 대표 사례 |
| TOPS | 초당 조 단위 연산, NPU 성능 지표 | 와트당 TOPS는 전력 대비 효율을 나타내는 핵심 기준 |
| 메모리 바운드 (메모리 병목) | 연산 능력이 아니라 데이터 공급 속도가 성능을 제한하는 상태 | 수억 원짜리 GPU가 데이터를 기다리며 노는 상황 |
| HBM (High Bandwidth Memory) | GPU에 데이터를 고속 공급하는 고대역폭 메모리, AI 시대 핵심 병목 부품 | 다음 2편에서 본격 다룰 예정 |