01핵심 개요
| 항목 | 내용 | |
|---|---|---|
| 영상 | I Made Codex and Claude Code Build the Same App. One Clearly Won. | |
| 채널 | Nate Herk \ | AI Automation |
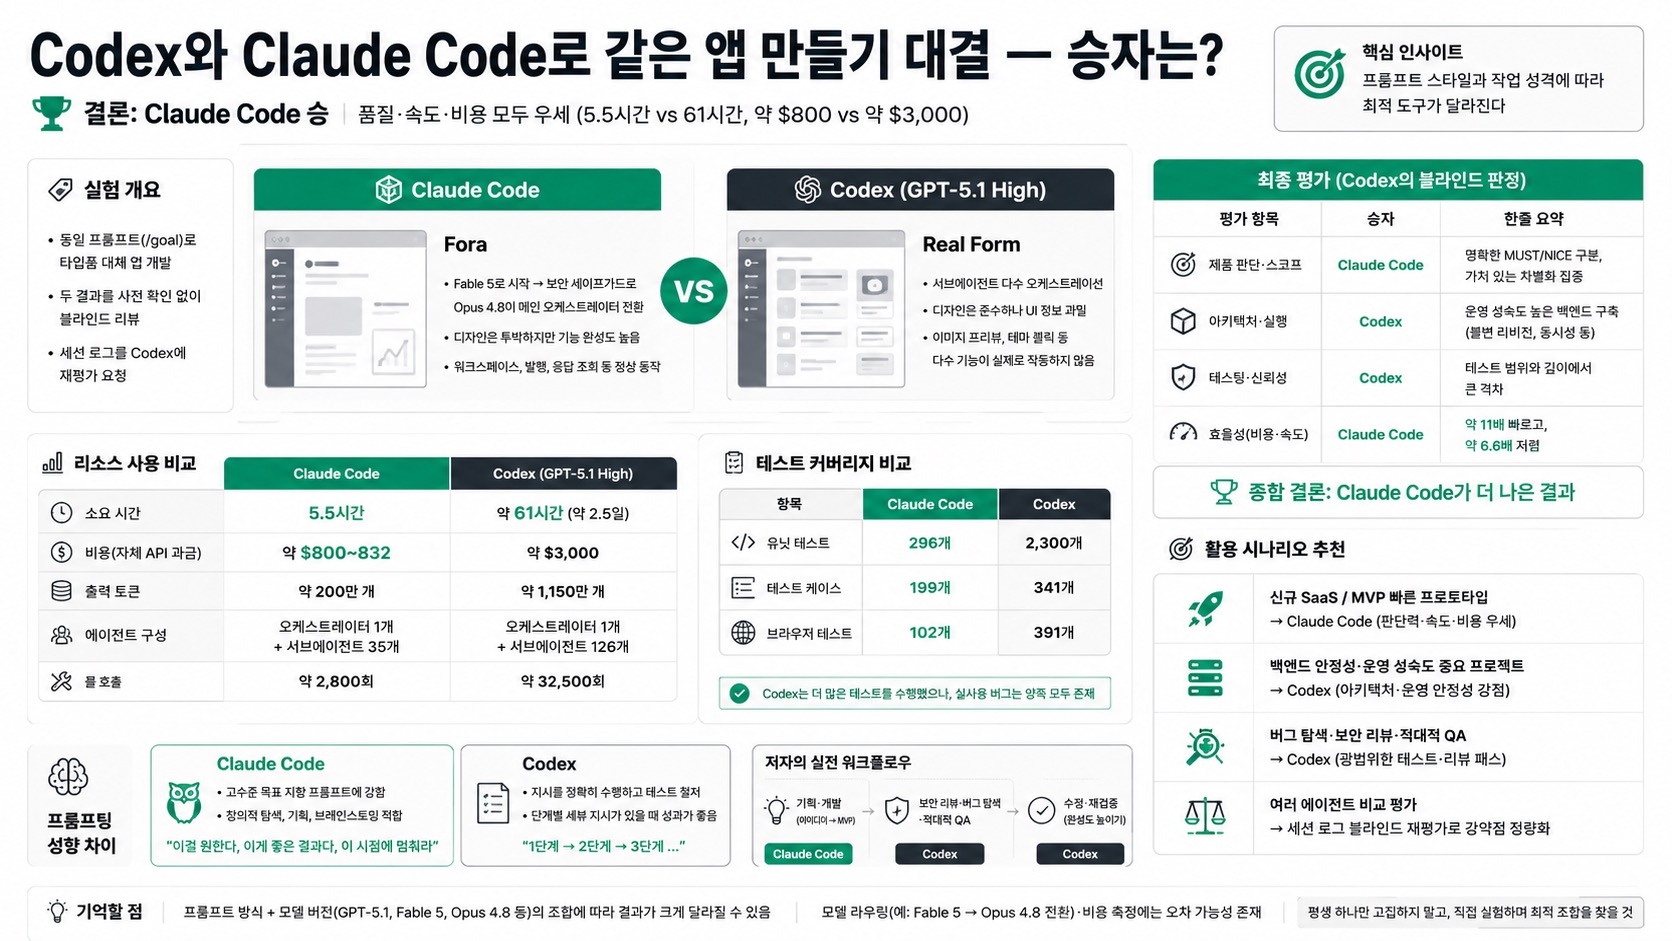
| 실험 | Codex와 Claude Code에 완전히 동일한 프롬프트(/goal)로 타입폼(Typeform) 대체 앱을 만들게 함 | |
| 결과 | Claude Code 승 — 산출물 품질, 속도(5.5시간 vs 61시간), 비용(약 $800 vs 약 $3,000) 모두 우세 | |
| 반전 | 저자는 평소 지식노동에 Codex를 80% 사용할 만큼 Codex를 선호했으나, 이번 앱 빌드 실험에서는 예상과 반대로 Claude Code가 더 나은 결과를 냄 | |
| 핵심 결론 | 절대적 우열이 아니라 프롬프트 스타일과 작업 성격에 따라 최적 도구가 달라짐 — Claude Code는 고수준 목표·판단에, Codex는 세부 지시·테스트·인프라 안정성에 강함 |
02핵심 기능/내용 구조
- 저자는 두 AI 코딩 에이전트(Codex, Claude Code)에
/goal슬래시 명령으로 동일한 프롬프트를 입력함 - 프롬프트 요지: "프로덕션 수준의 독자 브랜드 타입폼 대체 앱을 만들어라. 리서치 → 빌드 → 검증 3단계로 전문화된 서브에이전트를 오케스트레이션하라. 프로토타입이나 첫 성공 빌드에서 멈추지 말고, 앱이 진짜로 완성될 때까지 계속 리서치·빌드·테스트·수정·재테스트하라"
- 저자는 사후에 "리서치와 빌드 사이에 별도의 '플래닝' 단계를 넣었다면 결과가 더 좋았을 것"이라고 회고함
- Codex는 여행 중이던 맥에서 먼저 실행했고, 이후 귀가해 같은 프롬프트를 Claude Code에도 실행함 — 두 결과 모두 저자가 사전에 확인하지 않은 상태에서 리뷰를 진행
03기술적 맥락
- Codex가 만든 앱("Real Form"): GPT-5.1 Codex(High 설정)로 서브에이전트들을 오케스트레이션. 디자인은 시각적으로 준수하나 UI에 정보가 과밀하고 일부 기능(이미지 프리뷰, 테마 컬러 클릭 등)이 실제로 작동하지 않는 버그가 다수 발견됨
- Claude Code가 만든 앱("Fora"): 세션은 Fable 5로 시작했으나 어떤 보안 세이프가드로 인해 자동으로 Opus 4.8이 메인 오케스트레이터로 전환되고, 이 Opus 4.8이 Fable 5 서브에이전트들을 구동하는 구조로 진행됨. 디자인은 투박하지만("brutally ugly") 실제 사용성과 기능 완성도는 더 높았음(워크스페이스 전환, 발행 후 결과 확인, 응답 요약/개별 응답 조회 등 정상 동작)
- 두 앱 모두 실사용 중 버그가 발견됨(내비게이션 뒤로가기 불가, 페이지 번호 미갱신 등) — 저자는 "에이전트가 직접 주도하지 않는 시나리오는 테스트에서 놓치기 쉽다"고 지적
- 리소스 사용량 비교(자체 API 과금 기준):
- Claude Code: 약 $800~832, 출력 토큰 약 200만 개, 소요시간 5.5시간, 오케스트레이터 1개 + 서브에이전트 35개, 툴 호출 약 2,800회 - Codex: 약 $3,000, 출력 토큰 약 1,150만 개, 소요시간 약 61시간(약 2.5일), 오케스트레이터 1개 + 서브에이전트 126개, 툴 호출 약 32,500회 - 테스트 커버리지: Claude Code는 유닛테스트 296개·테스트케이스 199개·브라우저테스트 102개, Codex는 유닛테스트 2,300개·테스트케이스 341개·브라우저테스트 391개로 Codex가 훨씬 많은 테스트를 수행
04전략적 의미
- 저자는 두 세션 로그를 모두 Codex에 입력해 "어느 쪽이 더 잘했는지" 블라인드 평가를 시켰고, Codex 스스로도 Claude Code(Agent A)가 더 낫다고 판정함
- Codex가 매긴 카테고리별 승자:
- 제품 판단·스코프: Claude Code 승 — 명확한 머스트/나이스 구분, 가치 있는 차별화 요소에 집중. Codex는 135개 기능을 욕심내며 절제 부족 - 아키텍처·실행: Codex 승 — Claude Code는 계약 우선(contract-first) 방식으로 병합 충돌 0건을 달성했지만, Codex는 불변 리비전·오프라인 복구·마이그레이션 안전성·동시성 처리 등 운영 성숙도가 더 높은 백엔드를 구축 - 테스팅·신뢰성: Codex가 큰 격차로 승 — 크로스브라우저 테스트, 프로퍼티 테스트, 폴트 인젝션 등 폭넓은 테스트 수행 - 효율성: Claude Code 승(10점 만점에 9.8 vs 5.5) — 약 11배 빠르고 약 6.6배 저렴
- 시사점: 사용자 대면 제품/MVP처럼 판단력과 범위 설정이 중요한 작업엔 Claude Code, 백엔드 인프라 안정성·광범위한 QA가 중요한 작업엔 Codex가 강점을 보일 가능성이 있음(단, 이는 이번 1회 실험에 근거한 저자의 해석)
05핵심 워크플로우·방법론
- 저자가 실전에서 체감한 두 도구의 프롬프팅 성향 차이:
- Claude Code: 고수준 목표 지향적 프롬프트에 강함 — "이걸 원한다, 이게 좋은 결과다, 이 시점에 멈춰라" 식의 지시가 잘 통함. 창의적 탐색·기획·브레인스토밍에 적합("현명한 부엉이" 비유) - Codex: 순종적으로 지시를 정확히 수행하고 테스트까지 철저히 함. 다만 목표 지향적 프롬프트에서는 사용자 의도를 스스로 해석·탐색하는 능력이 상대적으로 약해, 단계별(1단계, 2단계, 3단계…)로 구체적으로 지시해야 결과가 좋음
- 저자의 실사용 패턴: 지식노동(기획·리서치)엔 Codex를 약 80%, Claude Code를 약 20% 사용. 개발·기획 단계는 Claude Code, 보안 리뷰·버그 탐색·수정은 Codex(Claude Code용 Codex 플러그인으로 적대적 리뷰 수행)를 선호
- 결론적 조언: 도구 제작자(보리스 처니, 안드레 카파시 등)의 조언을 맹목적으로 따르기보다, 자신의 워크플로우에서 직접 실험해 보고 판단할 것을 권장("삼단뛰기 선수의 조언은 삼단뛰기 선수에게 듣는 게 낫다"는 비유)
06활용 시나리오
- 신규 SaaS/MVP를 빠르게 프로토타이핑할 때 — 고수준 목표(
/goal) 프롬프트로 Claude Code에 맡기면 제품 판단력과 속도·비용 면에서 유리 - 백엔드 인프라의 운영 안정성(동시성, 마이그레이션, 오프라인 복구 등)이 중요한 프로젝트 — Codex에 단계별 세부 지시로 접근하면 더 성숙한 아키텍처를 기대할 수 있음
- 버그 탐색·보안 리뷰·적대적 QA가 필요한 완성 단계 — Codex(또는 Codex 플러그인)로 별도 리뷰 패스를 두는 방식이 유효
- 동일 프롬프트로 여러 에이전트를 비교 평가하려는 팀 — 세션 로그를 다른 AI에게 블라인드로 재평가시켜 카테고리별 강약점을 정량화하는 방법론 자체가 재사용 가능
07현황 및 전망
- 저자는 이번 결과가 절대적 우열이 아니라 "프롬프트 방식 + 모델 버전(GPT-5.1 Codex, Fable 5, Opus 4.8 등)의 조합에 따라 크게 달라지는 슬롯머신 같은 것"이라고 강조함
- 실제로 Claude Code 세션 도중 별도 보안 세이프가드로 인해 처음 지정한 모델(Fable 5)이 아닌 Opus 4.8이 메인 오케스트레이터로 자동 전환되는 현상이 관찰되어, 같은 프롬프트라도 실행 시점의 내부 라우팅에 따라 결과가 달라질 수 있음을 시사
- 저자는 두 도구를 계속 병행 사용하며 신규 모델 업데이트가 나올 때마다 사용 비중을 유동적으로 조정하겠다는 입장 — "평생 하나만 쓰겠다"는 고정된 선택은 하지 않겠다고 밝힘
- 비용 언급 시 저자 본인도 세션 내에서 $832와 $447(추정 재계산치) 사이에 불일치를 발견했다고 밝혀, 실측 비용에는 약간의 오차 가능성이 있음을 스스로 인정함(대략적 규모 비교로 참고할 것)
08용어 사전
| 용어 | 한줄설명(40자 이내) | 비유/예시 |
|---|---|---|
| Claude Code | Anthropic의 터미널 기반 AI 코딩 에이전트 | 목표만 주면 알아서 탐색하는 비서 |
| Codex | OpenAI의 AI 코딩 에이전트(GPT-5.1 기반) | 지시를 꼼꼼히 따르는 실행 요원 |
| /goal | 고수준 목표를 던지면 에이전트가 계획·실행하는 명령 | "이렇게 되면 성공"이라는 최종 목표만 전달 |
| 서브에이전트 | 오케스트레이터가 하위 작업을 맡기는 보조 AI 인스턴스 | 팀장이 실무진에게 업무 분배 |
| 오케스트레이터 | 전체 작업을 지휘하며 서브에이전트를 조율하는 상위 에이전트 | 프로젝트 매니저 역할 |
| 계약 우선(contract-first) | 인터페이스 규격을 먼저 정하고 병렬 개발하는 방식 | 설계도 먼저 그리고 각자 시공 |
| 병합 충돌 | 여러 작업 결과를 합칠 때 코드가 서로 어긋나는 문제 | 동시에 같은 문서를 고쳐 생기는 충돌 |
| 폴트 인젝션 테스트 | 일부러 오류 상황을 주입해 견고성을 검증하는 테스트 | 일부러 넘어뜨려 보는 내구성 테스트 |
| 프로퍼티 테스트 | 다양한 입력 조합으로 규칙 위반을 자동 탐색하는 테스트 | 무작위 대입으로 허점 찾기 |
09딥링크
- 00:00 실험 소개 — 동일 프롬프트로 Codex와 Claude Code에 앱 빌드 지시, 결과는 극명하게 다름
- 01:51 Codex가 만든 "Real Form" 첫 리뷰 — 디자인은 준수하나 UI 과밀, 이미지 프리뷰 버그 발견
- 08:43 화면 전환 — Claude Code가 만든 "Fora" 리뷰 시작, 디자인은 투박하나 사용성은 더 명확
- 12:37 정답 공개 — Claude Code가 Fora(기능 우수)를, Codex가 Real Form(디자인만 우수)을 만들었음
- 13:22 비용·토큰 비교 — Claude Code 약 $832·200만 토큰 vs Codex 약 $3,000·1,150만 토큰
- 14:43 소요시간·구조 비교 — Claude Code 5.5시간·서브에이전트 35개 vs Codex 61시간·서브에이전트 126개
- 18:55 Codex의 블라인드 평가 결과 — 카테고리별(제품판단/아키텍처/테스팅/효율성) 승자 분석
- 20:51 결론 — 도구별 강점 차이는 절대적이지 않으며, 직접 실험하고 스스로 판단할 것을 권장