01핵심 개요
| 항목 | 내용 |
|---|
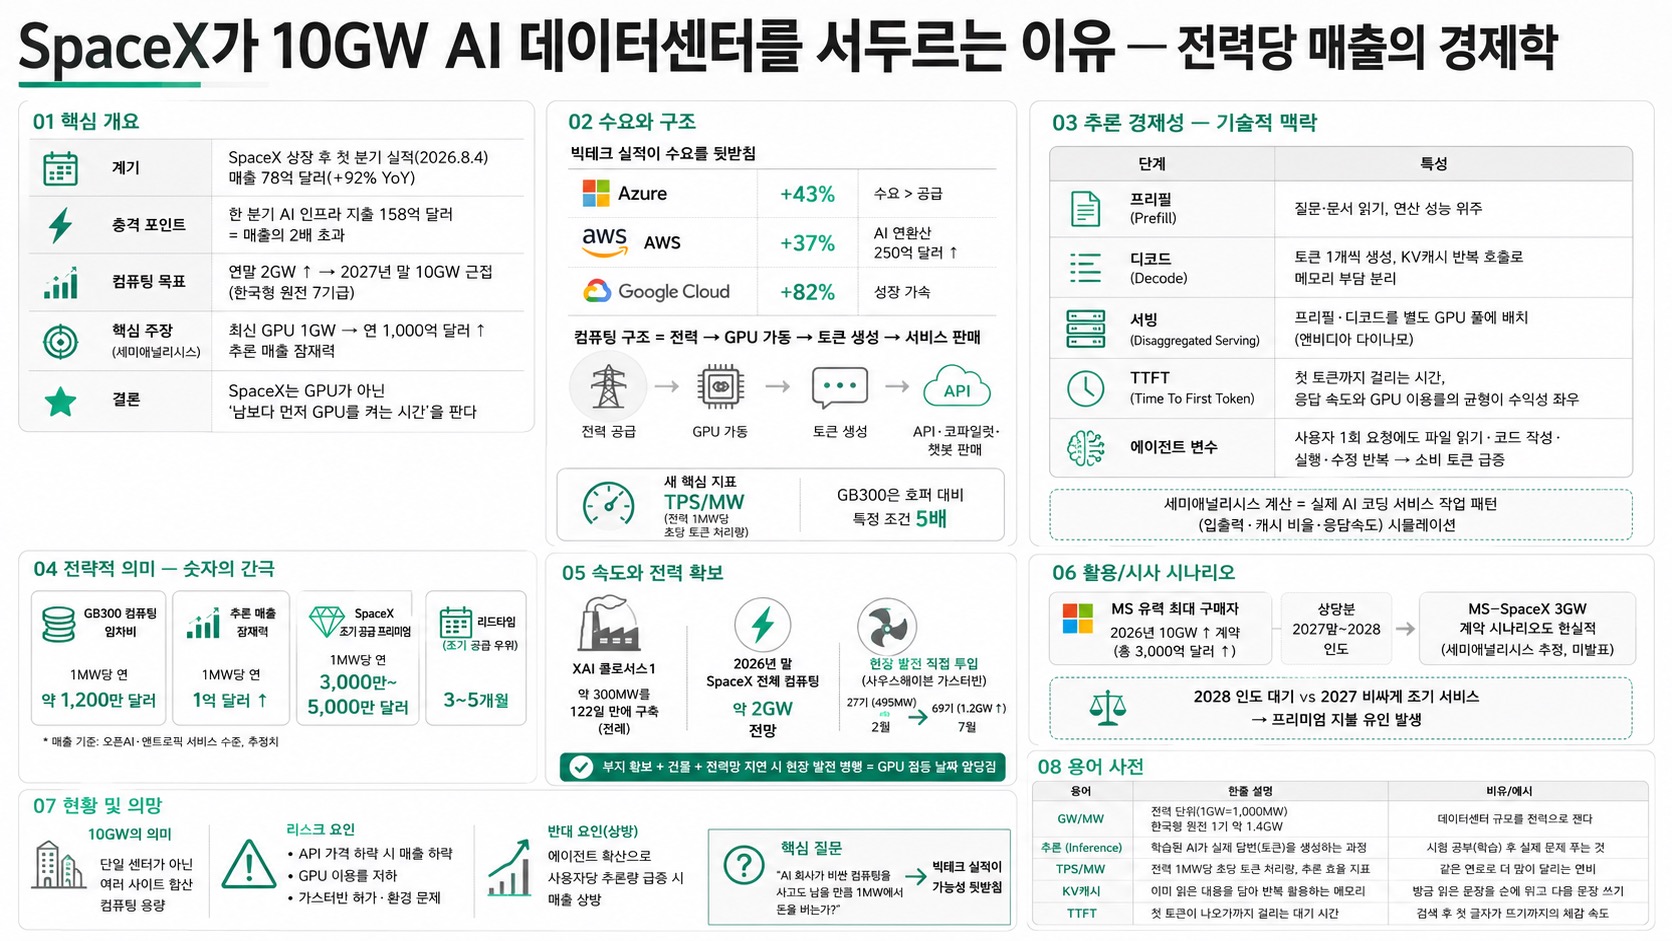
| 계기 | SpaceX 상장 후 첫 분기 실적(2026.8.4), 매출 78억 달러(+92% YoY) |
| 충격 포인트 | 한 분기 AI 인프라 지출 158억 달러 = 매출의 2배 초과 |
| 컴퓨팅 목표 | 연말 2GW↑ → 2027년 말 10GW 근접(한국형 원전 7기급) |
| 핵심 주장(세미애널리시스) | 최신 GPU 1GW → 연 1,000억 달러↑ 추론 매출 잠재력 |
| 결론 | SpaceX는 GPU가 아닌 '남보다 먼저 GPU를 켜는 시간'을 판다 |
02핵심 내용 구조
- 빅테크 실적이 수요 뒷받침: Azure +43%(수요>공급), AWS +37%(AI 연환산 250억 달러↑), 구글클라우드 +82%
- 컴퓨팅 구조 = 전력 공급 → GPU 가동 → 토큰 생성 → API·코파일럿·챗봇 판매
- 새 핵심 지표 = TPS/MW(전력 1MW당 초당 토큰 처리량), GB300은 호퍼 대비 특정 조건 5배
03기술적 맥락 — 추론 경제성
| 단계 | 특성 |
|---|
| 프리필(Prefill) | 질문·문서 읽기, 연산 성능 위주 |
| 디코드(Decode) | 토큰 1개씩 생성, KV캐시 반복 호출로 메모리 부담 |
| 분리 서빙 | 프리필·디코드를 별도 GPU 풀에 배치(엔비디아 다이나모 Disaggregated Serving) |
| TTFT | 첫 토큰까지 걸리는 시간, 응답 속도와 GPU 이용률의 균형이 수익성 좌우 |
- 세미애널리시스 계산 = 실제 AI 코딩 서비스 작업 패턴(입출력·캐시 비율·응답속도) 시뮬레이션
- 에이전트 변수 = 사용자 1회 요청에도 GPU가 파일 읽기·코드 작성·실행·수정 반복 → 소비 토큰 급증
04전략적 의미 — 숫자의 간극
- GB300 컴퓨팅 임차비 = 1MW당 연 약 1,200만 달러
- 추론 매출 잠재력 = 1MW당 연 1억 달러↑ (오픈AI·앤트로픽 서비스 기준)
- SpaceX 조기 공급 프리미엄 = 1MW당 연 3,000만~5,000만 달러 추정
- 리드타임 = SpaceX가 노리는 조기 공급 우위 3~5개월
05핵심 방법론 — 속도와 전력 확보
- XAI 콜로서스1 = 약 300MW를 122일 만에 구축(전례)
- 2026년 말 SpaceX 전체 컴퓨팅 약 2GW 전망
- 전력망 대기 대신 '현장 발전' 직접 투입 = 사우스헤이븐 가스터빈 27기(495MW, 2월) → 69기(1.2GW↑, 7월)
- 부지 확보 + 건물 + 전력망 지연 시 현장 발전 병행 = GPU 점등 날짜 앞당김
06활용/시사 시나리오
- MS = 유력 최대 구매자, 2026년 10GW↑ 계약(총 3,000억 달러↑), 상당분 2027말~2028 인도 → 조기 컴퓨팅 필요
- MS-SpaceX 3GW 계약 시나리오도 현실적(세미애널리시스 추정, 미발표)
- 2028 인도 대기 vs 2027 비싸게 조기 서비스 → 프리미엄 지불 유인 발생
07현황 및 전망
- 10GW = 단일 센터가 아닌 여러 사이트 합산 컴퓨팅 용량
- 리스크 = API 가격 하락 시 매출 하락, GPU 이용률 저하, 가스터빈 허가·환경 문제
- 반대 요인 = 에이전트 확산으로 사용자당 추론량 급증 시 매출 상방
- 핵심 질문 = "AI 회사가 비싼 컴퓨팅을 사고도 남을 만큼 1MW에서 돈을 버는가" → 빅테크 실적이 가능성 뒷받침
08용어 사전
| 용어 | 한줄 설명 | 비유/예시 |
|---|
| GW/MW | 전력 단위(1GW=1,000MW), 한국형 원전 1기 약 1.4GW | 데이터센터 규모를 전력으로 잰다 |
| 추론(Inference) | 학습된 AI가 실제 답변(토큰)을 생성하는 과정 | 시험 공부(학습) 후 실제 문제 푸는 것 |
| TPS/MW | 전력 1MW당 초당 토큰 처리량, 추론 효율 지표 | 같은 연료로 더 많이 달리는 연비 |
| KV캐시 | 이미 읽은 내용을 담아 반복 활용하는 메모리 | 방금 읽은 문장을 손에 쥐고 다음 문장 쓰기 |
| TTFT | 첫 토큰이 나오기까지 걸리는 대기 시간 | 검색 후 첫 글자가 뜨기까지의 체감 속도 |