01핵심 개요
| 항목 | 내용 |
|---|---|
| 행사 | 2026-07-24 샌프란시스코 AI 서밋 |
| 참석 | 젠슨 황, 샘 올트먼, 다리오 아모데이, 혹 탄 / 이재용·최태원·정의선·이해진 |
| 3사 역할 | 네이버=데이터·모델, SKT=컴퓨팅, 현대차=현실 검증 |
| 핵심 규모 | SKT 최대 2GW 베라루빈 DSX AI 팩토리(2027 가동 목표) |
| 삼성 | 브로드컴과 5년 2백억 달러+ 커스텀 AI·2nm 파운드리·첨단 패키징 |
02핵심 내용 구조 — 세 기업의 역할 분담
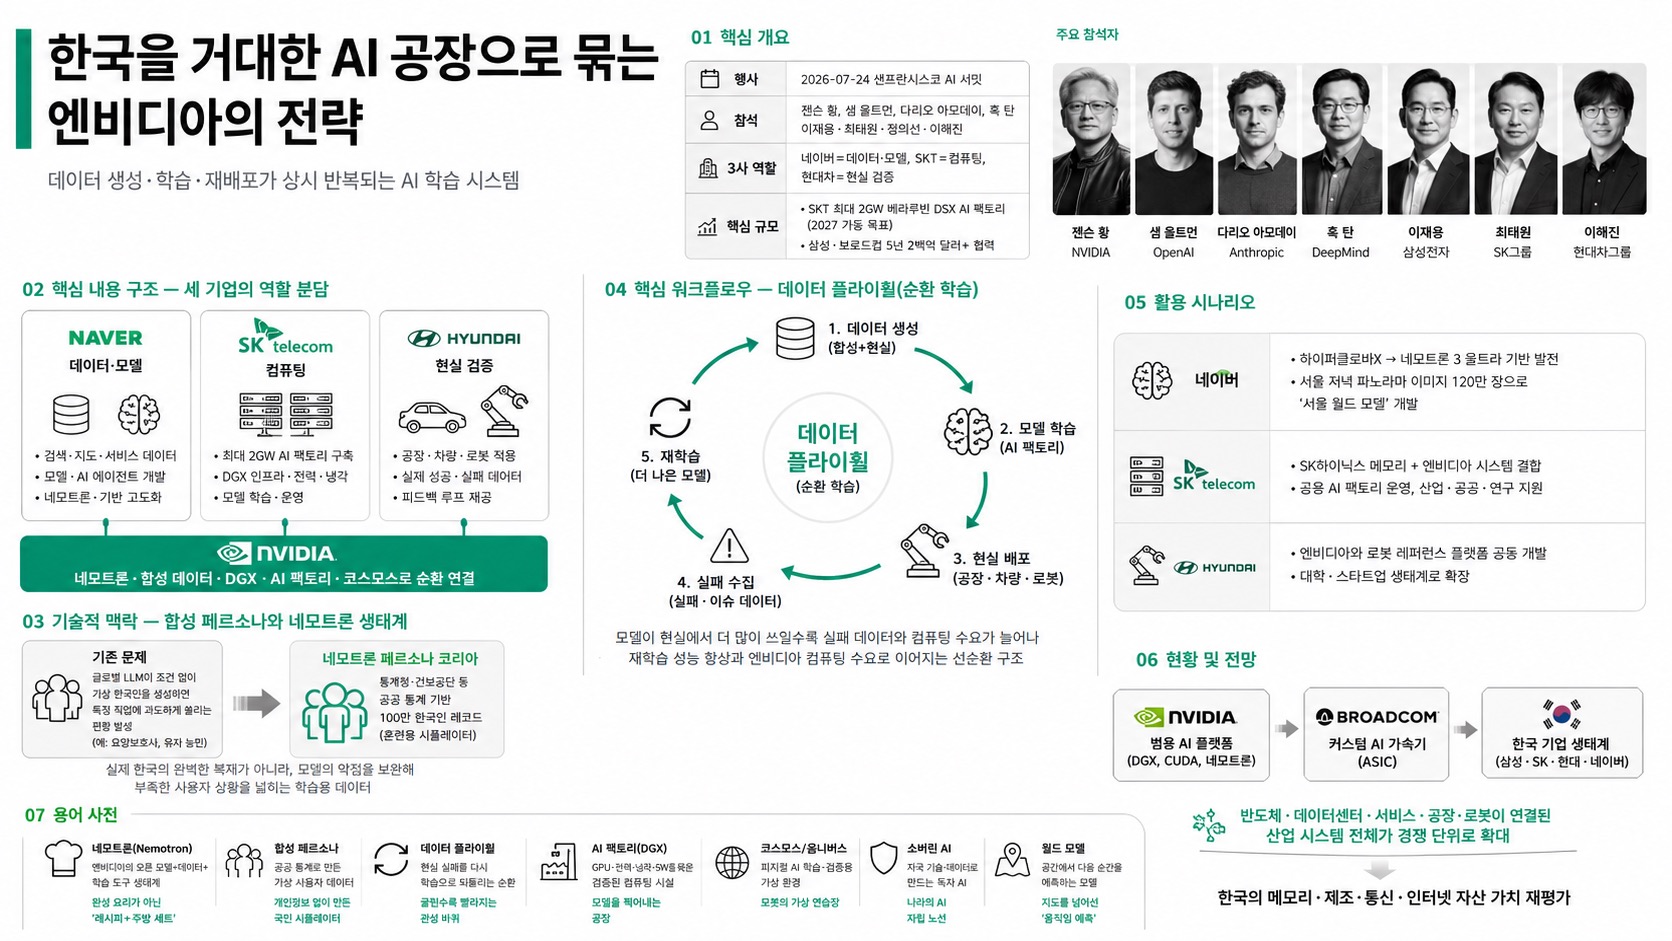
네이버는 검색·지도 서비스 데이터로 모델과 AI 에이전트를 만들고, SK텔레콤은 이를 학습·운영할 기가와트급 AI 팩토리를 구축한다. 현대차는 모델을 공장·차량·로봇에 투입해 실제 성공·실패 데이터를 만든다. 엔비디아는 네모트론·합성 데이터·DGX·AI 팩토리·코스모스로 이 세 영역을 하나의 순환 구조로 연결한다.
03기술적 맥락 — 합성 페르소나와 네모트론 생태계
지난 4월 서울 네모트론 개발자 행사에서, 글로벌 LLM에 조건 없이 가상 한국인을 생성시키면 요양보호사·유자 농민처럼 특정 직업에 과도하게 쏠리는 편향이 드러났다. 엔비디아는 통계청·건보공단 등 공공 통계 기반의 '네모트론 페르소나 코리아'(100만 한국인 레코드)로 이를 보완했다. 이는 실제 한국의 완벽한 복제가 아니라 모델의 약점을 겨냥해 부족한 사용자 상황을 넓히는 훈련용 시뮬레이터다.
04핵심 워크플로우 — 데이터 플라이휠(순환 학습)
기존 AI가 한 번 학습 후 배포로 끝났다면, 이 구조는 데이터 생성→모델 학습→현실 배포→실패 수집→재학습이 계속 도는 산업 공정이다. 현대차 공장에서 로봇이 실패한 장면을 옴니버스·코스모스에서 조명·마찰·물체 위치를 바꿔 대량 합성 재현하고 다시 학습시켜 재배포한다. 모델이 현실에서 더 쓰일수록 재학습 데이터와 컴퓨팅 수요가 늘어 엔비디아 본업인 컴퓨팅 수요로 이어진다.
05활용 시나리오
네이버는 하이퍼클로바X를 네모트론 3 울트라 기반으로 발전시키고, 서울 저녁 파노라마 이미지 120만 장으로 '서울 월드 모델'을 개발한다. SKT는 SK하이닉스 메모리와 엔비디아 시스템을 결합한 공용 AI 팩토리를 운영하고, 현대차는 엔비디아와 로봇 레퍼런스 플랫폼을 공동 개발해 대학·스타트업 생태계로 확장한다.
06현황 및 전망
미래 AI 시장은 엔비디아의 범용 AI 플랫폼과 브로드컴 중심의 빅테크 커스텀 가속기 두 축으로 확대되며, 한국(삼성·SK·현대·네이버)은 양쪽 모두에서 역할을 맡는다. 경쟁 단위가 모델 하나에서 반도체·데이터센터·서비스·공장·로봇이 연결된 산업 시스템 전체로 커지면서, 한국이 이미 보유한 메모리·제조·통신·인터넷 자산의 가치가 재평가되고 있다.
07용어 사전
| 용어 | 한줄 설명 | 비유/예시 |
|---|---|---|
| 네모트론(Nemotron) | 엔비디아의 오픈 모델+데이터+학습 도구 생태계 | 완성 요리가 아닌 '레시피+주방 세트' |
| 합성 페르소나 | 공공 통계로 만든 가상 사용자 데이터 | 개인정보 없이 만든 국민 시뮬레이터 |
| 데이터 플라이휠 | 현실 실패를 다시 학습으로 되돌리는 순환 | 굴릴수록 빨라지는 관성 바퀴 |
| AI 팩토리(DGX) | GPU·전력·냉각·SW를 묶은 검증된 컴퓨팅 시설 | 모델을 찍어내는 공장 |
| 코스모스/옴니버스 | 피지컬 AI 학습·검증용 가상 환경 | 로봇의 가상 연습장 |
| 소버린 AI | 자국 기술·데이터로 만드는 독자 AI 주권 | 나라의 AI 자립 노선 |
| 월드 모델 | 공간에서 다음 순간을 예측하는 모델 | 지도를 넘어선 '움직임 예측' |