Nick SaraevMORNING DIGEST · 2026-07-26 · Nick Saraev🎬 영상
I Spent $400 Benching Opus-5. Here's What It Can Do
01핵심 개요
항목
내용
채널
Nick Saraev
제목
I Spent $400 Benching Opus-5. Here's What It Can Do
길이
약 15분 45초(945초)
핵심결론 1
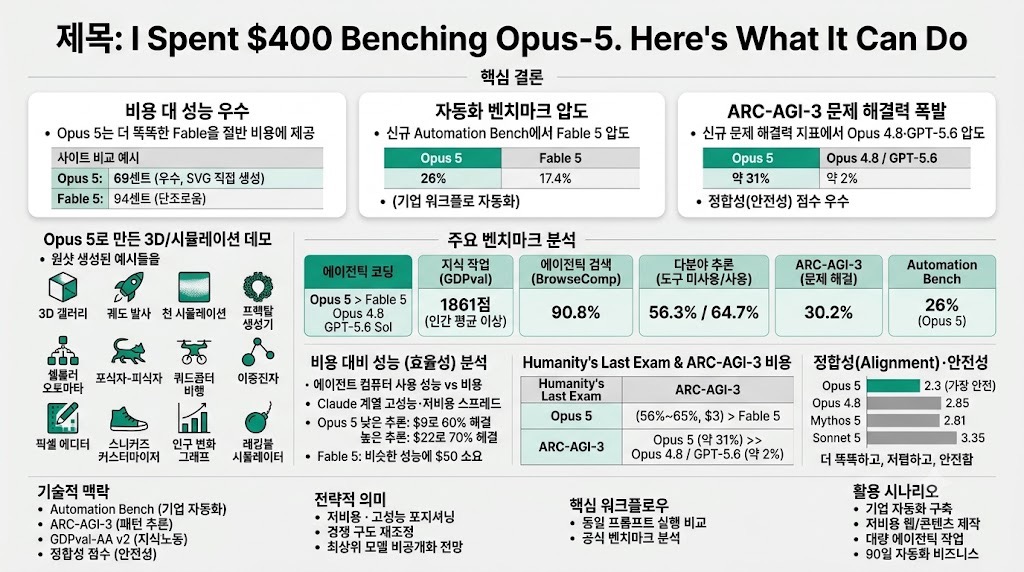
Opus 5는 사실상 "더 똑똑해진 Fable"을 Fable 비용의 절반 수준에 제공하며, 진행자가 직접 만든 웹사이트 비교에서 Opus 5가 69센트, Fable 5가 94센트로 Opus가 더 저렴하면서 결과물도 더 우수했다
핵심결론 2
신규 Automation Bench(기업용 워크플로 자동화 벤치마크)에서 Opus 5는 26%를 기록해 Fable 5의 17.4%를 크게 앞섰다
핵심결론 3
ARC-AGI-3(신규 문제 해결력) 벤치마크에서 Opus 5는 약 30~31%를 기록해 Opus 4.8과 GPT-5.6의 약 2% 수준을 압도적으로 앞섰고, 안전성(정합성) 점수도 Opus 4.8·Sonnet 5보다 우수했다
02핵심 내용 구조
1) Opus 5로 만든 3D/시뮬레이션 데모 모음
진행자는 거의 작업 없이 Opus 5로 만든 3D 월드(예술작품을 걸어다니며 감상하는 갤러리, 마우스오버 시 소리 재생)를 시연했다.
Kerbal Space Program 스타일의 궤도 발사 시뮬레이터, 천 시뮬레이션(찢기 가능), 프랙탈 생성기(줌 가능한 셰이더), 셀룰러 오토마타(모래 낙하) 등 다양한 인터랙티브 시뮬레이션을 원샷으로 생성했다.
포식자-피식자 생태계 시뮬레이션(토끼-여우 개체수 변화), 쿼드콥터 비행 시뮬레이터(착륙 기능 포함), 이중진자, 픽셀 에디터(다중 레이어·애니메이션 프레임 지원), 스니커즈 커스터마이저(SVG로 직접 소재 생성) 등도 제작했다.
인구 변화 설명 그래프(126년간 뉴욕·런던·도쿄 등 인구 변화 시각화), 레킹볼 시뮬레이터(벽 파괴율 진행률 표시)도 시연됐다.
2) Opus 5 vs Fable 5 직접 비용·품질 비교
동일한 "3D 패널 판매 사이트(Mac/Apple 스타일)" 제작을 두 모델에 맡긴 결과, Opus 5는 69센트, Fable 5는 94센트가 들었다.
진행자는 Opus 5의 결과물이 SVG로 직접 리소스를 만들어 슬라이드 효과 등 시각적으로 더 뛰어났고, Fable 5 결과물은 "더 단순하고 사실상 더 단조롭다"고 평가했다.
결론적으로 "Opus 5는 Fable보다 약간 더 똑똑하면서 비용은 절반 수준"이라고 요약했다.
3) 공식 벤치마크 분석 — 에이전틱 코딩·지식 작업
에이전틱 터미널 코딩 벤치마크에서 Opus 5는 Fable 5보다 우수하고 Opus 4.8과 GPT-5.6 Sol보다도 앞섰다.
지식 작업 벤치마크 GDPval-AA v2에서 1861점을 기록해 평균적인 인간 지식노동자 수준을 웃돌았다.
신규 문제 해결력 지표인 ARC-AGI-3에서 30.2%를 기록했는데, 이는 Opus 4.8의 1.5%에서 급격히 개선된 수치이며 Fable 5는 아직 이 벤치마크를 돌리지 않아 비교 데이터가 없다.
4) 에이전틱 검색·추론·컴퓨터 사용 벤치마크
에이전틱 검색(BrowseComp)에서 90.8%를 기록해 Fable 5보다 약간 높았고 Opus 4.8보다는 크게 앞섰으며 GPT-5.6 Sol과는 비슷한 수준이었다.
다분야 추론에서는 도구 미사용 시 56.3%, 도구 사용 시 64.7%를 기록해 Fable 5의 63.9%를 근소하게 앞섰다.
컴퓨터 사용(Computer Use) 벤치마크는 70.6%를 기록했고, 에이전틱 코딩 세부 항목에서는 GPT-5.6이 여전히 모든 모델을 앞섰다.
5) Automation Bench(신규 기업 자동화 벤치마크) — Opus 5 압도
기업용 워크플로 자동화 구축 능력을 측정하는 신규 벤치마크에서 Opus 5는 26%, Fable 5는 17.4%를 기록했다.
인간 수준에는 아직 크게 못 미치지만(약 4분의 1 성공률), 불과 몇 세대 전 모델 대비 큰 진전으로 평가됐다.
법률 분야 11.7%, 헬스케어 59.8%, 생물학은 어려운 문제에서 49.4%였으나 인간이 이미 푼 문제 재현에서는 90.1%를 기록해 분야별 편차가 컸다.
6) 비용 대비 성능(효율성) 분석
Anthropic이 제공한 "에이전트 컴퓨터 사용 성능 vs 노력 수준(비용)" 그래프에서, Claude 계열 모델은 그래프 우상단(고성능·저비용 스프레드)에 몰려 있어 GPT-5.6 Sol 대비 비용 대비 일관된 성능을 보였다.
Opus 5의 가장 낮은 추론 단계는 작업당 약 9달러로 컴퓨터 사용 작업의 약 60%를 해결했고, 가장 높은 추론 단계는 작업당 약 22달러로 약 70%를 해결했다.
Fable 5는 Opus 5의 중간 단계와 비슷한 성능을 내는 데 작업당 거의 50달러가 들어, Opus 5가 훨씬 비용 효율적임을 보여줬다.
7) Humanity's Last Exam & ARC-AGI-3 비용 대비 성능
"Humanity's Last Exam" 벤치마크에서 Opus 5의 가장 낮은 버전도 약 56%, 가장 높은 버전은 작업당 3달러로 약 65%를 기록해 Fable 5보다 우수하면서 훨씬 저렴했다.
ARC-AGI-3(신규 문제 해결)에서는 Opus 4.8과 GPT-5.6이 약 2% 수준에 머문 반면 Opus 5는 약 31%를 기록해 압도적 격차를 보였다(Fable 5는 이 벤치마크 미실시).
8) 정합성(Alignment)·안전성 점수
오정렬 행동(misaligned behavior) 측정 지표에서 Opus 4.8은 2.85점, (사이버보안 사고를 일으켜 미국 정부가 접근을 제한했던) Mythos 5는 2.81점, Sonnet 5는 3.35점이었던 반면 Opus 5는 2.3점으로 가장 낮아(안전) 우수한 정합성을 보였다.
진행자는 이를 근거로 Opus 5가 "더 똑똑하고, 훨씬 저렴하고, 특정 도구 호출·자동화 작업에 더 강하면서도 더 안전한, 전방위적 승리"라고 평가했다.
03기술적 맥락
Automation Bench: 기업용 워크플로 자동화(예: 반복 업무 처리, 시스템 연동) 구축 능력을 측정하는 신규 벤치마크.
ARC-AGI-3: 모델이 훈련 데이터에 없던 새로운 유형의 문제를 얼마나 잘 푸는지(패턴 추론력)를 측정하는 벤치마크.
GDPval-AA v2: 실제 지식노동자 업무 수행 능력을 인간 평균과 비교해 채점하는 벤치마크.
정합성(Alignment) 점수: 모델이 목표 달성을 위해 인간이 의도하지 않은 편법적·기만적 행동을 하는 정도를 측정하는 지표(낮을수록 안전).
04전략적 의미
벤치마크 수치와 진행자의 직접 비교 모두에서 Opus 5가 "저비용 고성능" 포지션을 명확히 하고 있어, 기업 자동화·에이전틱 워크플로 도입 시 비용 장벽이 크게 낮아졌다.
최근 등장한 Kimi K3(오픈소스/중국계 모델)와의 경쟁 구도 속에서 Anthropic이 성능과 비용, 안전성을 동시에 개선한 모델을 내놓으며 균형을 재조정했다.
진행자는 향후 정말 강력한("galaxy brain") 최상위 모델들은 점점 더 비공개로 유지될 가능성이 크다고 전망해, 최고 성능 모델에 대한 일반 사용자 접근성 저하를 우려했다.
05핵심 워크플로우·방법론
동일한 프롬프트(3D 패널 판매 사이트 제작 등)를 Opus 5와 Fable 5에 각각 실행시켜 비용·결과물 품질을 직접 비교하는 방식으로 벤치마크 수치를 검증했다.
Anthropic 공식 벤치마크 자료(에이전틱 코딩, 지식 작업, 검색, 추론, 컴퓨터 사용, Automation Bench, ARC-AGI-3, 정합성)를 항목별로 순차 리뷰하며 Opus 5의 강점을 정리했다.
06활용 시나리오
기업 자동화 담당자가 반복 업무 워크플로를 구축할 때 Automation Bench 성능이 앞선 Opus 5를 우선 고려.
예산이 제한된 프리랜서·에이전시가 웹사이트·3D 인터랙티브 콘텐츠를 저비용으로 제작할 때 Opus 5 활용.
대량의 에이전틱 작업(검색, 추론, 컴퓨터 조작)을 반복 실행해야 하는 파이프라인에서 비용 대비 성능이 우수한 Opus 5의 저비용 추론 단계 활용.
90일 자동화 비즈니스 구축(진행자의 "Maker School" 커리큘럼처럼) 시 Opus 5 기반 자동화 워크플로로 첫 고객을 확보하는 전략.
07현황 및 전망
Opus 5는 Opus 4 → 4.5 → 4.7 → 4.8로 이어진 점진적 개선의 연장선이지만, Automation Bench·ARC-AGI-3·정합성 점수에서는 이전 세대 대비 뚜렷한 도약을 보였다.
Kimi K3의 등장으로 미국 프론티어 모델과 오픈소스/중국계 모델 간 힘의 균형이 흔들린 시점에 Opus 5가 나오면서 경쟁 구도가 재편되고 있다.
진행자는 앞으로 AI 모델 기업들이 미국 정부와의 협력 속에서 진짜 최상위 지능 모델은 점진적이고 제한적으로만 공개할 것으로 전망했다.