Chase AIMORNING DIGEST · 2026-07-25 · Chase AI🎬 영상
Opus 5 출시 — 벤치마크가 정말 미쳤다
01핵심 개요
항목
내용
채널
Chase AI
제목
Opus 5 Just Dropped and Its Numbers Are Legit INSANE
길이
약 4분 18초(258초)
핵심결론 1
신형 모델 Opus 5가 공개, 경쟁 최상위 모델(영상 내 "Fable 5")과 거의 동급 성능을 절반 비용에 제공
핵심결론 2
에이전틱 코딩·지식노동·에이전틱 검색 등 다수 벤치마크에서 이전 모델(Opus 4.8)을 압도적으로 능가
핵심결론 3
장기 자율 작업(long-horizon agentic task) 수행력과 시각적 산출물(3D/SVG) 능력도 크게 개선
02핵심 내용 구조
1) 벤치마크 전반 — Fable 5와 거의 동급, 비용은 절반
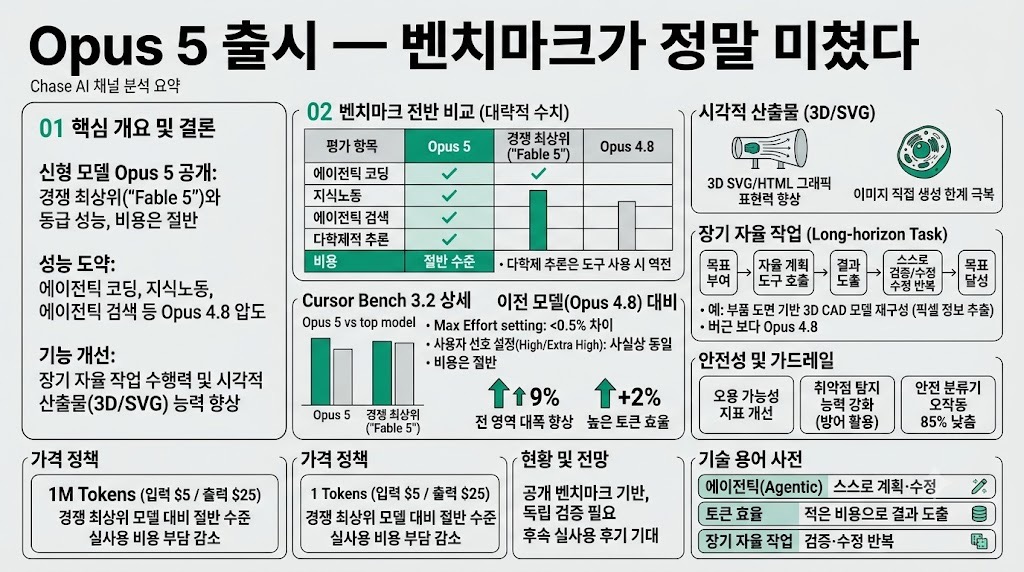
Opus 5는 에이전틱 터미널 코딩, 지식노동, 에이전틱 검색 등 다수 항목에서 경쟁 최상위 모델("Fable 5")과 이전 모델 Opus 4.8을 모두 앞서는 결과를 보였다고 소개됩니다.
GPT 계열 최신 모델("5.6 소울")과 비교해도 해당 카테고리들에서 앞선다는 언급이 나옵니다.
Opus 5가 더 낮은 성능을 보인 항목은 다학제적 추론(멀티디시플리너리 리즈닝) 정도이며 그 격차도 크지 않고, 도구를 사용하는 조건에서는 오히려 역전한다고 설명됩니다. 법률·헬스 분야도 예외로 언급되지만 나머지 대부분 항목에서는 최상위 모델을 능가합니다.
2) Cursor Bench 수치 — "거의 동급, 비용은 절반"
Cursor Bench 3.2를 최대 성능 설정(맥스 이펏)으로 테스트한 결과, Opus 5는 최상위 모델 대비 점수 차이가 0.5% 이내였다고 소개됩니다. 반면 과제당 비용은 절반 수준이라는 점이 핵심 포인트로 제시됩니다.
그래프상 최대 설정(맥스)에서는 경쟁 모델이 근소하게 앞서지만, 실제 사용자 대부분은 최대 설정이 아닌 '하이(high)'나 '엑스트라 하이(extra high)' 설정을 쓰는데, 이 구간에서는 Opus 5와 경쟁 모델의 결과가 사실상 동일한 수준으로 나온다고 설명됩니다.
다른 벤치마크인 아티피셜 애널리시스 코딩 에이전트 인덱스, 프런티어 벤치에서도 Opus 5가 경쟁 모델을 앞서는 결과가 소개됩니다.
3) 이전 모델(Opus 4.8) 대비 도약폭이 핵심
영상에서 강조하는 진짜 포인트는 단순히 경쟁 모델과의 비교가 아니라, 바로 직전 모델인 Opus 4.8에서 Opus 5로의 성능 도약폭이 전 영역에 걸쳐 매우 크다는 점입니다.
과거 다른 모델 세대 교체 때는 성능은 좋아졌지만 비용이 지나치게 비싸지는 경우가 있었다고 언급하며, Opus 5는 그런 사례와 달리 토큰 효율이 매우 높다고 평가합니다.
4) 시각적 산출물 — 3D·SVG 개선
예시로 Opus 5가 만든 풍동(wind tunnel) 관련 작업물과, 3D 인터랙티브 동물세포 아티팩트가 소개됩니다.
해당 계열 모델은 원래 이미지를 직접 생성하지 못하는 한계가 있었는데, 이번 버전은 3D 형태의 SVG·HTML 기반 그래픽 표현력이 크게 향상됐다는 점이 긍정적으로 평가됩니다.
5) 장기 자율 작업(Long-horizon Agentic Task) 능력
Anthropic 측은 Opus 5가 작업 결과를 스스로 검증하고 목표에 도달할 때까지 반복 수정하는 능력이 훨씬 강해졌다고 설명한다고 전합니다.
이는 한 번의 응답으로 끝나지 않고 루프를 돌며 목표 대비 결과를 계속 점검·수정해야 하는 작업(예: 이른바 '그래프 엔지니어링' 같은 작업)에서 Opus 4.8보다 훨씬 나은 성능을 보인다는 의미로 설명됩니다.
구체적 사례로, 기계 부품 도면을 주고 이를 3D CAD 모델 코드로 재현하라는 과제가 제시됩니다. 모델은 도면을 직접 볼 방법이 주어지지 않았음에도 불구하고, 스스로 컴퓨터 비전 파이프라인을 작성해 원본 이미지 픽셀에서 형상 정보를 추출한 뒤 기계 부품 전체를 재구성해냈다고 소개됩니다. 이는 구체적 수행 방법이 아니라 '목표'만 주어졌을 때의 자율적 문제 해결 능력을 보여주는 사례로 제시됩니다.
6) 안전성·정렬(Alignment) 지표
오용 가능성을 나타내는 지표(수치가 낮을수록 안전)에서도 Opus 5가 이전 모델들보다 개선됐다고 소개됩니다.
오픈소스 코드에서 취약점·익스플로잇을 찾아내는 능력이 Opus 4.8 대비 크게 늘었다는 점도 언급되는데, 이는 방어(보안 점검) 목적으로 활용 가능한 능력 향상으로 소개됩니다.
가드레일(안전장치) 측면에서는, 사이버보안·생물학 등 민감 주제를 언급했다고 무조건 응답을 차단하는 경쟁 모델과 달리 상대적으로 덜 엄격하다고 설명됩니다. 다만 안전 분류기(classifier)는 여전히 존재하며, 경쟁 모델 대비 오작동(불필요한 차단) 확률이 85% 낮다는 수치가 제시됩니다.
7) 가격 정책
Opus 5의 가격은 입력 100만 토큰당 5달러, 출력 100만 토큰당 25달러로 소개되며, 이는 경쟁 최상위 모델("Fable 5") 대비 절반 수준이라고 강조됩니다.
벤치마크에서 확인된 토큰 효율성과 결합해, 실사용 비용 부담이 상대적으로 낮아질 것으로 기대된다는 평가로 영상이 마무리됩니다.
03기술적 맥락
에이전틱(Agentic) 작업: 모델이 단발성 질의응답이 아니라 여러 단계를 스스로 계획하고 도구를 호출하며 목표를 달성해가는 방식의 작업을 뜻합니다. 코딩·검색·리서치 등에서 최근 AI 모델 평가의 핵심 축입니다.
토큰 효율(token efficiency): 같은 품질의 결과를 만들어내는 데 소모하는 토큰(=비용)이 얼마나 적은지를 뜻합니다. 성능이 좋아도 토큰을 많이 써야 한다면 실사용 비용이 커지므로, 벤치마크 점수와 별개로 중요한 지표입니다.
장기 자율 작업(long-horizon task): 한 번의 답변으로 끝나지 않고, 결과를 스스로 점검하고 목표에 도달할 때까지 여러 차례 반복 수정해야 하는 작업 유형입니다. 이번 영상에서는 CAD 모델 재구성 사례로 소개됩니다.
04전략적 의미
"경쟁 최상위 모델과 비슷한 성능을 절반 비용에" 라는 포지셔닝은, 고성능 모델 사용에 따르는 비용 부담을 낮춰 실무 적용 폭을 넓히는 방향으로 해석됩니다.
장기 자율 작업 능력 강화는 단순 챗봇형 사용을 넘어, 반복 검증이 필요한 복잡한 엔지니어링·자동화 워크플로우로 활용 범위가 확장될 가능성을 시사합니다.
안전 가드레일을 상대적으로 완화하면서도 취약점 탐지 등 방어적 활용 능력을 키운 점은, 개발자·보안 실무자 대상 활용성을 함께 겨냥한 방향으로 풀이됩니다.
05활용 시나리오
코딩 에이전트나 자동화 워크플로우에 고성능 모델을 도입하려는 개발자가, 비용 대비 성능을 비교할 때 참고할 수 있습니다.
반복적으로 결과를 검증하며 목표에 도달해야 하는 장기 자동화 작업(문서 생성, 3D 모델링, 복잡한 리서치 등)에 이 모델의 적합성을 검토할 때 활용할 수 있습니다.
보안 담당자가 오픈소스 코드의 취약점 점검 자동화 도구로 AI 모델 도입을 검토할 때 참고 사례로 삼을 수 있습니다.
여러 AI 모델의 비용 대비 성능을 비교해 프로젝트에 맞는 모델을 선택하려는 실무자가 벤치마크 감을 잡는 데 참고할 수 있습니다.
06현황 및 전망
영상 시점 기준 Opus 5가 막 공개된 직후로, 소개된 수치는 모두 공개 벤치마크·자체 발표 자료에 근거한 것이며 영상 진행자도 "수치가 사실이라면"이라는 조건부 표현을 반복해 사용해 검증이 더 필요하다는 입장을 취합니다.
절반 가격에 준하는 성능이라는 포지셔닝이 실제 사용자 경험에서도 유지될지는 후속 실사용 후기·독립 벤치마크로 확인이 필요한 단계입니다.