01핵심 개요
| 항목 | 내용 |
|---|---|
| 주제 | 중국 문샷AI 신모델 키미 K3가 촉발한 GPU·메모리 수요 논쟁 |
| 채널 | 안될공학 |
| 모델 규모 | 전체 파라미터 2조 8천억, 문맥 100만 토큰 |
| MoE 구조 | 전문가 896개 중 토큰당 16개 선택 (활성 비율 약 1.8%) |
| 핵심 주장 | "효율 개선 = GPU 수요 감소"는 성급한 결론, 오히려 쓰임 확대 |
| 부가 논란 | 앤트로픽 클로드 대량 호출(증류) 의혹 |
02핵심 내용 구조
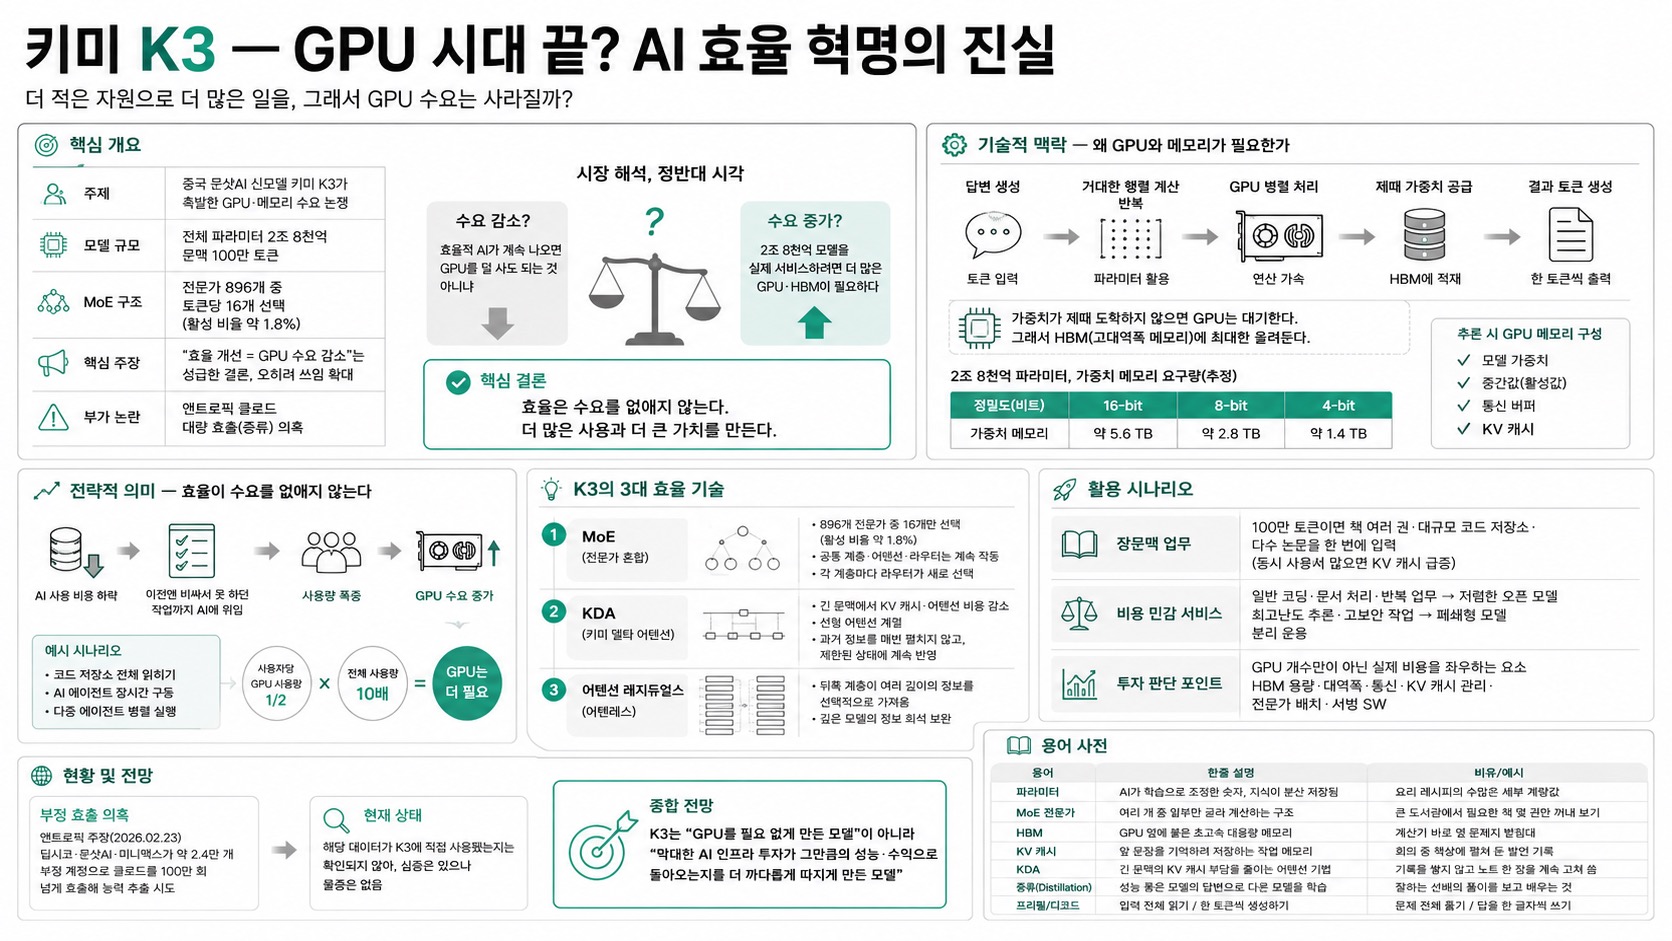
키미 K3는 이전 세대 K2 대비 같은 연산을 실제 성능으로 바꾸는 효율이 약 2.5배 높아졌다고 문샷AI가 주장한다. 시장은 이를 두고 정반대 해석을 동시에 냈다 — "효율적 AI가 계속 나오면 GPU를 덜 사도 되는 것 아니냐"(수요 감소)와 "2조 8천억 모델을 실제 서비스하려면 더 많은 GPU·HBM이 필요하다"(수요 증가). (0:00 딥링크)
03기술적 맥락 — 왜 GPU와 메모리가 필요한가
AI 답변 생성은 파라미터를 이용한 거대한 행렬 계산의 반복이다. GPU는 병렬 처리에 강해 이 계산에 적합하지만, 계산에 쓸 가중치가 제때 도착하지 않으면 GPU는 대기만 한다. 그래서 모델 가중치를 GPU 가까운 고대역폭 메모리(HBM)에 최대한 올려둔다. (4:14 딥링크)
추론 시 GPU 메모리에는 가중치뿐 아니라 중간값, 통신 버퍼, KV 캐시가 함께 들어간다. 2조 8천억 파라미터를 16비트로 저장하면 가중치만 약 5.6TB, 8비트면 약 2.8TB, 4비트로 줄여도 약 1.4TB다.
04전략적 의미 — 효율이 수요를 없애지 않는다
AI 사용 비용이 내려가면 기업은 절약분을 남겨두지 않고, 이전에는 비싸서 못 하던 작업까지 AI에 맡긴다. 코드 저장소 전체 읽히기, AI 에이전트 장시간 구동, 다중 에이전트 병렬 실행 등. 사용자당 GPU 사용량이 절반으로 줄어도 전체 사용량이 10배 늘면 GPU는 오히려 더 필요해진다. (25:07 딥링크)
05핵심 워크플로우 — K3의 3대 효율 기술
06활용 시나리오
- 장문맥 업무: 100만 토큰이면 책 여러 권·대규모 코드 저장소·다수 논문을 한 번에 입력. 다만 동시 사용자 수백 명이 긴 문서를 읽으면 KV 캐시 급증.
- 비용 민감 서비스: 일반 코딩·문서 처리·반복 업무는 저렴한 오픈 모델로, 최고난도 추론·고보안 작업은 폐쇄형 모델로 분리 운용.
- 투자 판단: GPU 개수만이 아니라 HBM 용량·대역폭·통신·KV 캐시 관리·전문가 배치·서빙 SW가 실제 비용을 좌우.
07현황 및 전망
앤트로픽은 2026년 2월 23일 딥시크·문샷AI·미니맥스가 약 2.4만 개 부정 계정으로 클로드를 100만 회 넘게 호출해 능력을 추출하려 했다고 주장했다. 다만 해당 데이터가 K3에 직접 사용됐는지는 확인되지 않아 심증만 있고 물증은 없는 상태다. (20:47 딥링크)
결론적으로 K3는 "GPU를 필요 없게 만든 모델"이 아니라 "막대한 AI 인프라 투자가 그만큼의 성능·수익으로 돌아오는지를 더 까다롭게 따지게 만든 모델"에 가깝다. 시장이 봐야 할 것은 'AI가 메모리를 덜 쓰게 됐느냐'가 아니라 '절약한 메모리로 AI가 얼마나 더 많은 일을 하게 되느냐'다.
08용어 사전
| 용어 | 한줄 설명 | 비유/예시 |
|---|---|---|
| 파라미터 | AI가 학습으로 조정한 숫자, 지식이 분산 저장됨 | 요리 레시피의 수많은 세부 계량값 |
| MoE | 전문가 여러 개 중 일부만 골라 계산하는 구조 | 큰 도서관에서 필요한 책 몇 권만 꺼내 보기 |
| HBM | GPU 옆에 붙은 초고속 대용량 메모리 | 계산기 바로 옆 문제지 받침대 |
| KV 캐시 | 앞 문장을 기억하려 저장하는 작업 메모리 | 회의 중 책상에 펼쳐 둔 발언 기록 |
| KDA | 긴 문맥의 KV 캐시 부담을 줄이는 어텐션 기법 | 기록을 쌓지 않고 노트 한 장을 계속 고쳐 씀 |
| 증류(Distillation) | 성능 좋은 모델의 답변으로 다른 모델을 학습 | 잘하는 선배의 풀이를 보고 배우는 것 |
| 프리필/디코드 | 입력 전체 읽기 / 한 토큰씩 생성하기 | 문제 전체 훑기 / 답을 한 글자씩 쓰기 |