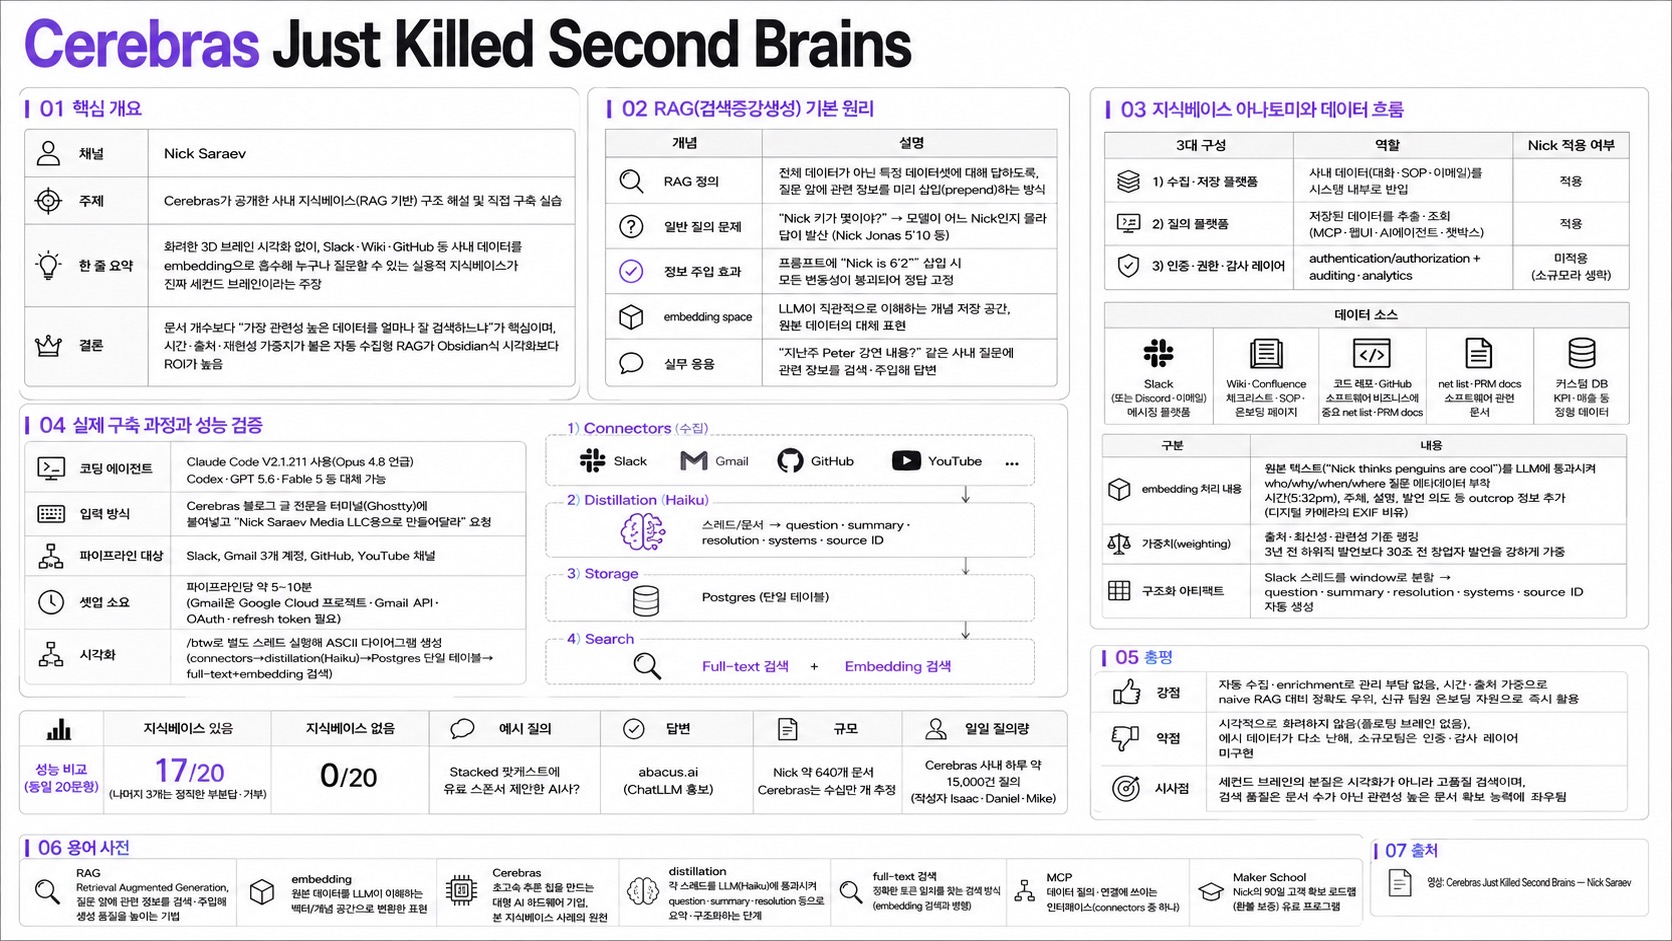
01핵심 개요
| 항목 | 내용 |
|---|
| 채널 | Nick Saraev |
| 주제 | Cerebras가 공개한 사내 지식베이스(RAG 기반) 구조 해설 및 직접 구축 실습 |
| 한 줄 요약 | 화려한 3D 브레인 시각화 없이, Slack·Wiki·GitHub 등 사내 데이터를 embedding으로 흡수해 누구나 질문할 수 있는 실용적 지식베이스가 진짜 세컨드 브레인이라는 주장 |
| 결론 | 문서 개수보다 "가장 관련성 높은 데이터를 얼마나 잘 검색하느냐"가 핵심이며, 시간·출처·재현성 가중치가 붙은 자동 수집형 RAG가 Obsidian식 시각화보다 ROI가 높음 |
02RAG(검색증강생성) 기본 원리 — 표 위주
| 개념 | 설명 |
|---|
| RAG 정의 | 전체 데이터가 아닌 특정 데이터셋에 대해 답하도록, 질문 앞에 관련 정보를 미리 삽입(prepend)하는 방식 |
| 일반 질의 문제 | "Nick 키가 몇이야?" → 모델이 어느 Nick인지 몰라 답이 발산(Nick Jonas 5'10 등) |
| 정보 주입 효과 | 프롬프트에 "Nick is 6'2" 삽입 시 모든 변동성이 붕괴되어 정답 고정 |
| embedding space | LLM이 직관적으로 이해하는 개념 저장 공간, 원본 데이터의 대체 표현 |
| 실무 응용 | "지난주 Peter 강연 내용?" 같은 사내 질문에 관련 정보를 검색·주입해 답변 |
03지식베이스 아나토미와 데이터 흐름 — 표 위주
| 3대 구성 | 역할 | Nick 적용 여부 |
|---|
| 1) 수집·저장 플랫폼 | 사내 데이터(대화·SOP·이메일)를 시스템 내부로 반입 | 적용 |
| 2) 질의 플랫폼 | 저장된 데이터를 추출·조회(MCP·웹UI·AI에이전트·챗박스) | 적용 |
| 3) 인증·권한·감사 레이어 | authentication/authorization + auditing·analytics | 미적용(소규모라 생략) |
| 데이터 소스 | 성격 |
|---|
| Slack(또는 Discord·이메일) | 사람들이 대화하는 메시징 플랫폼 |
| Wiki·Confluence | 체크리스트·SOP·온보딩 페이지 |
| 코드 레포·GitHub | 소프트웨어 비즈니스에 중요 |
| net list·PRM docs | 소프트웨어 관련 문서 |
| 커스텀 DB | KPI·매출 등 정형 데이터 |
| embedding 처리 | 내용 |
|---|
| 원리 | 원본 텍스트("Nick thinks penguins are cool")를 LLM에 통과시켜 who/why/when/where 질문 |
| 메타데이터 부착 | 시간(5:32pm), 주체, 설명, 발언 의도 등 outcrop 정보 추가(디지털 카메라의 EXIF 비유) |
| 가중치(weighting) | 출처·최신성·관련성 기준 랭킹, 3년 전 하위직 발언보다 30초 전 창업자 발언을 강하게 가중 |
| 구조화 아티팩트 | Slack 스레드를 window로 분할 → question·summary·resolution·systems·source ID 자동 생성 |
04실제 구축 과정과 성능 검증 — 표 위주
| 단계 | 내용 |
|---|
| 코딩 에이전트 | Claude Code V2.1.211 사용(Opus 4.8 언급), Codex·GPT 5.6·Fable 5 등 대체 가능 |
| 입력 방식 | Cerebras 블로그 글 전문을 터미널(Ghostty)에 붙여넣고 "Nick Saraev Media LLC용으로 만들어달라" 요청 |
| 파이프라인 대상 | Slack, Gmail 3개 계정, GitHub, YouTube 채널 |
| 셋업 소요 | 파이프라인당 약 5~10분(Gmail은 Google Cloud 프로젝트·Gmail API·OAuth·refresh token 필요) |
| 시각화 | /btw로 별도 스레드 실행해 ASCII 다이어그램 생성(connectors→distillation(Haiku)→Postgres 단일 테이블→full-text+embedding 검색) |
| 성능 비교 | 지식베이스 있음 | 지식베이스 없음 |
|---|
| 동일 20문항 정답 | 17/20 정답(나머지 3개는 정직한 부분답·거부) | 0/20 |
| 예시 질의 | Stacked 팟캐스트에 유료 스폰서 제안한 AI사 → abacus.ai(ChatLLM 홍보) | 답변 불가 |
| 규모 | Nick 약 640개 문서 | Cerebras는 수십만 개 추정 |
| 일일 질의량 | Cerebras 사내 하루 약 15,000건 질의(작성자 Isaac·Daniel·Mike) | — |
05총평
| 구분 | 내용 |
|---|
| 강점 | 자동 수집·enrichment로 관리 부담 없음, 시간·출처 가중으로 naive RAG 대비 정확도 우위, 신규 팀원 온보딩 자원으로 즉시 활용 |
| 약점 | 시각적으로 화려하지 않음(플로팅 브레인 없음), 예시 데이터가 다소 난해, 소규모팀은 인증·감사 레이어 미구현 |
| 시사점 | 세컨드 브레인의 본질은 시각화가 아니라 고품질 검색이며, 검색 품질은 문서 수가 아닌 관련성 높은 문서 확보 능력에 좌우됨 |
06용어 사전
| 용어 | 설명 |
|---|
| RAG | Retrieval Augmented Generation, 질문 앞에 관련 정보를 검색·주입해 생성 품질을 높이는 기법 |
| embedding | 원본 데이터를 LLM이 이해하는 벡터/개념 공간으로 변환한 표현 |
| Cerebras | 초고속 추론 칩을 만드는 대형 AI 하드웨어 기업, 본 지식베이스 사례의 원천 |
| distillation | 각 스레드를 LLM(Haiku)에 통과시켜 question·summary·resolution 등으로 요약·구조화하는 단계 |
| full-text 검색 | 정확한 토큰 일치를 찾는 검색 방식(embedding 검색과 병행) |
| MCP | 데이터 질의·연결에 쓰이는 인터페이스(connectors 중 하나) |
| Maker School | Nick의 90일 고객 확보 로드맵(환불 보증) 유료 프로그램 |