01핵심 개요
| 항목 | 내용 |
|---|---|
| 채널 | Chase AI |
| 주제 | 중국산 오픈웨이트 모델 Kimmy K3가 GPT 5.6, Fable 5를 실제로 이길 수 있는지 벤치마크와 실전 프런트엔드 테스트로 검증 |
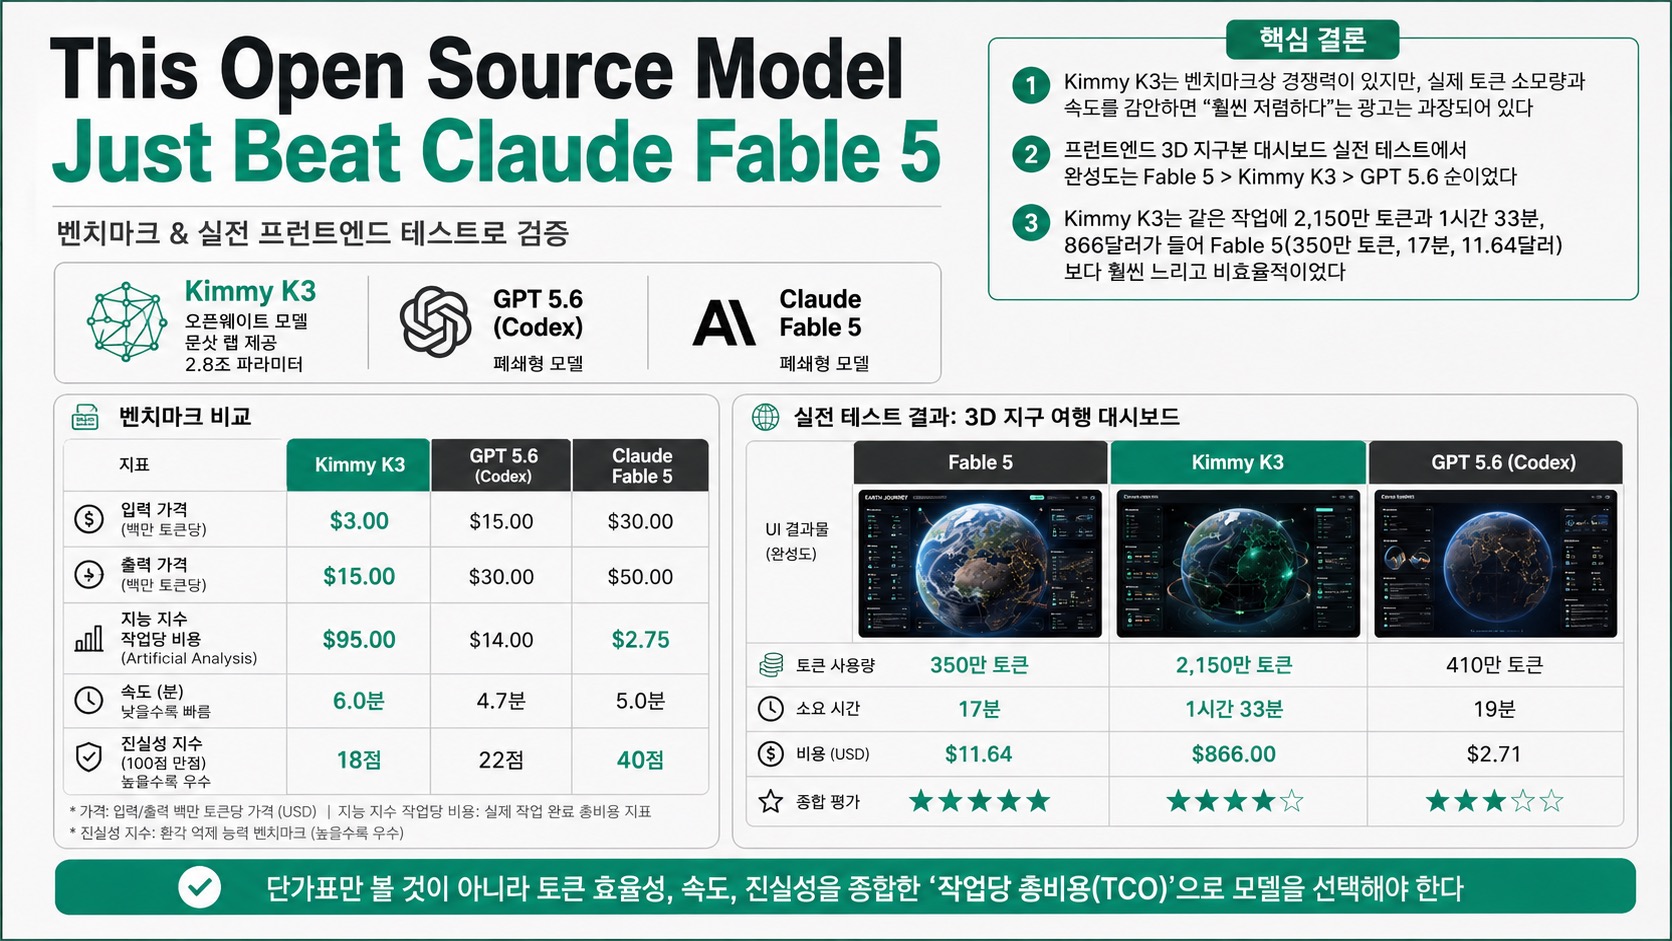
| 한 줄 요약 | Kimmy K3는 벤치마크상 경쟁력이 있지만, 실제 토큰 소모량과 속도를 감안하면 "훨씬 저렴하다"는 광고는 과장되어 있다 |
| 핵심 결론 1 | Kimmy K3는 입력 기준 백만 토큰당 3달러로 표면 가격은 가장 저렴하지만, 토큰 효율성이 낮아 실제 작업당 비용은 GPT 5.6과 큰 차이가 없다 |
| 핵심 결론 2 | 프런트엔드 3D 지구본 대시보드 실전 테스트에서 완성도는 Fable 5 > Kimmy K3 > GPT 5.6 순이었다 |
| 핵심 결론 3 | Kimmy K3는 같은 작업에 2,150만 토큰과 1시간 33분, 866달러가 들어 Fable 5(350만 토큰, 17분, 11.64달러)보다 훨씬 느리고 비효율적이었다 |
02핵심 내용 구조
영상은 크게 두 축으로 구성된다. 전반부는 Kimmy K3(문샷 랩 제공, 2.8조 파라미터 규모의 오픈웨이트 모델)를 둘러싼 벤치마크 수치를 검증한다. 프로그래밍 벤치마크와 arena.ai의 블라인드 프런트엔드 투표 결과에서는 Kimmy K3가 GPT 5.6, Fable 5와 대등하거나 앞서는 것으로 나타났지만, 진행자는 이를 곧이곧대로 믿지 않고 가격·토큰 효율성·속도·환각(진실성) 지수까지 함께 살펴본다. 후반부는 Claude Code와 Codex 환경에서 Kimmy K3, Fable 5, GPT 5.6에 동일한 "3D 지구 여행 대시보드" 제작 프롬프트를 주고 결과물과 실제 소요 토큰·시간·비용을 비교하는 실전 테스트다. 결론적으로 벤치마크상의 저렴함과 실사용 비용 사이에 상당한 괴리가 있다는 점이 이 영상의 핵심 메시지다.
03기술적 맥락
Kimmy K3는 오픈웨이트(open-weight) 모델로, 모든 매개변수 값을 확인할 수 있다는 점에서 GPT 5.6이나 Fable 5 같은 폐쇄형 모델과 구분된다. 다만 오픈웨이트라고 해서 일반 사용자의 컴퓨터에서 구동 가능하다는 뜻은 아니며, 실제 운용에는 수백만 달러 규모의 하드웨어가 필요하다. 가격 비교에서 Kimmy K3는 입력 백만 토큰당 3달러, 출력 기준으로도 GPT 5.6의 절반 이하, Fable 5의 30% 수준으로 표기 단가는 가장 낮다. 그러나 Artificial Analysis(독립 벤치마킹 기관)의 "지능 지수 작업당 비용" 지표로 보면 Kimmy K3는 작업당 95달러, GPT 5.6은 14달러로 오히려 Kimmy K3가 더 비싸게 나타났고, Fable 5는 2.75달러로 셋 중 가장 저렴했다. 이는 Kimmy K3가 동일 작업을 처리하는 데 훨씬 더 많은 토큰을 소모하는 토큰 비효율성 때문이다. 속도 면에서도 Kimmy K3는 6분, Fable 5는 5분, GPT 5.6은 4.7분이 걸려 Kimmy K3가 가장 느렸다. 진실성(환각 억제) 벤치마크에서는 100점 만점에 Fable 5가 40점, GPT 5.6이 22점, Kimmy K3가 18점으로 Kimmy K3가 가장 낮았다.
04전략적 의미
이 영상이 시사하는 바는 "오픈소스=저렴함"이라는 공식이 헤드라인 가격표만으로는 성립하지 않는다는 점이다. 실제 프로덕션 워크로드에서는 토큰 소모량, 처리 속도, 환각률까지 종합한 "작업당 총비용(TCO)"으로 판단해야 하며, 이 기준에서는 GPT 5.6처럼 토큰 효율성이 높은 폐쇄형 모델이 오히려 경쟁력을 가질 수 있다. 기업이나 개발자가 Kimmy K3 같은 중국산 오픈웨이트 모델 도입을 검토할 때는 단가표가 아니라 실제 벤치마크 작업 단위 비용과 응답 속도, 워크플로우 특성(긴 대기 시간 허용 여부)을 함께 고려해야 한다. 동시에 오픈웨이트 모델이 프런트엔드 코딩 같은 영역에서 프론티어 폐쇄형 모델과 대등한 수준까지 따라왔다는 점은, 중국 AI 생태계의 빠른 추격 속도를 보여주는 신호이기도 하다.
05핵심 워크플로우·방법론
진행자는 세 모델(Kimmy K3, Fable 5, GPT 5.6/Codex)에 Claude Code 및 Codex 환경 안에서 동일한 프롬프트를 부여하는 방식으로 통제된 비교 테스트를 수행했다. 프롬프트는 "단순 웹사이트가 아니라 SF 영화의 한 장면 같은 3D 지구 여행 대시보드를 만들되, 전에 본 적 없는 아이디어로 놀라게 해달라"는 개방형 지시였으며, 결과 편향을 막기 위해 구체적 요구사항은 의도적으로 제한했다. 평가는 (1) UI 완성도와 인터랙션(확대·축소, 도시 클릭, 낮과 밤 전환, 통계 정보 표시) 정성 비교, (2) Open Router 데이터를 통한 토큰 사용량·소요 시간·비용 정량 비교의 두 단계로 이뤄졌다. 이런 "블라인드 프롬프트 동일 조건 + 정성/정량 이중 평가" 방식은 벤치마크 수치와 실사용 체감 품질 사이의 괴리를 검증하는 데 유용한 방법론이다.
06활용 시나리오
- 모델 선택 의사결정: 신규 프로젝트에 사용할 LLM을 고를 때 표기 단가가 아니라 작업당 실제 토큰 소모량과 처리 시간을 기준으로 비교해 비용 리스크를 사전에 파악한다.
- 프런트엔드 프로토타이핑: 3D 인터랙티브 대시보드, 랜딩 페이지 등 시각적 완성도가 중요한 프로젝트에서는 Fable 5처럼 그래픽 디테일과 인터랙션 완성도가 높은 모델을 우선 검토한다.
- 대규모 배치 작업 비용 산정: Kimmy K3처럼 단가는 낮지만 토큰 소모가 많은 모델을 대량 배치 작업에 투입하기 전, Artificial Analysis류의 "작업당 비용" 지표로 실제 총비용을 시뮬레이션한다.
- 시간 민감 워크플로우 배제 기준: 실시간 응답이나 빠른 반복이 필요한 에이전트 워크플로우에는 속도가 느린 Kimmy K3 대신 GPT 5.6이나 Fable 5 같은 상대적으로 빠른 모델을 우선 고려한다.
- 환각 민감 도메인 필터링: 법률·의료 등 정답 여부가 중요한 모호한 질의 응답 작업에는 진실성 지수가 가장 높은 Fable 5를 우선 배치한다.
07현황 및 전망
현재 시점에서 Kimmy K3는 arena.ai 블라인드 투표 등 일부 벤치마크에서 프런트엔드 코드 생성 최고 성능을 보이며 화제를 모으고 있지만, 이는 주관적 선호도 조사라는 한계가 있다. 실전 테스트 결과 종합 완성도는 Fable 5, Kimmy K3, GPT 5.6 순이었고, 비용·속도 효율성에서는 Codex(GPT 5.6 계열)가 가장 저렴했으며 Fable 5가 가장 비쌌다. 진행자는 Kimmy K3가 "이론상 매우 강력한" 경쟁력 있는 오픈소스 모델이라는 점은 인정하면서도, 토큰 비효율성으로 인한 숨은 비용과 느린 속도 때문에 벤치마크가 보여주는 "압도적 저비용" 서사를 그대로 받아들여서는 안 된다고 결론짓는다. 향후 오픈웨이트 모델들이 토큰 효율성을 개선한다면 프론티어 폐쇄형 모델과의 실질적 총비용 격차는 더 좁혀질 것으로 예상된다.
08용어 사전
| 용어 | 한줄 설명 | 비유/예시 |
|---|---|---|
| 오픈웨이트(Open-weight) | 모델 파라미터 값을 공개하지만 실행엔 고가 하드웨어 필요 | 레시피는 공개되지만 재료·주방은 별도로 구비해야 하는 요리법 |
| 토큰 효율성 | 동일 작업 수행에 필요한 토큰(연산량) 대비 결과물 비율 | 같은 목적지까지 연비 좋은 차 vs 기름 많이 먹는 차 |
| 지능 지수 작업당 비용 | Artificial Analysis가 산출하는, 단가가 아닌 실제 작업 완료 총비용 지표 | 시간당 인건비가 아니라 프로젝트 완료까지 든 총 인건비 |
| arena.ai 블라인드 투표 | 두 모델 결과물을 익명으로 보여주고 사용자가 선호를 고르는 벤치마크 | 브랜드 가린 펩시 챌린지 |
| 진실성(전지성) 지수 | 정답·오답·모름 응답에 가중치를 매겨 환각 정도를 측정하는 벤치마크 | 모르면 감점 없이 0점, 틀리면 감점되는 퀴즈 채점 방식 |