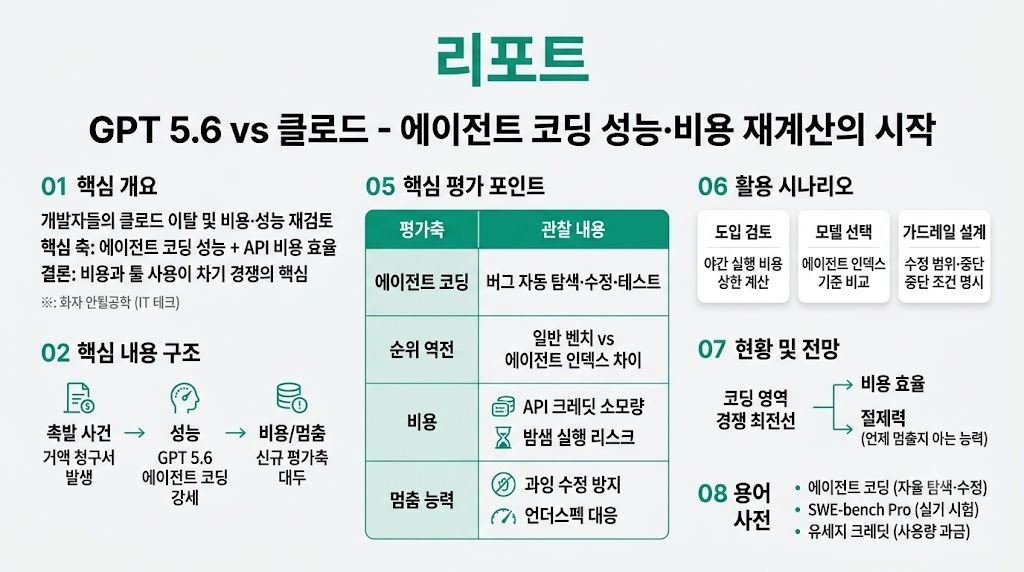
01핵심 개요
| 항목 | 내용 |
|---|---|
| 주제 | GPT 5.6 등장 후 개발자들이 클로드에서 갈아타며 성능·비용을 재계산 |
| 핵심 축 | 에이전트 코딩 성능 + API 비용 효율 |
| 결론 | 코딩이 다음 AI 모델 경쟁의 예고편 — 성능만큼 비용·툴 사용이 관건 |
| 화자 | 안될공학 (IT 테크 신기술) |
02핵심 내용 구조
- 촉발 사건: 클로드를 잠깐 썼는데 거액 청구서가 찍힌 사례 → 개발자들이 비용을 재계산하며 경쟁 제품 재설치.
- 성능: GPT 5.6이 에이전트 코딩(버그 위치를 직접 찾아 끝까지 수정) 영역에서 강세. 단순 벤치 순위와 에이전트 인덱스 순위가 다르게 나옴.
- 비용 민감도: "밤새 돌려놔도 괜찮을까?"가 핵심 질문. 사용량·크레딧 소모가 커 가격 예민.
- 멈춤 능력: 언더스펙(불충분한 지시) 상황에서 모델이 과잉 수정·불필요한 파일 수정을 자주 함. "어디서 멈춰야 하는지 아는 능력"이 새 평가축.
03기술적 맥락
코드는 글·그림과 달리 틀리면 고치면 되므로 에이전트가 자율적으로 터미널 실행·테스트 재전달을 반복. Sol Ultra는 복잡 작업을 여러 단계로 밀어붙이는 방향. SWE-bench Pro 결과에서는 페이블 5가 강한 평가를 받음.
04전략적 의미
강력한 모델을 이미 잘 쓰는 팀에게는 성능·비용 효율 조합이 매력적. GPT와 클로드의 다음 경쟁에서 비용 구조와 툴 사용 방식이 승부처가 될 전망.
05핵심 워크플로우 / 평가 포인트
06활용 시나리오
- 에이전트 코딩 도입 검토: 성능뿐 아니라 야간 배치 실행 시 비용 상한을 먼저 계산.
- 모델 선택: 단순 벤치 순위가 아니라 에이전트 인덱스 기준으로 비교.
- 가드레일 설계: 과잉 수정 방지를 위해 수정 범위·중단 조건을 명시적으로 지시.
07현황 및 전망
코딩 영역이 AI 모델 경쟁의 최전선. 성능 상향 평준화 속에서 비용 효율과 "언제 멈출지"를 아는 절제력이 차기 경쟁의 핵심 변수가 될 것.
08용어 사전
| 용어 | 한줄 설명 | 비유/예시 |
|---|---|---|
| 에이전트 코딩 | AI가 스스로 코드 탐색·수정·테스트를 반복하는 방식 | 스스로 고칠 곳을 찾아 손보는 자율 정비공 |
| SWE-bench Pro | 실제 소프트웨어 버그 수정 능력을 재는 시험 | 개발자용 실기 시험 |
| 언더스펙 | 지시가 불충분한 상태 | 대충 시켰더니 엉뚱한 데까지 손대는 상황 |
| 유세지 크레딧 | API 사용량 기반 과금 단위 | 쓴 만큼 차감되는 선불 충전금 |