Nate HerkMORNING DIGEST · 2026-07-12 · Nate Herk🎬 영상
GPT 5.6 Sol vs Claude Fable 5 — 하루 종일 써본 실사용 비교
title: GPT 5.6 Sol vs Claude Fable 5 — 하루 종일 써본 실사용 비교
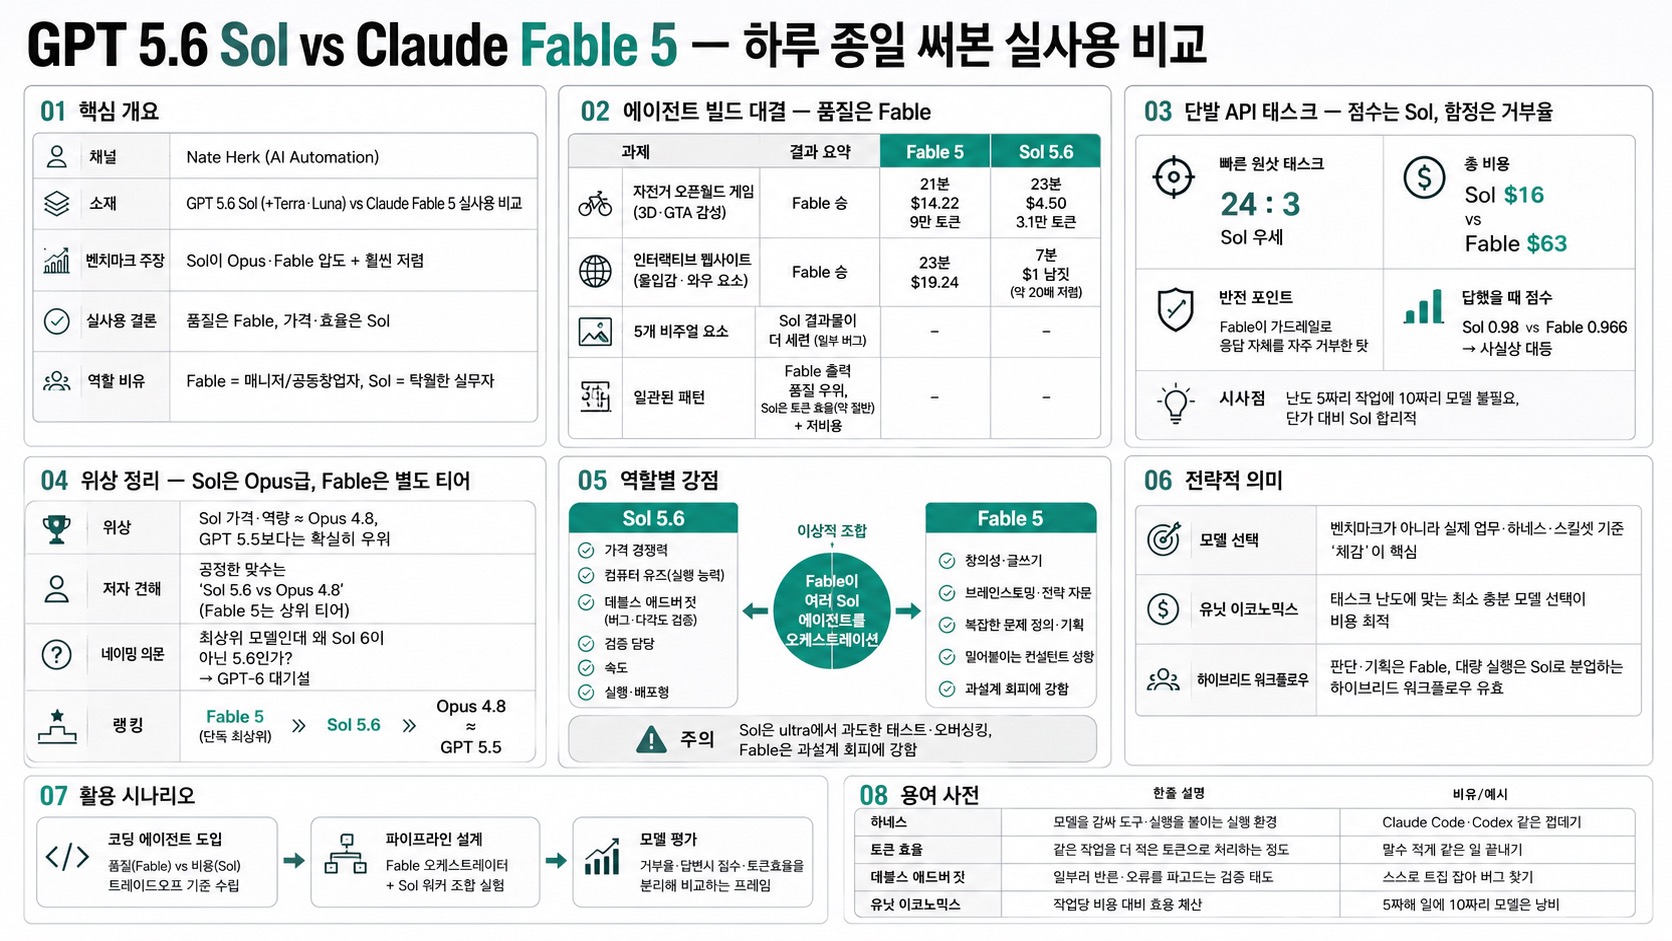
01핵심 개요
| 항목 | 내용 |
|---|
| 채널 | Nate Herk (AI Automation) |
| 소재 | GPT 5.6 Sol(+Terra·Luna) vs Claude Fable 5 실사용 비교 |
| 벤치마크 주장 | Sol이 Opus·Fable 압도 + 훨씬 저렴 |
| 실사용 결론 | 품질은 Fable, 가격·효율은 Sol |
| 역할 비유 | Fable=매니저/공동창업자, Sol=탁월한 실무자 |
02에이전트 빌드 대결 — 품질은 Fable
- 자전거 오픈월드 게임 = Fable 승(3D·GTA 감성), Fable 21분·$14.22·9만 토큰 vs Sol 23분·$4.50·3.1만 토큰
- 인터랙티브 웹사이트 = Fable 승(몰입감·와우 요소), Fable 23분·$19.24 vs Sol 7분·$1 남짓(약 20배 저렴)
- 5개 비주얼 요소 = Sol 결과물이 더 세련(단 일부 버그)
- 일관된 패턴 = Fable 출력 품질 우위, Sol은 토큰 효율(약 절반) + 저비용
03단발 API 태스크 — 점수는 Sol, 함정은 거부율
- 빠른 원샷 태스크 24:3으로 Sol 우세, 비용 Sol $16 vs Fable $63
- 반전 = Fable이 가드레일로 응답 자체를 자주 거부한 탓
- 답했을 때 점수 = Sol 0.98 vs Fable 0.966 → 사실상 대등
- 시사점 = 난도 5짜리 작업에 10짜리 모델 불필요, 단가 대비 Sol 합리적
04위상 정리 — Sol은 Opus급, Fable은 별도 티어
- Sol 가격·역량 ≈ Opus 4.8, GPT 5.5보다는 확실히 우위
- 저자 견해 = 공정한 맞수는 'Sol 5.6 vs Opus 4.8' (Fable 5는 상위 티어)
- 네이밍 의문 = 최상위 모델인데 왜 Sol 6이 아닌 5.6인가 → GPT-6 대기설
- 랭킹 = Fable 5(단독 최상위) ≫ Sol ≫ Opus 4.8 ≈ GPT 5.5
05역할별 강점
- Sol = 가격, 컴퓨터 유즈, 데블스 애드버킷(버그·다각도 검증), 검증 담당, 속도, "실행·배포형"
- Fable = 창의성·글쓰기·브레인스토밍·전략 자문, 밀어붙이는 컨설턴트 성향
- 이상적 조합 = Fable이 여러 Sol 에이전트를 오케스트레이션
- 주의 = Sol은 ultra에서 과도한 테스트·오버싱킹, Fable은 과설계 회피에 강함
06전략적 의미
- 모델 선택 = 벤치마크가 아니라 실제 업무·하네스·스킬셋 기준 "체감"이 핵심
- 유닛 이코노믹스 = 태스크 난도에 맞는 최소 충분 모델 선택이 비용 최적
- 판단·기획은 Fable, 대량 실행은 Sol로 분업하는 하이브리드 워크플로우 유효
07활용 시나리오
- 코딩 에이전트 도입 → 품질(Fable) vs 비용(Sol) 트레이드오프 기준 수립
- 파이프라인 설계 → Fable 오케스트레이터 + Sol 워커 조합 실험
- 모델 평가 → 거부율·답변시 점수·토큰효율을 분리해 비교하는 프레임
08용어 사전
| 용어 | 한줄 설명 | 비유/예시 |
|---|
| 하네스 | 모델을 감싸 도구·실행을 붙이는 실행 환경 | Claude Code·Codex 같은 껍데기 |
| 토큰 효율 | 같은 작업을 더 적은 토큰으로 처리하는 정도 | 말수 적게 같은 일 끝내기 |
| 데블스 애드버킷 | 일부러 반론·오류를 파고드는 검증 태도 | 스스로 트집 잡아 버그 찾기 |
| 유닛 이코노믹스 | 작업당 비용 대비 효용 계산 | 5짜리 일에 10짜리 모델은 낭비 |