01핵심 개요
| 항목 | 내용 |
|---|---|
| 채널 | Chase AI |
| 대주제 | GPT 5.6 Sol과 Claude Fable을 "누가 더 나은가"로 겨루지 않고 한 워크플로우에 결합하는 클로드 코드 스킬 소개 |
| 핵심 메시지 | 계획·검토는 Fable이 주도하고 실행(빌드)은 더 저렴하고 토큰 효율이 좋은 Codex(GPT 5.5→5.6)에 넘겨 두 모델의 장점 + 토큰 절감을 동시에 얻는다 |
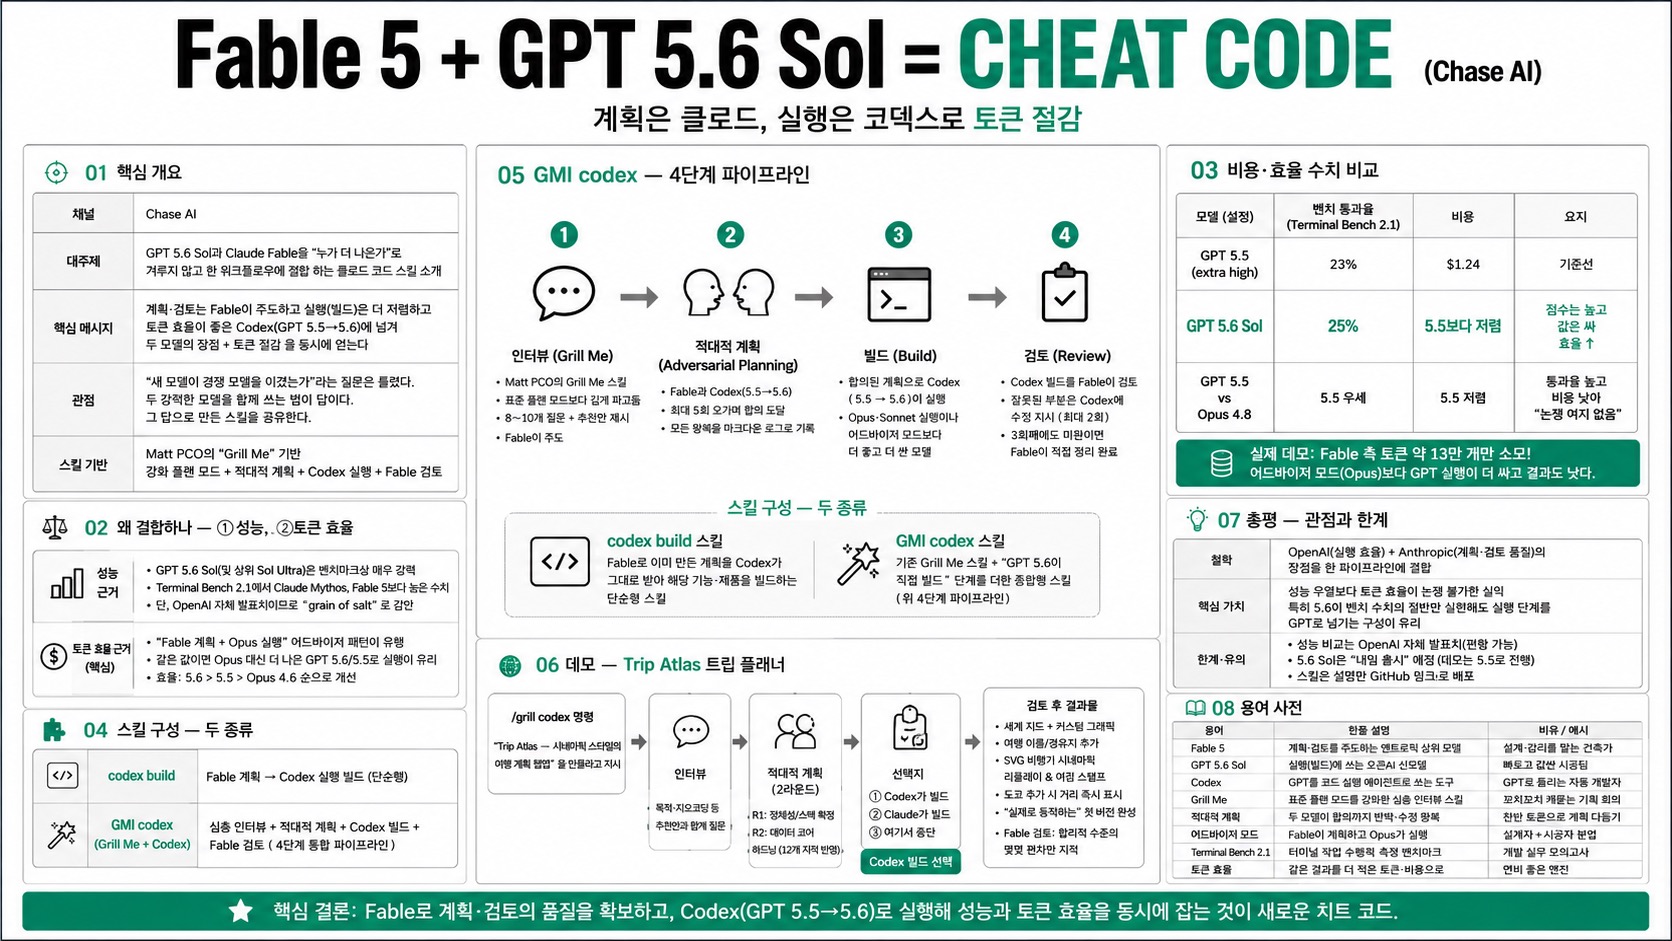
발표자는 "새 모델이 경쟁 모델을 이겼는가"라는 질문 자체가 틀렸다고 본다. 두 강력한 모델을 함께 쓰는 법을 물어야 하며, 그 답으로 자신이 만든 스킬을 공유한다. 스킬은 Matt PCO의 "Grill Me"에 기반한 강화 플랜 모드 + Claude와 Codex의 적대적(adversarial) 계획 협상 + Codex 실행 + Fable 검토를 하나로 묶는다.
02왜 결합하나 — ① 성능, ② 토큰 효율
- 성능 근거: GPT 5.6 Sol(및 상위 Sol Ultra)은 벤치마크상 매우 강력하다. Terminal Bench 2.1에서 Claude Mythos는 물론 Fable 5보다 앞선 수치를 보인다. 단, 이는 OpenAI 자체 발표치라 발표자도 "grain of salt(감안해서 보라)"라고 단서를 단다.
- 토큰 효율 근거(핵심): "Fable에게 계획시키고 Opus로 실행"하는 어드바이저 패턴이 유행하지만, 같은 값이면 Opus 대신 더 나은 GPT 5.6/5.5로 실행하는 편이 낫다. 효율은 5.6 > 5.5 > Opus 4.6 순으로 개선된다는 게 데이터의 요지다.
03비용·효율 수치 비교
| 모델(설정) | 벤치 통과율 | 비용 | 요지 |
|---|---|---|---|
| GPT 5.5 (extra high) | 23% | $1.24 | 기준선 |
| GPT 5.6 Sol | 25% | 5.5보다 저렴 | 점수는 높고 값은 싸 효율↑ |
| GPT 5.5 vs Opus 4.8 | 5.5 우세 | 5.5 저렴 | 통과율 높고 비용 낮아 "논쟁 여지 없음" |
발표자는 실제 데모에서 전체 작업에 Fable 측 토큰 약 13만 개만 소모했다고 강조한다. 어드바이저 모드로 Opus를 붙이는 것보다 GPT 실행이 더 싸고 결과도 낫다는 게 반복되는 결론이다.
04스킬 구성 — 두 종류
- codex build 스킬: Fable로 이미 만든 계획을 Codex가 그대로 받아 해당 기능·제품을 빌드하는 단순형.
- grillme codex(GMI codex) 스킬: 기존 grillme 스킬에 "GPT 5.6이 직접 빌드" 단계를 더한 종합형. 아래 4단계로 동작한다.
05GMI codex — 4단계 파이프라인
- 인터뷰(Grill Me): Matt PCO의 grill me 스킬 그대로. 표준 플랜 모드보다 훨씬 깊게 파고드는 "스테로이드 플랜 모드". Fable이 주도해 8~10개 질문을 던지며, 각 질문마다 추천안까지 제시한다.
- 적대적 계획(Adversarial planning): Fable의 계획을 Codex(오늘 5.5, 내일 5.6)에 넘긴다. Fable과 Codex가 최대 5회 오가며 합의에 도달한다. 모든 왕복은 마크다운 파일에 로그로 남는다.
- 빌드: 합의된 계획으로 실제 빌드를 Codex(5.5→5.6)에 맡긴다. 발표자는 이를 Opus·Sonnet 실행이나 어드바이저 모드보다 낫다고 본다(더 좋고 더 싼 모델이라).
- 검토(Review): Codex 빌드를 Fable이 되짚어 검토. 잘못된 부분은 Codex에 수정 지시(최대 2회). 3회째에도 미완이면 Fable이 직접 코드를 정리해 마무리한다.
06데모 — Trip Atlas 트립 플래너
/grill codex 명령에 "Trip Atlas — 시네마틱 스타일의 여행 계획 웹앱"을 만들라고 지시. 진행 흐름:
- 인터뷰: "이건 무엇을 위한 것인가"(→ 영상 데모가 아닌 실제 개인 도구), 지오코딩 방식 등을 추천안과 함께 질문.
- 적대적 계획(2라운드): 라운드1에서 정체성 고정(실제 개인 도구·스택 확정), 라운드2에서 데이터 코어 하드닝 관련 12개 지적을 반영해 승인.
- 선택지: 합의 후 ① Codex가 빌드 ② Claude가 빌드 ③ 여기서 중단 중 택1. 데모는 Codex 빌드 선택.
- 검토 후 결과물: 세계 지도 + GPT 이미지 생성기로 만든 커스텀 그래픽, 여행 이름 지정·경유지 추가, SVG 비행기가 지점을 오가는 시네마틱 리플레이와 여권 스탬프 연출. 도쿄를 추가하면 경유지 간 거리를 즉시 표시하는 등 "실제로 동작하는" 첫 버전을 완성. Fable 검토는 "합리적 수준의 몇몇 편차"만 지적.
07총평 — 관점과 한계
- 철학: OpenAI(실행 효율)와 Anthropic(계획·검토 품질)의 장점을 한 파이프라인에 결합. "GPT/Codex에 극도로 반감이 없는 한" 어드바이저 모드로 Opus를 쓸 이유가 줄어든다는 주장.
- 핵심 가치: 성능 우열보다 토큰 효율이 논쟁 불가한 실익. 특히 5.6이 벤치 수치의 절반만 실현해도 실행 단계를 GPT로 넘기는 구성이 유리하다.
- 한계·유의: 성능 비교는 OpenAI 자체 발표치(편향 가능). 5.6 Sol은 영상 시점 기준 "내일 출시" 예정으로, 데모 실행은 5.5로 진행됐다. 스킬은 설명란 GitHub 링크로 배포.
08용어 사전
| 용어 | 한줄 설명 | 비유/예시 |
|---|---|---|
| Fable 5 | 계획·검토를 주도하는 앤트로픽 상위 모델 | 설계·감리를 맡는 건축가 |
| GPT 5.6 Sol | 실행(빌드)에 쓰는 오픈AI 신모델 | 빠르고 값싼 시공팀 |
| Codex | GPT를 코드 실행 에이전트로 쓰는 도구 | GPT로 돌리는 자동 개발자 |
| Grill Me | 표준 플랜 모드를 강화한 심층 인터뷰 스킬 | 꼬치꼬치 캐묻는 기획 회의 |
| 적대적 계획 | 두 모델이 합의까지 반박·수정 왕복 | 찬반 토론으로 계획 다듬기 |
| 어드바이저 모드 | Fable이 계획하고 Opus가 실행하는 구성 | 설계자+시공자 분업 |
| Terminal Bench 2.1 | 터미널 작업 수행력 측정 벤치마크 | 개발 실무 모의고사 |
| 토큰 효율 | 같은 결과를 더 적은 토큰·비용으로 | 연비 좋은 엔진 |