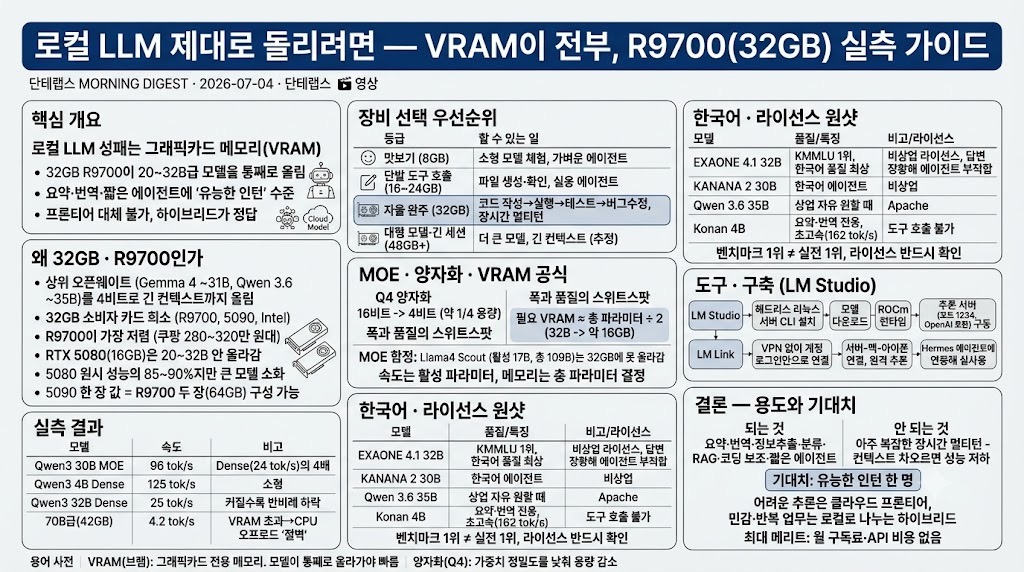
체감 성능 상위 오픈웨이트(구글 Gemma 4 ~31B, 알리바바 Qwen 3.6 ~35B)를 4비트로 긴 컨텍스트까지 올리려면 딱 32GB가 필요. 32GB 소비자 카드는 R9700·5090·인텔 일부뿐이며 R9700이 가장 저렴(쿠팡 실거래 280~320만 원대). RTX 5080(16GB)은 20~32B가 안 올라감. 원시 성능은 5080의 85~90%지만 5090이 못 올리는 큰 모델을 소화. 5090 한 장 값이면 R9700 두 장(64GB) 구성 가능.
04MOE·양자화·VRAM 공식
Q4 양자화: 16비트를 4비트로 낮춰 용량 약 1/4. 폭과 품질의 스위트스팟.
필요 VRAM ≈ 총 파라미터 ÷ 2 (32B → 약 16GB).
MOE 함정: 라마4 스카우트는 활성 17B지만 총 109B라 32GB에 못 올라감. 속도는 활성 파라미터가, 메모리는 총 파라미터가 결정.
05실측 결과
모델
속도
비고
Qwen3 30B MOE
96 tok/s
같은 크기 Dense(24 tok/s)의 4배
Qwen3 4B Dense
125 tok/s
소형
Qwen3 32B Dense
25 tok/s
커질수록 반비례 하락
70B급(42GB)
4.2 tok/s
VRAM 초과→CPU 오프로드 '절벽'
06한국어·라이선스
원샷 한국어 품질 1위: EXAONE 4.1 32B(KMMLU 1위) — 단 비상업 라이선스, 답변 장황해 에이전트 부적합.
한국어 에이전트: KANANA 2 30B(비상업), 상업 자유 원하면 Qwen 3.6 35B(Apache).
요약·번역 전용: Konan 4B(162 tok/s, 도구 호출 불가).
교훈: 벤치마크 1위 ≠ 실전 1위, 라이선스 반드시 확인.
07도구·구축(LM Studio)
LM Studio로 헤드리스 리눅스 서버에 CLI만으로 설치→모델 다운로드→ROCm 런타임→추론 서버(포트 1234, OpenAI 호환) 구동. LM Link로 VPN 없이 계정 로그인만으로 서버-맥-아이폰 연결, 원격 추론. 이후 Hermes 에이전트에 연동해 실사용 검증.
08결론 — 용도와 기대치
되는 것: 요약·번역·정보추출·분류·RAG·코딩 보조·짧은 에이전트. 안 되는 것: 아주 복잡한 장시간 멀티턴(컨텍스트 차오르면 성능 저하). 기대치는 '유능한 인턴 한 명'. 어려운 추론은 클라우드 프론티어, 민감·반복 업무는 로컬로 나누는 하이브리드 권장. 최대 메리트는 월 구독료·API 비용 없음.