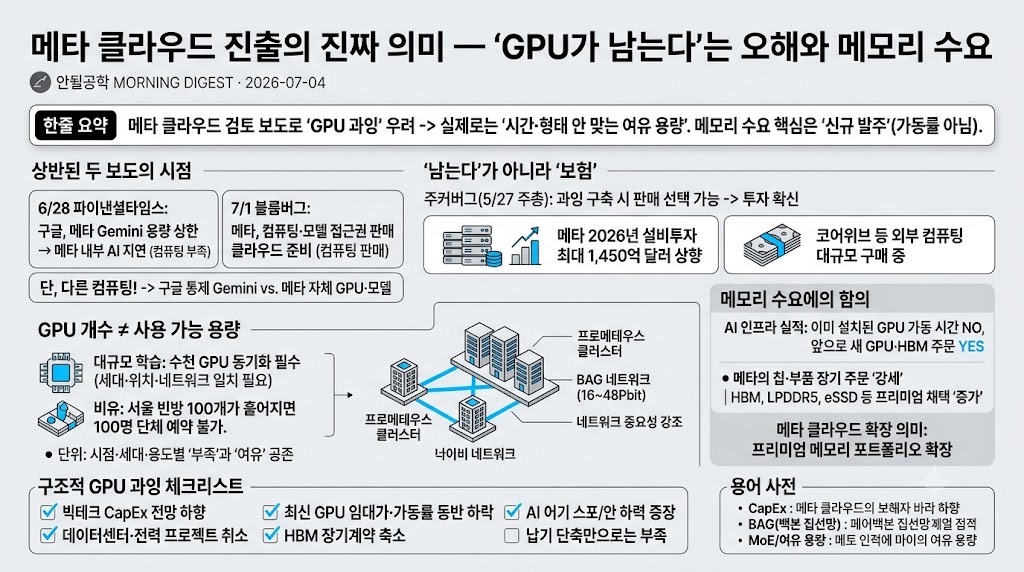
01핵심 개요
| 항목 | 내용 |
|---|---|
| 채널 | 안될공학 |
| 한줄 요약 | 메타 클라우드 사업 검토 보도로 'GPU 과잉' 우려가 돌았으나, 남는 GPU가 아니라 '시간·형태가 안 맞는 여유 용량'. 메모리 수요 핵심은 가동률이 아니라 '신규 발주' |
02상반된 두 보도
| 시점 | 매체 | 내용 |
|---|---|---|
| 6/28 | 파이낸셜타임스 | 구글이 메타의 Gemini 사용 용량에 상한 → 메타 내부 AI 일정 지연 |
| 7/1 | 블룸버그 | 메타가 컴퓨팅·모델 접근권 판매하는 클라우드 인프라 사업 준비 |
같은 회사를 두고 한쪽은 "컴퓨팅 부족", 다른 쪽은 "남는 컴퓨팅 판매". 단 두 컴퓨팅은 다름 — 하나는 구글이 통제하는 Gemini 용량, 다른 하나는 메타 자체 GPU·모델 인프라.
03'남는다'가 아니라 '보험'
주커버그(5/27 주총): "과잉 구축이라 느끼는 시점이 온다면 (판매도) 우리의 선택지이고, 이것이 투자를 계속할 확신을 준다." 즉 팔겠다는 계획은 '지금 남는다'는 고백이 아니라 '남더라도 손해가 아니다'라는 보험 성격. 실제로 메타는 2026년 설비투자 전망을 최대 1,450억 달러로 상향, 코어위브와 누적 약 352억 달러 계약 등 외부 컴퓨팅도 대규모 구매 중.
04GPU 개수 ≠ 사용 가능 용량
대규모 학습은 수천 GPU가 같은 작업을 나눠 계산하며 서로 대기. 세대·위치·네트워크 구조가 맞지 않으면 서로 대체 불가. (비유: 서울 빈방 100개가 서로 다른 호텔에 흩어져 있으면 단체 100명 예약 불가.) 메타의 프로메테우스 클러스터는 여러 건물의 수만 GPU를 BAG 네트워크(16~48Pbit)로 연결 → 네트워크가 GPU만큼 중요. 따라서 부족과 여유가 회사가 아니라 특정 시점·세대·용도 단위로 동시 발생.
05메모리 수요에의 함의
핵심 구분: AI 인프라 기업 실적은 이미 설치된 GPU의 가동 시간이 아니라, 앞으로 새 GPU·HBM을 얼마나 더 주문하느냐에 좌우. 이미 설치된 HBM은 많이 써도 추가 소비 부품이 아님. 최근 공급망 신호는 오히려 반대 — 메타의 칩·부품 장기 주문은 강해지고 HBM·LPDDR5·차세대 eSSD 등 프리미엄 메모리 채택이 증가. 즉 메타의 클라우드 확장은 "설비가 남아서"가 아니라 첨단 메모리 기반 포트폴리오 확장에 가까움.
06과잉 여부 판단 체크리스트
빅테크의 설비투자 전망 하향, 계약된 데이터센터·전력 프로젝트 취소, 최신 GPU 임대가·가동률 동반 하락, HBM 장기계약 축소 — 이들이 함께 나타나야 구조적 과잉을 말할 수 있음. 납기 단축만으로는 부족(공급 개선일 수도).
07용어 사전
| 용어 | 한줄 설명 |
|---|---|
| CapEx | 설비투자. 부품가 상승만으로도 증가할 수 있어 수요 증가와 구분 필요 |
| BAG(백본 집선망) | 여러 데이터센터 건물을 하나의 클러스터로 잇는 네트워크 계층 |
| MoE/여유 용량 | 내부 대규모 학습엔 부적합해도 외부 소형 작업엔 쓸 수 있는 용량 |